
jed351/Traditional-Chinese-Common-Crawl-Filtered
收藏官方服务:
资源简介:
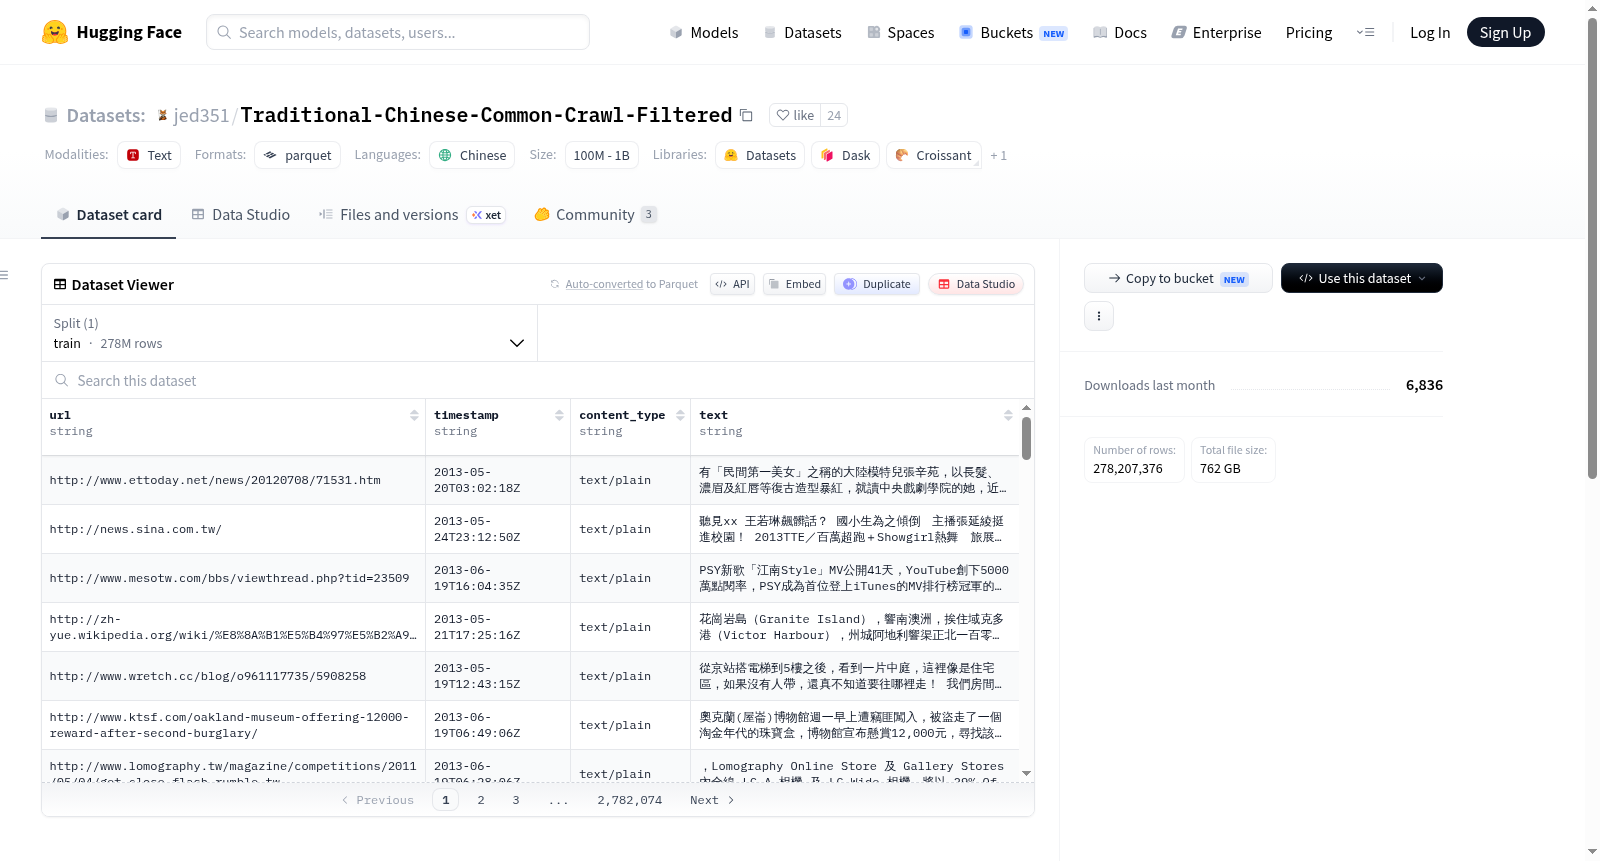
该数据集是从2023年14月的Common Crawl中获取的,经过处理后包含简体和繁体中文。通过一个修改过的简体中文字符列表进行过滤,最终得到了这个繁体中文数据集。
This dataset is sourced from the Common Crawl corpus of the 14th month of 2023. After undergoing preprocessing that retained both Simplified Chinese and Traditional Chinese content, the corpus was filtered using a modified list of Simplified Chinese characters, ultimately yielding this Traditional Chinese dataset.
提供机构:
jed351原始信息汇总
数据集概述
数据集名称
Traditional Chinese C4
数据来源
- 数据获取自2023-14 Common Crawl。
数据处理
- 数据下载和处理使用了基于另一个项目的代码,该项目尝试重现C4数据集。相关代码和项目链接如下:
数据集内容
- 原始数据集包含简体和繁体中文。
- 通过使用修改后的简体中文字符列表进行过滤,以获得繁体中文数据集。过滤列表链接:https://github.com/jedcheng/c4-dataset-script/blob/master/SC_filter/SC_list.txt
数据集下载
搜集汇总
数据集介绍
构建方式
在自然语言处理领域,高质量的中文语料库对于大语言模型的训练至关重要。Traditional-Chinese-Common-Crawl-Filtered数据集源自2013年至2025年间累积的Common Crawl海量网页数据,经定制化脚本处理,首先提取出包含简繁中文的原始语料。随后,基于一份经过改良的简体中文字符列表进行精细化过滤,精准筛除简体中文内容,从而保留并构建出纯粹的繁体中文文本集合。该流程参考了C4数据集的复现方法,确保了数据来源的广泛性与处理流程的规范性。
特点
该数据集的核心特色在于其专注性与规模性。作为目前公开可用的繁体中文语料库之一,它跨越了长达十二年的网络数据采集周期,覆盖了丰富多元的领域与话题,为语言模型提供了广袤的训练素材。数据经过过滤后,保留了高质量的繁体中文表达,有效避免了简繁混杂带来的语义偏差。尽管尚未完成全局去重,但其原始数据的多样性与时间跨度已构成显著优势,尤其适用于需要理解繁体中文语境与文化背景的模型训练任务。
使用方法
使用该数据集时,研究者可直接从HuggingFace平台加载,将其作为预训练或微调阶段的核心语料。鉴于数据尚未去重,建议用户根据具体任务需求,在预处理环节自行实施全局或局部去重操作,以优化模型训练效果。数据格式与标准C4数据集兼容,可便捷集成至主流深度学习框架如Transformers或Datasets库中。此外,该数据集特别适合用于繁体中文领域的文本生成、语言理解及跨领域知识迁移等研究场景。
背景与挑战
背景概述
在自然语言处理领域,高质量、大规模且语言纯净的预训练语料库是推动模型性能提升的关键基石。jed351/Traditional-Chinese-Common-Crawl-Filtered数据集由研究人员Jed Cheng及其合作机构(包括Eons Data Communications Limited、Votee AI以及九州大学和 Osaka大学的研究中心)于2025年前后创建,旨在从2013至2025年间的Common Crawl海量网络数据中,提取并精炼出专用于繁体中文的文本资源。该数据集通过基于C4数据集的复现脚本进行处理,并利用自定义的简体字过滤列表剔除了简体中文内容,从而聚焦于繁体中文的独特语言特征与文化表达。其核心研究问题在于解决繁体中文领域大规模、多样化、高质量训练数据匮乏的困境,为繁体中文语言模型、机器翻译及文化传承相关研究提供了宝贵的基础资源,对推动繁体中文信息处理技术发展具有重要影响力。
当前挑战
该数据集面临的核心挑战首先体现在领域问题层面:繁体中文网络内容在Common Crawl中占比相对较少,且常与简体中文、英文等其他语言混杂,如何精准识别并提取纯正繁体中文文本,同时保持语料的多样性与文化特异性,是构建高质量语言模型的基础难题。其次,在构建过程中,研究人员遭遇了显著的技术与资源挑战:海量Common Crawl数据的下载与处理需要庞大的计算与存储资源,尽管得到了多方赞助,但资金限制导致无法对所有数据转储进行去重处理,可能引入冗余信息,影响模型训练效率与泛化能力。此外,过滤算法的准确性依赖于精心设计的简体字字符列表,但部分繁体字与简体字存在一对多映射关系,过滤过程可能误删或漏删,增加了数据清洗的复杂性。
常用场景
经典使用场景
在自然语言处理领域,大规模高质量语料库是预训练语言模型的基础。Traditional-Chinese-Common-Crawl-Filtered数据集源自2013至2025年的Common Crawl快照,经过精心过滤,保留了繁体中文文本,为繁体中文自然语言处理研究提供了丰富的原始语料。其最经典的使用场景是作为预训练语料,用于训练诸如BERT、GPT等基于Transformer架构的繁体中文语言模型,支撑下游任务如文本分类、命名实体识别和情感分析。
衍生相关工作
该数据集衍生了一系列经典工作,包括对其前身Chinese-Common-Crawl-Filtered的进一步过滤与去重研究,以及基于此数据集训练的繁体中文BERT和GPT模型。研究者还利用该语料探索了繁简中文的跨域对齐任务,并开发了针对繁体中文的拼写校正和分词工具。此外,该数据集推动了Common Crawl处理管道的优化,如改进的字符过滤算法和高效去重策略,为其他低资源语言的大规模语料构建提供了可复现的范式。
数据集最近研究
最新研究方向
在自然语言处理领域,高质量繁体中文语料库的稀缺长期制约着相关模型的发展。jed351/Traditional-Chinese-Common-Crawl-Filtered数据集基于2013至2025年的Common Crawl快照,经过简繁字符过滤与清洗,构建了大规模、时序跨度长的繁体中文文本资源。这一工作直接回应了当前大语言模型对多地域、多文化语料的需求,尤其在台湾、香港及海外华语社区的语言技术应用中具有重要价值。数据集的发布为繁体中文预训练、方言适应及跨简体-繁体迁移学习提供了关键基础,其过滤流程也为后续构建高质量中文语料库提供了可复用的方法论参考。
以上内容由遇见数据集搜集并总结生成


