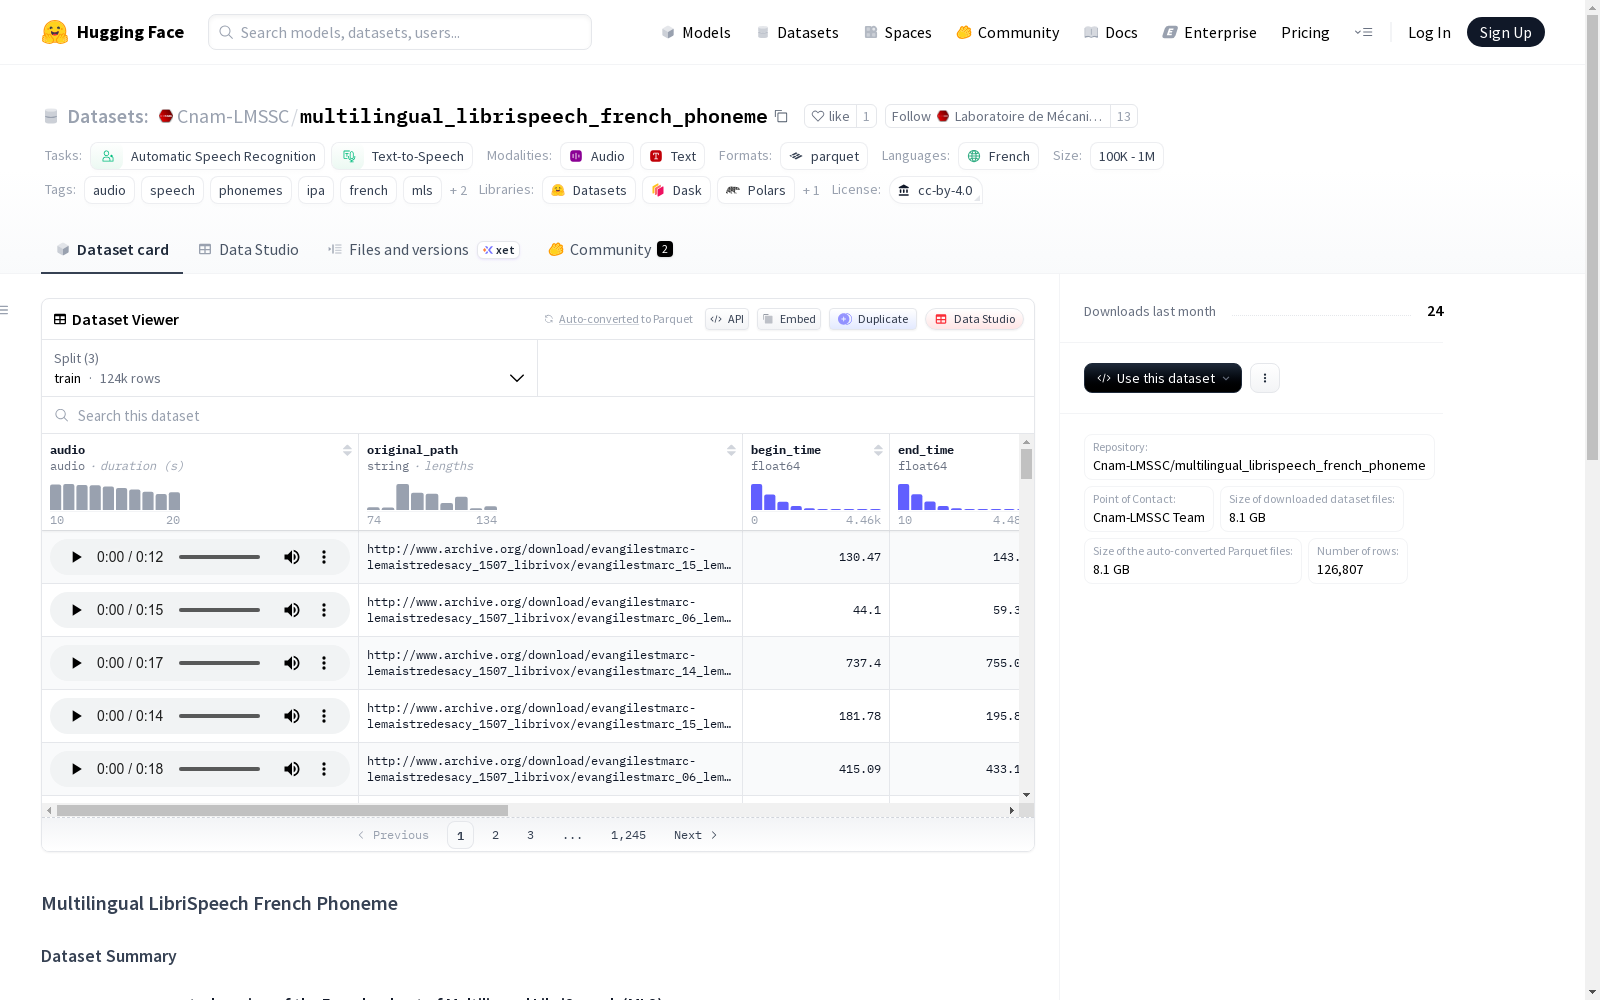
multilingual_librispeech_french_phoneme
收藏资源简介:
该数据集是Multilingual LibriSpeech(MLS)法语子集的精选版本,增加了音素转录列(`phoneme`)。由Cnam-LMSSC实验室创建,旨在促进法语声学建模、音素识别和语音合成的研究。它基于原始MLS数据集中来自LibriVox有声读物的高质量音频。数据集包含音频、说话者和章节元数据、原始文本以及生成的音素转录。支持的任务包括:音素识别(将音频特征直接映射到IPA音素)、自动语音识别(ASR)和文本转语音(TTS)。数据集语言为法语(`fr`)。
Multilingual LibriSpeech French Phoneme 数据集概述
数据集基本信息
- 数据集名称: Multilingual LibriSpeech French (Phonemized & Curated)
- 提供方: Cnam-LMSSC Team
- 许可证: cc-by-4.0
- 语言: 法语 (
fr) - 语言来源: 众包
- 标注来源: 机器生成
- 多语言性: 单语
- 规模类别: 1K<n<10K, 10K<n<100K
- 源数据集: facebook/multilingual_librispeech
数据集简介
该数据集是 Multilingual LibriSpeech (MLS) 法语子集的精选版本,并增加了一个音素转录列 (phoneme)。Laboratoire de Mécanique des Structures et des Systèmes Couplés (Cnam-LMSSC) 创建此版本旨在促进法语声学建模、音素识别和语音合成的研究。其基础是源自原始 MLS 数据集中 LibriVox 有声读物的高质量音频。
支持的任务
- 音素识别: 训练模型将音频特征直接映射到国际音标 (IPA) 音素。
- 自动语音识别: 利用有声读物数据进行鲁棒的语音到文本任务。
- 文本到语音合成: 利用 LibriSpeech 高质量、朗读语音的特性进行合成。
数据集结构
数据实例
一个典型的数据点包含音频、关于说话者和章节的元数据(源自 LibriVox)、原始文本以及生成的音素转录。 数据结构示例如下: python { id: 1234_5678_00001, audio: { path: 1234_5678_00001.flac, array: array([-0.012, 0.045, ...], dtype=float32), sampling_rate: 16000 }, text: "IL EST TEMPS DE PARTIR", phoneme: "i l ɛ t ɑ̃ d ə p a ʁ t i ʁ", speaker_id: 1234, chapter_id: 5678, }
标签
- audio
- speech
- phonemes
- ipa
- french
- mls
- librispeech
- cnam-lmssc
任务类别
- automatic-speech-recognition
- text-to-speech