遇见数据集

funes-swe-chat-zh-e5

收藏
Hugging Face2026-10-22 更新2026-10-23 收录
官方服务:

资源简介:

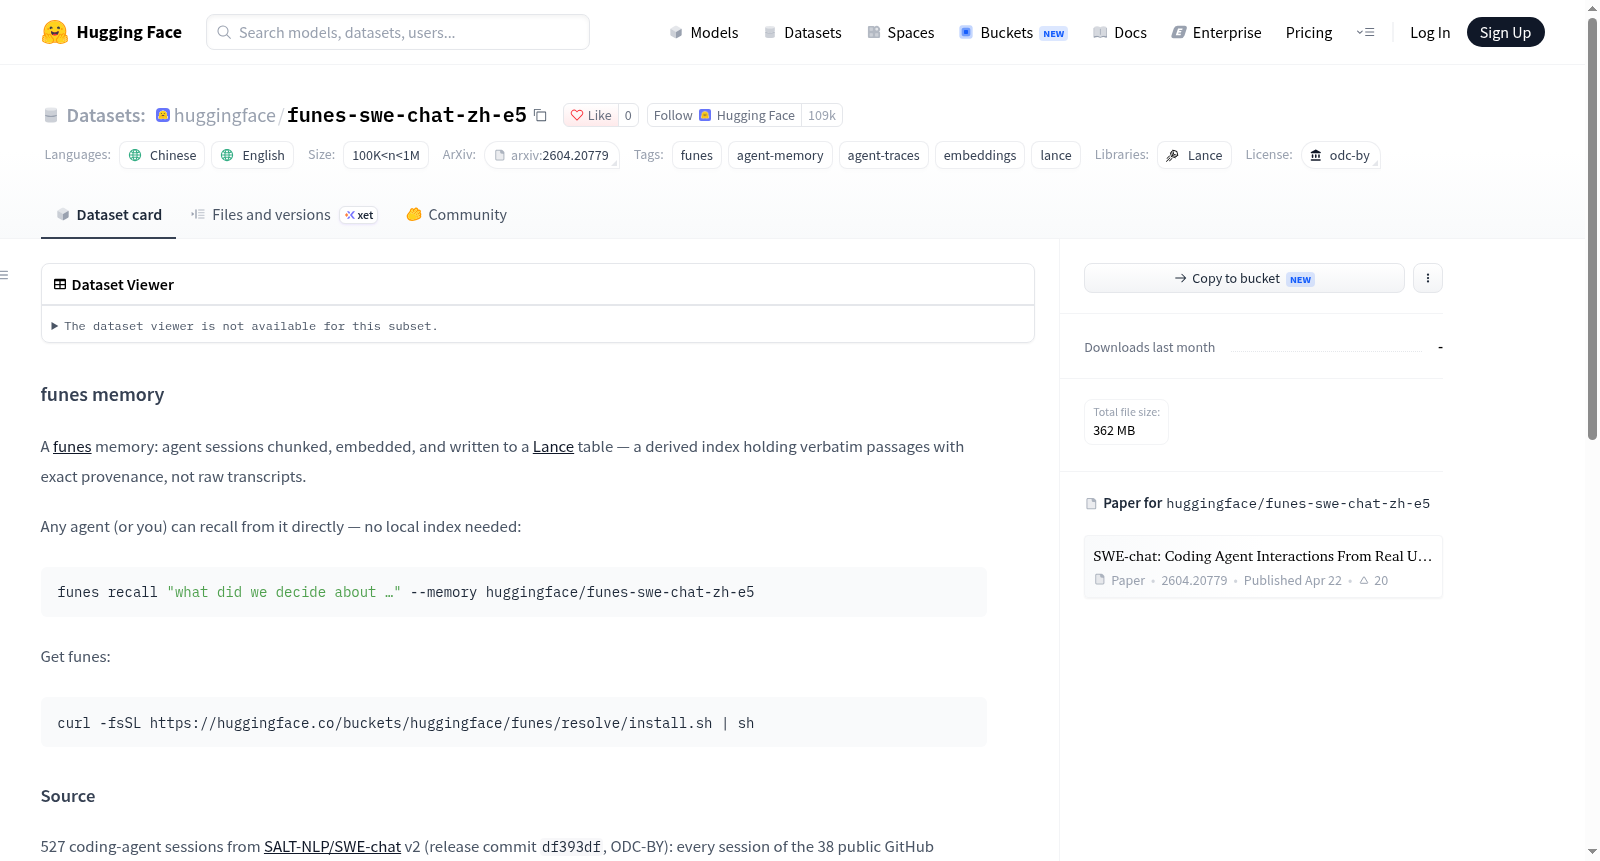
funes memory 是一个面向智能体(agent)记忆与召回的数据集/索引,基于 SALT-NLP/SWE-chat v2 构建。它将编码智能体会话分块、嵌入并写入 Lance 表,形成保存逐字片段及其精确来源的派生索引,而不是原始转写文本。任何智能体或用户都可以直接从中召回信息,无需在本地建立索引。数据源为 SWE-chat v2 发布提交 df393df(ODC-BY),包含 527 个编码智能体会话,覆盖 38 个公共 GitHub 仓库;这些仓库至少有一个会话的用户提示主要为中文。其中 318 个会话主要为中文,其余主要为英文,并涉及同一批项目。会话来自 Claude Code(319)、OpenCode(142)、Cursor(37)和 Codex(29),共包含 4,638 条用户提示,其中 2,584 条为中文。每个会话从源数据集的规范化 conversations 表转换为 funes turns 格式:一条 transcript 条目成为一个 turn,其行成为该 turn 的 blocks,包括提示、回复、思考、工具调用和工具结果;元数据行被排除,名为 unknown 且跨仓库 id 冲突的一个会话也被排除。OpenCode 会话如源数据一样带有工具调用但不包含其结果。数据使用 intfloat/multilingual-e5-small 进行嵌入,并带有 icu 文本索引,由 funes 1.9.0 生成。发布前,发布门禁发现包含秘密的块已被清洗(157,022 个中的 19 个)。数据集统计为 157,003 个 chunks,更新于 2026-10-22,并由 funes push 发布和保持更新。许可证为 ODC-BY,与源数据一致;使用时应引用 SWE-chat 论文 SWE-chat: Real-World AI Coding Sessions in the Wild,Baumann et al., COLM 2026(arXiv:2604.20779)。SWE-chat 仅包含允许再分发的仓库,这些会话中的代码仍遵循各自许可证。数据集语言为中文和英文,标签包括 funes、agent-memory、agent-traces、embeddings、lance,规模类别为 100K<n<1M。

提供机构:
Hugging Face
创建时间:
2026-10-22
原始信息汇总

funes memory

数据集概述

字段 内容
数据集名称 funes memory
详情页 https://huggingface.co/datasets/huggingface/funes-swe-chat-zh-e5
许可 ODC-BY
语言 zh、en
来源数据集 SALT-NLP/SWE-chat
标签 funes、agent-memory、agent-traces、embeddings、lance
规模类别 100K<n<1M

数据集内容

  • funes memory 是一个 funes 记忆:agent sessions 被分块、嵌入,并写入 Lance 表。
  • 它是派生索引,保存逐字片段及精确来源,不是原始会话记录。
  • 任意 agent 或用户可直接从中回忆,无需本地索引。
  • 回忆命令示例:

bash funes recall "what did we decide about …" --memory huggingface/funes-swe-chat-zh-e5

  • 获取 funes 的命令示例:

bash curl -fsSL https://huggingface.co/buckets/huggingface/funes/resolve/install.sh | sh

数据来源

  • 527 个 coding-agent sessions,来自 SALT-NLP/SWE-chat v2,release commit 为 df393df,许可为 ODC-BY。
  • 选取 38 个公共 GitHub 仓库中的每个 session,这些仓库至少包含一个用户提示主要为中文的 session。
  • 318 个 session 主要为中文,其余主要为英文,且位于相同项目。
  • 来源包括 Claude Code 319 个、OpenCode 142 个、Cursor 37 个、Codex 29 个。
  • 包含 4,638 条用户提示,其中 2,584 条为中文。

处理与格式

  • 每个 session 从数据集规范化 conversations 表转换为 funes 的 turns format。
  • 一个 transcript entry 变为一个 turn,其 rows 变为该 turn 的 blocks,包括 prompts、replies、thinking、tool calls 和 tool results。
  • Metadata rows 被排除。
  • 名为 unknown 的一个 session 被排除,因为其 id 在不同仓库间冲突。
  • OpenCode sessions 携带没有结果的 tool calls,与源数据一致。
  • 使用 intfloat/multilingual-e5-small 嵌入,使用 icu 文本索引,由 funes 1.9.0 完成。
  • 发布门发现秘密的 chunks 在发布前已被清除,共 19 个,总数为 157,022。

许可与引用

  • 许可:ODC-BY,与源相同。
  • 引用 SWE-chat:SWE-chat: Real-World AI Coding Sessions in the Wild,Baumann et al.,COLM 2026,https://arxiv.org/abs/2604.20779。
  • SWE-chat 仅包含许可允许再分发的仓库;这些 session 中的代码仍受其原始许可约束。

统计

指标 内容
Chunks 157,003
Embedding model intfloat/multilingual-e5-small
Updated 2026-10-22
  • 由 funes push 发布并保持更新。
搜集汇总
数据集介绍
funes-swe-chat-zh-e5 数据集图片
构建方式
面向智能体记忆与检索增强生成领域,该数据集以 SALT-NLP/SWE-chat v2(提交 df393df,ODC-BY)为源,纳入 38 个至少含一个中文为主用户提示会话的公共 GitHub 仓库全部会话,共 527 个编码智能体会话,其中 318 个以中文为主,其余英文为主且项目相同。构建时将规范化 conversations 表转为 funes turns 格式,转录条目成为 turn,行成为 blocks,涵盖提示、回复、思考、工具调用及结果;元数据行与 unknown 会话被排除,OpenCode 会话保留工具调用而无结果。最终以 intfloat/multilingual-e5-small 嵌入,经 funes 1.9.0 写入 Lance 表并建立 icu 文本索引,发布前清除含密钥块,形成保有精确来源的派生索引。
特点
在数据形态与治理层面,该内存数据集呈现大规模、双语、跨编码智能体来源与可追溯出处等特征。其 Lance 表含 157,003 个 chunk,规模处于 100K 至 1M 区间,采用 intfloat/multilingual-e5-small 生成嵌入并配置 icu 文本索引;会话来自 Claude Code 319 个、OpenCode 142 个、Cursor 37 个与 Codex 29 个,合计 4,638 条用户提示,其中 2,584 条为中文。数据集并非原始转录,而是保存逐字段落及精确来源的派生索引,便于检索时回溯。许可证沿用源数据的 ODC-BY,使用时需按 SWE-chat 要求引用 Baumann 等人在 COLM 2026 的工作。
使用方法
面向智能体运行时记忆调用与语义检索任务,该数据集可由任意智能体或用户直接召回,无需本地另行构建索引。典型调用为执行 funes recall "what did we decide about …" --memory huggingface/funes-swe-chat-zh-e5,以自然语言查询命中编码会话中的相关段落及来源。若未安装 funes,可通过 curl -fsSL https://huggingface.co/buckets/huggingface/funes/resolve/install.sh | sh 获取。该内存表由 funes push 发布并保持更新,适用于中英文编码智能体会话的长期记忆、上下文恢复与决策依据检索,也可作为检索增强生成流程的外部知识索引。
背景与挑战
背景概述
在软件工程智能体蓬勃发展的背景下,funes-swe-chat-zh-e5 由 Hugging Face funes 工具链发布维护,源自 SALT-NLP 的 SWE-chat v2(Baumann 等,COLM 2026),于 2026 年 10 月更新。该数据集收录 38 个公共 GitHub 仓库中的 527 段编码智能体会话,覆盖 Claude Code、OpenCode、Cursor 与 Codex,含 4,638 条用户提示,其中 2,584 条为中文。其核心研究问题在于为编码智能体构建可召回、可溯源的记忆索引:将规范化对话切分、嵌入并写入 Lance 表,以逐字段落保留精确出处,而非保存原始转录。该资源推动多语言智能体轨迹检索、记忆增强编码与可复现软件工程研究。
当前挑战
智能体记忆检索的领域难题在于长程对话的语义召回、跨会话与跨仓库归因、中英混合语境下的嵌入对齐,以及包含工具调用与思考块的非线性轨迹建模。构建该数据集时,需将 SWE-chat 的 conversations 表转换为 funes turns 格式,剔除元数据,排除跨仓库冲突的 unknown 会话,并处理 OpenCode 工具调用缺少结果的情况。发布前还须对 157,022 个分块进行秘密扫描,擦除 19 个含敏感信息分块;在 157,003 个最终分块上,以 intfloat/multilingual-e5-small 嵌入并建立 icu 文本索引,同时保持 ODC-BY 许可与来源署名,兼顾可检索性、隐私与合规性。
常用场景
经典使用场景
在智能体记忆与检索增强生成交汇的领域中,funes-swe-chat-zh-e5将真实编码代理会话切块、向量化并写入Lance表,形成可直接召回的派生索引。其经典场景是围绕“我们此前如何决定……”等自然语言查询,从Claude Code、OpenCode、Cursor与Codex产生的多轮轨迹中定位逐字段落,保留提示、回复、思考、工具调用与结果的精确来源。对以中文为主的仓库会话尤为适配,服务跨会话代码决策回忆与上下文续接。
衍生相关工作
从智能体记忆基础设施与真实编码会话语料两条脉络看,该数据集承接SWE-chat对野外AI编码会话的采集,并衍生出以funes为核心的记忆工作流:会话转turns格式、分块嵌入、Lance表存储与直接召回。围绕它形成的典型工作包括多语言e5嵌入在编码轨迹检索中的评测、基于Lance的列式向量索引实践、代理轨迹溯源与记忆压缩方法探索。SWE-chat论文及其公开数据发布也构成相关基准,推动后续研究比较不同代理的记忆与检索策略。
数据集最近研究
最新研究方向
伴随智能体长期记忆与可溯源检索跃升为编码代理研究的关键命题,funes-swe-chat-zh-e5 锚定多语言编程会话的记忆索引化与召回评估。其源出 SWE-chat v2 的 527 段真实编码代理会话,涵盖 Claude Code、OpenCode、Cursor 与 Codex,经 multilingual-e5-small 嵌入并写入 Lance 表,留存逐字段落与精确来源,支持免本地索引 recall。关联热点为 COLM 2026 收录的 SWE-chat 真实世界 AI 编码会话研究,以及代理轨迹、跨语言提示与工具调用分析。该资源为检索增强的智能体记忆、中英混合代码任务复现、隐私擦洗后发布与审计式溯源提供基础设施,推动可复现、可扩展的代理记忆探究。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务