
whrivt/saudi-gmaps-sentiment
收藏官方服务:
资源简介:
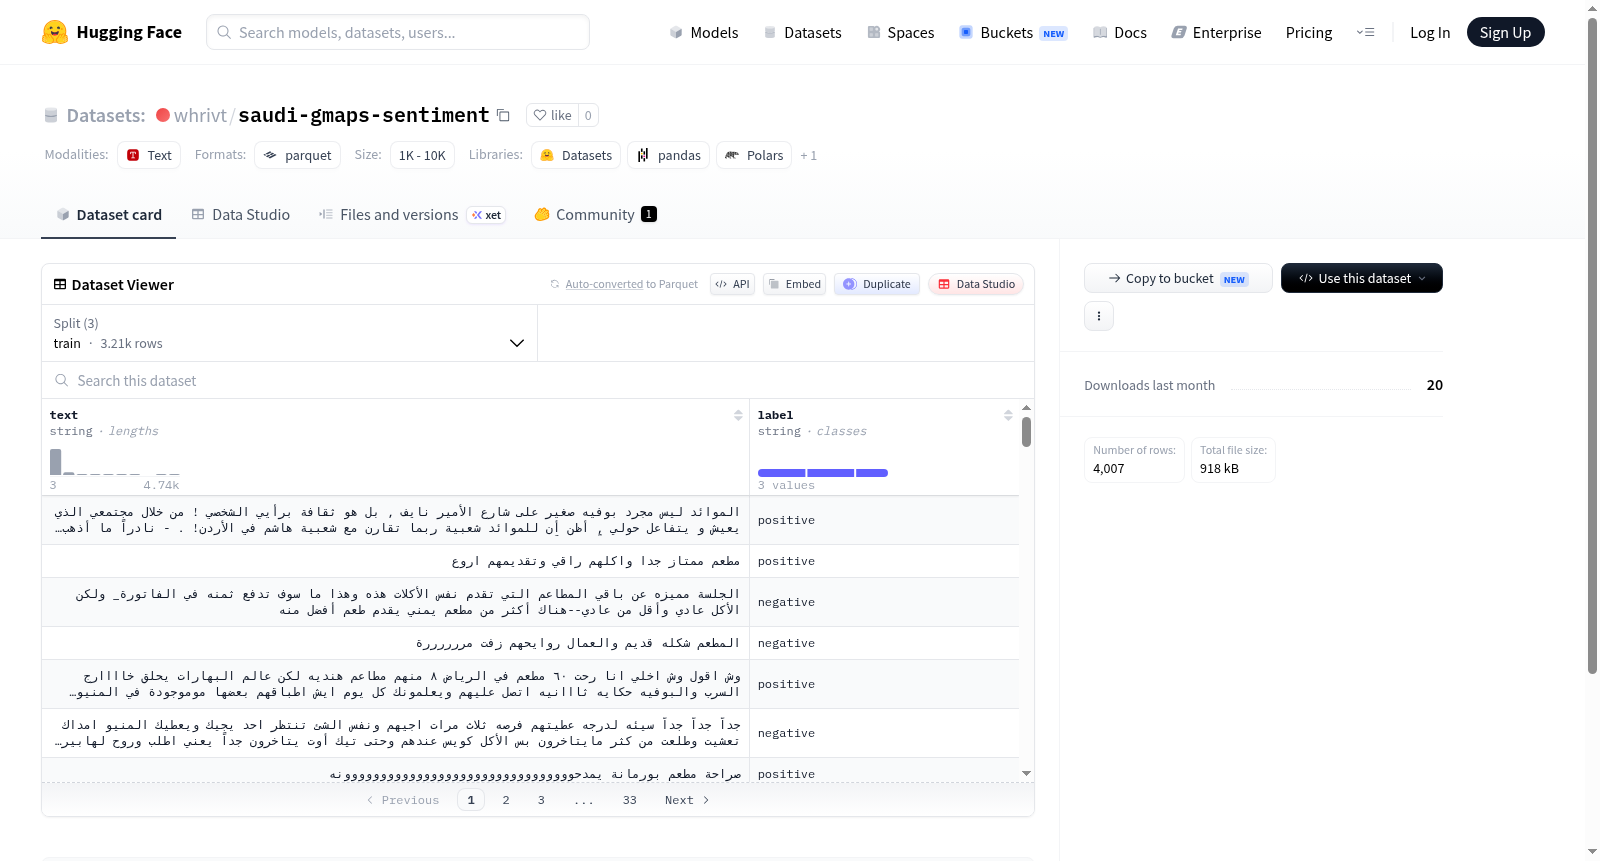
该数据集包含文本和标签两个特征,其中文本为字符串类型,标签也为字符串类型。数据集分为训练集、验证集和测试集三个部分:训练集包含3205个样本,大小约1385000字节;验证集包含401个样本,大小约139883字节;测试集包含401个样本,大小约195425字节。总下载大小为915089字节,数据集总大小为1720308字节。
This dataset includes two features: text and label, both of string type. It is divided into three splits: train, validation, and test. The train split contains 3205 examples with a size of approximately 1385000 bytes; the validation split contains 401 examples with a size of approximately 139883 bytes; the test split contains 401 examples with a size of approximately 195425 bytes. The total download size is 915089 bytes, and the total dataset size is 1720308 bytes.
提供机构:
whrivt搜集汇总
数据集介绍
构建方式
该数据集源自沙特阿拉伯地区Google Maps上的用户评论文本,经过系统化的情感标注流程构建而成。原始数据经过清洗与筛选,由标注人员依据评论文本的情感倾向赋予正面或负面标签,最终形成规模为4007条样本的数据集。数据被划分为训练集(3205条)、验证集(401条)与测试集(401条),以支持模型的训练、调优与性能评估。
使用方法
数据集可通过HuggingFace Datasets库加载,默认配置为'default',支持按split参数分别获取训练、验证与测试子集。用户可将数据集用于训练阿拉伯语情感分类模型,或在此基础上进行数据增强与迁移学习实验。数据以parquet格式存储,便于高效加载与预处理。
背景与挑战
背景概述
在自然语言处理与情感分析领域,针对特定地区、语言或文化背景的数据集构建一直是研究的热点与难点。沙特阿拉伯作为阿拉伯语世界的重要中心,其社交媒体与评价平台上的用户生成内容蕴含着丰富的地域情感信息。saudi-gmaps-sentiment数据集正是在此背景下于近年创建,主要聚焦于沙特阿拉伯地区的Google Maps用户评论文本,旨在为阿拉伯语情感分析提供高质量的标注数据。该数据集由来自沙特阿拉伯的研究机构或团队主导开发,包含超过4000条文本样本,涵盖积极、消极等情感标签,训练集、验证集与测试集分别为3205、401与401条。其核心研究问题在于如何捕捉沙特阿拉伯方言与标准阿拉伯语混合使用下的情感表达,从而推动阿拉伯语自然语言处理领域的发展,并为区域商业智能、公共服务监测等应用提供数据支撑,具有显著的学术与实践影响力。
当前挑战
该数据集所面临的挑战首先体现在所解决的领域问题上:沙特阿拉伯地区的阿拉伯语情感分析需要应对语言多样性、方言差异以及情感表达的隐蔽性。文化语境中的习语、俚语或宗教用语往往蕴含复杂情感,这对模型的泛化能力构成严峻考验。其次,在数据集构建过程中,数据收集与标注的挑战尤为突出。Google Maps评论的爬取需遵守平台政策与隐私规范,确保数据合规性。文本清洗与多方言的归一化处理,如将海湾方言、内志方言等统一为可分析格式,增加了预处理复杂度。标注者需具备深厚的语言文化背景以准确判断情感倾向,而标注一致性通过仅401条验证集和测试集得到控制,但样本规模有限可能影响模型在真实场景下的鲁棒性与可靠性。
常用场景
经典使用场景
在阿拉伯语自然语言处理领域,情感分析是一项基础而关键的任务,而针对沙特阿拉伯地区方言的情感标注数据尤为稀缺。该数据集汇集了来自沙特阿拉伯Google Maps用户评论的文本,涵盖了丰富的正面、负面与中性情感表达。研究者可基于这些标注数据,训练和评估针对阿拉伯方言的情感分类模型,探索文本预处理、词嵌入及深度学习架构在低资源语言情感任务中的适用性。该场景最为经典的应用在于构建能够捕捉阿拉伯语口语化表达与地域文化特征的情感识别系统。
解决学术问题
该数据集有效缓解了阿拉伯语方言资源稀缺所带来的学术瓶颈,填补了沙特阿拉伯地区用户生成内容情感标注数据的空白。它解决了跨方言情感模型泛化能力不足的问题,使得研究者能够系统性地比较现代标准阿拉伯语与方言在情感表达上的差异。此外,该数据集为探究评论长度、情感极性分布不均衡以及噪声文本对模型性能的影响提供了可靠的实验基础,推动了低资源语言情感分析方法的理论进步。其影响在于促进了对阿拉伯社交媒体文本的深入理解,并为多语言情感迁移学习研究提供了关键资源。
实际应用
在实际应用层面,该数据集支撑着多种商业与社会场景的需求。商家可利用基于此数据集训练的情感分析工具,自动监控Google Maps上用户对店铺、餐厅及服务地点的评价反馈,实时洞察消费者满意度变化,从而优化运营策略。政府部门亦能借助该技术进行公共舆情监测,识别特定区域的服务质量争议或突发事件中的情绪波动。在旅游领域,此类模型可为游客提供浓缩的评论情感摘要,辅助其出行决策,实现信息服务的人性化与智能化。
数据集最近研究
最新研究方向
基于沙特阿拉伯地区谷歌地图用户评论的情感分析数据集,当前正被广泛应用于阿拉伯语自然语言处理与地域性情感挖掘的前沿研究。该数据集聚焦于真实场景下的用户反馈,为多模态情感识别、低资源语言模型微调以及跨文化舆情分析提供了宝贵的标注资源。结合中东地区数字化转型与电商服务的迅猛发展,该数据集的引入使得研究者能够更精准地捕捉阿拉伯语口语化表达与情感倾向的微妙关联,推动情感分析技术在特定文化语境下的落地应用,对于智能客服、城市服务评价系统及社会媒体监控等热点领域具有重要的学术与实践价值。
以上内容由遇见数据集搜集并总结生成
相关数据集

暂无相关数据集


