
shreya-var/rupeeRoast-indian-transactions
收藏官方服务:
资源简介:
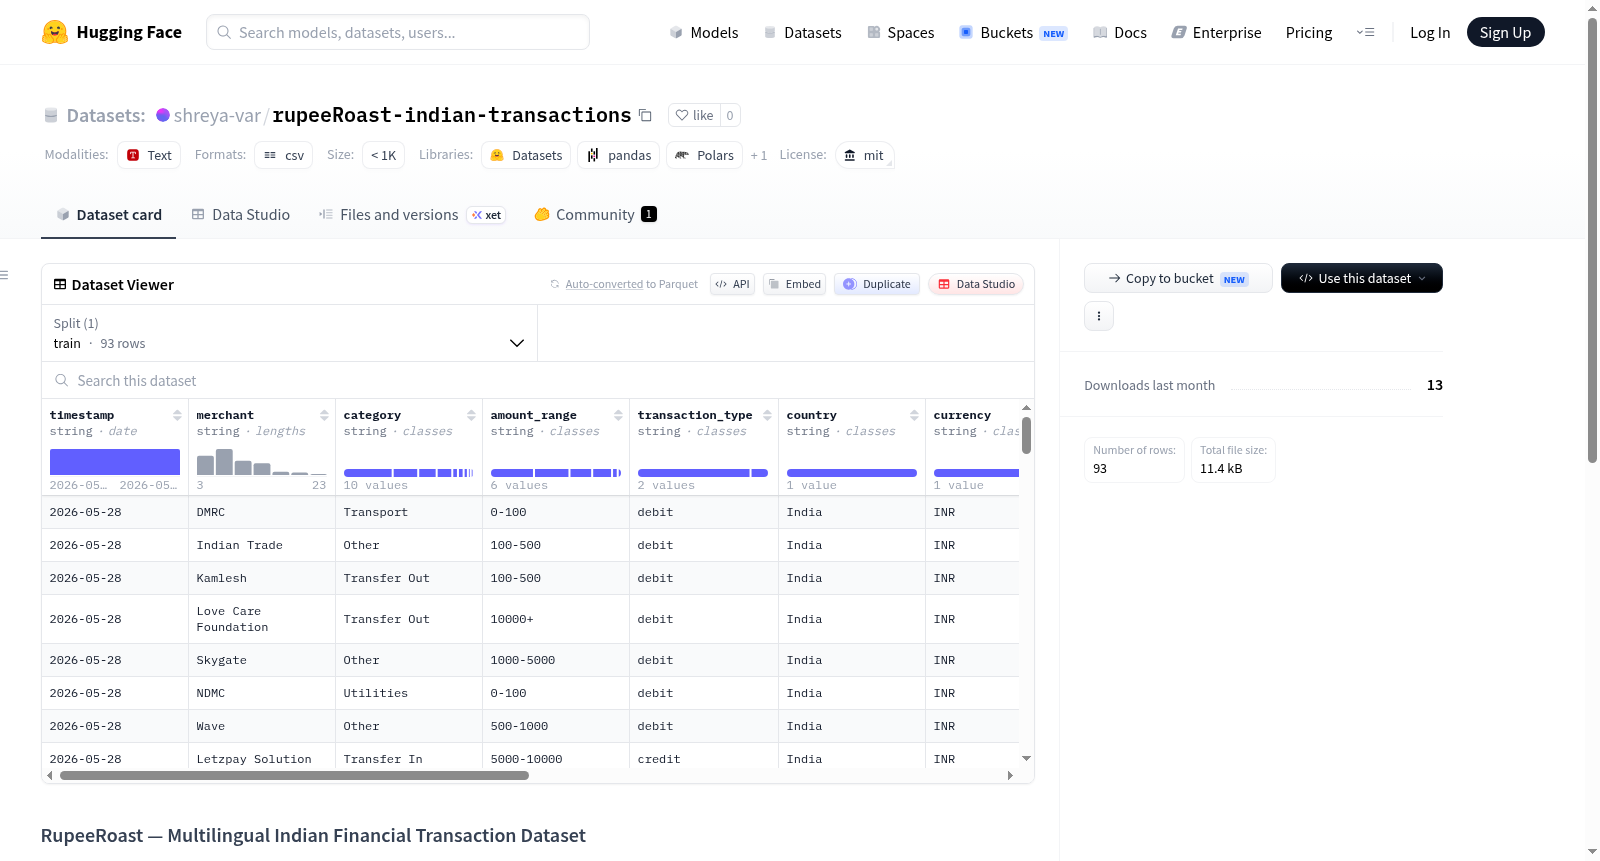
RupeeRoast是一个多语言印度金融交易数据集,包含分类的印度UPI/银行交易,并带有印地语和印度英语翻译,涵盖13个支出类别(如食品、交通、娱乐、购物、杂货、公用事业、医疗保健、投资、转入/转出、其他等)。数据集使用RupeeRoast AI Finance Coach、Adaptive Data by Adaption和Groq LLaMA 3.3构建,支持英语、印地语和印度英语三种语言。
RupeeRoast is a multilingual Indian financial transaction dataset with categorized Indian UPI/bank transactions and Hindi and Hinglish translations across 13 spending categories (e.g., Food, Transport, Entertainment, Shopping, Groceries, Utilities, Healthcare, Investment, Transfer In/Out, Other). It is built using RupeeRoast AI Finance Coach, Adaptive Data by Adaption, and Groq LLaMA 3.3, and supports English, Hindi, and Hinglish languages.
提供机构:
shreya-var搜集汇总
数据集介绍
构建方式
该数据集源自RupeeRoast AI金融教练与Adaption公司的自适应数据框架的深度融合,借助Groq LLaMA 3.3大语言模型的生成能力,对印度统一支付接口与银行交易记录进行系统化分类与多语言转化。构建过程覆盖餐饮、交通、娱乐、购物等13个支出类别,并针对每笔交易生成英语、印地语及印地英语混合三种语言版本的描述,形成了结构化的多语种金融交易语料库。
特点
数据集的核心特色在于其跨语言与跨文化适配性,同时涵盖印度日常消费中最具代表性的支出场景,类别划分细致且贴近实际使用场景。通过将金融交易与印地语、印地英语混合表达相结合,数据不仅服务于金融文本分析,还可用于多语言自然语言处理任务中的语义理解与生成,为研究非英语环境下的金融行为提供了稀缺的高质量标注资源。
使用方法
研究者可直接加载该数据集用于多语种交易分类、金融意图识别或跨语言信息抽取等下游任务。数据以标准格式存储,便于与常见机器学习框架集成。使用时可按语言字段筛选特定语种子集,也可将类别标签作为监督信号训练分类模型。此外,其混合语言特性适合用于测试与提升模型在代码切换文本场景下的鲁棒性与泛化能力。
背景与挑战
背景概述
RupeeRoost-indian-transactions数据集诞生于数字化支付与多语言金融数据交叉研究的前沿领域,由Adaption机构借助其Adaptive Data平台于近期创建,核心研究人员整合了RupeeRoast AI金融教练与Groq LLaMA 3.3模型的能力。该数据集聚焦于印度统一支付接口(UPI)及银行交易记录的自动化分类,涵盖食品、交通、娱乐等13个消费类别,并以英语、印地语和混合印地英语三种语言呈现。其发布填补了南亚多语言金融交易基准数据的空白,为跨语种财务分析、消费行为建模及普惠金融研究提供了关键资源,有望推动金融科技领域中NLP与交易分类系统的协同发展。
当前挑战
该数据集面对的首要挑战在于领域问题的复杂性:印度交易场景中混杂的印地英语(Hinglish)表达、非标准化交易描述以及UPI特有的模糊分类(如多类别重叠的“杂项”交易),使得基于传统规则的分类模型难以精准适配。构建过程中亦遭遇显著障碍,包括从非结构化银行通知中提取交易实体时面临噪声干扰,同时需人工校验跨语种翻译的语义等价性,尤其在饮食文化相关术语(如“dabba”与“午餐”的映射)中容易丢失本地化特征。此外,数据隐私法规要求移除敏感个人信息,进一步增加了标注成本与合规难度。
常用场景
经典使用场景
在金融科技与自然语言处理交叉领域,RupeeRoast数据集作为首个覆盖印度统一支付接口交易的精细语义资源,经典使用场景集中于多语言金融文本分类任务。研究者通过该数据集训练模型,能够有效区分食品、交通、娱乐、购物、医疗等13个消费类别,尤其针对英语、印地语及印地英语混杂的复杂语言环境,为跨语言金融文本理解提供了标准化基准。该数据集以真实交易记录为基础,充分捕捉了印度数字支付生态中的语言混杂现象,成为评估模型在非英语金融领域泛化能力的核心测试平台。
衍生相关工作
基于RupeeRoast数据集,学术界已衍生出多项具有影响力的研究工作。研究者利用其多语言特性,开发了面向印地语-英语代码混合文本的金融意图识别框架,显著优于单一语言模型。另有工作聚焦于小样本迁移学习,证明在该数据集上预训练的模型可迁移至斯里兰卡、孟加拉等南亚邻国的类似支付场景。此外,该数据集还催生了首个印度专用金融领域大语言模型的微调基准,推动语言模型在消费行为细粒度分析中的突破性应用。
数据集最近研究
最新研究方向
RupeeRoast印度金融交易数据集的问世,为多语言金融自然语言处理领域注入了新的活力。该数据集聚焦于印度特有的UPI支付生态与银行交易场景,融合英语、印地语及Hinglish三种语言,覆盖食品、交通、娱乐等13类高频消费类别,精准回应了印度数字支付爆发式增长下对细粒度分类数据的迫切需求。近期前沿研究正围绕该数据集展开跨语言交易意图识别与消费行为语义解析,探索其在欺诈检测、个性化财务规划及普惠金融分析中的潜在价值。RupeeRoast不仅填补了南亚地区金融标注数据的空白,更为构建适应语言混杂环境的AI理财助手奠定了坚实基础,其影响力随着印度移动支付市场的持续扩张而日益凸显。
以上内容由遇见数据集搜集并总结生成


