
遇见数据集

fhai50032/latentsig-med-triage-router

收藏
Hugging Face2026-05-30 更新2026-05-31 收录
官方服务:

资源简介:

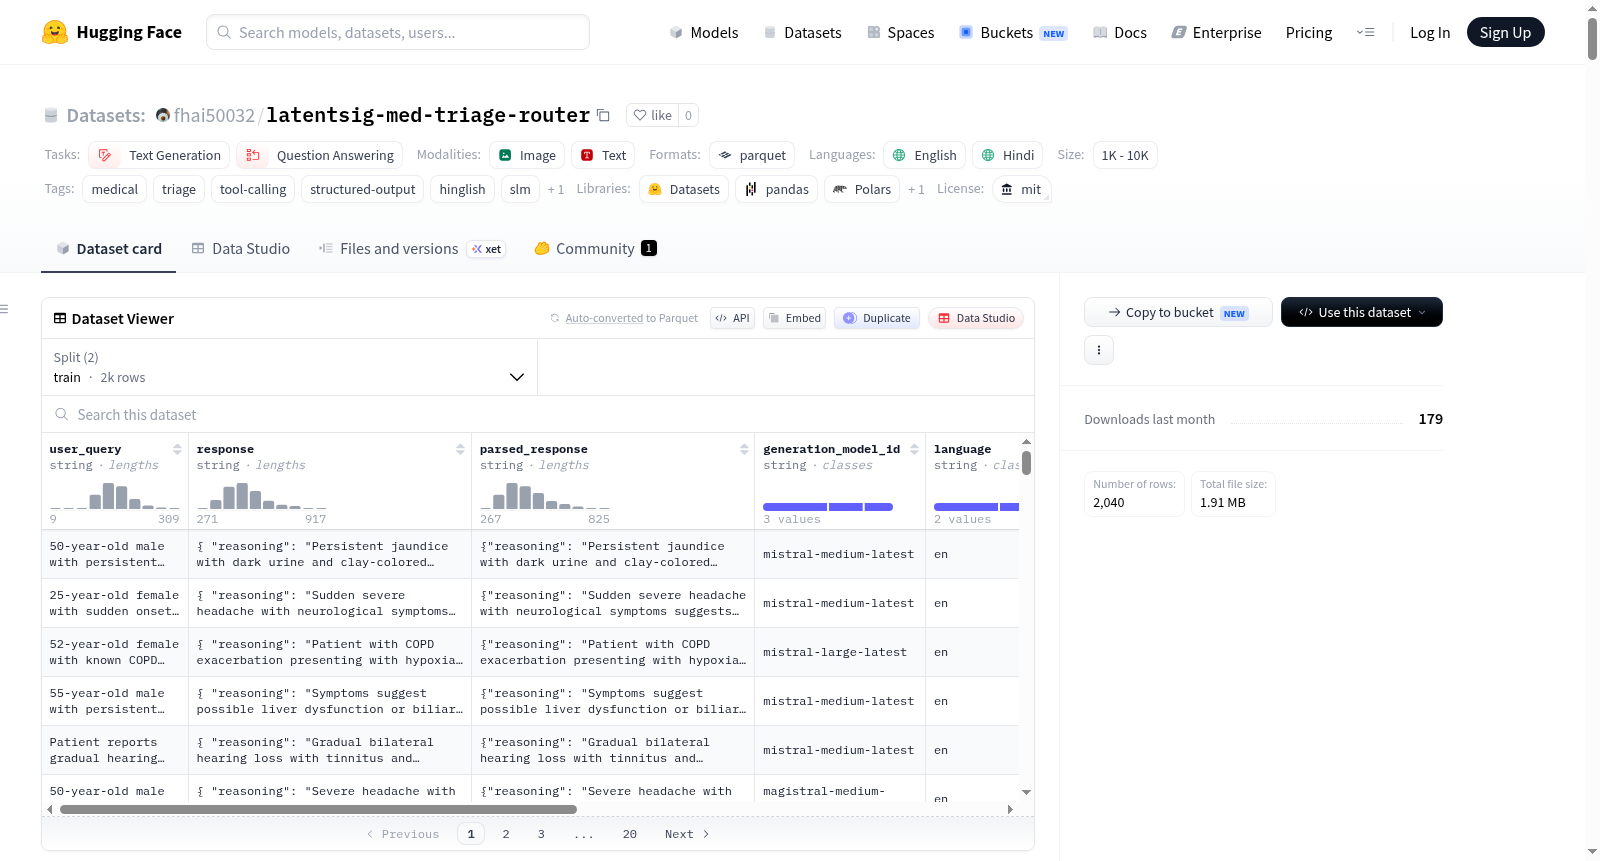
LatentSig医疗分诊路由器数据集是一个包含2000个经过验证的医疗分诊工具调用样本的数据集,其中1000个为英语样本,1000个为Hinglish(印地语和英语混合)样本,专门用于微调小型语言模型(SLMs)作为结构化医疗分诊路由器。该数据集旨在训练SLMs(1B-3B参数)成为可靠的临床医疗分诊结构化工具调用器。给定患者症状描述,模型必须:1. 从7个可用医疗工具中选择正确的工具;2. 输出带有正确参数的有效JSON工具调用;3. 分类紧急程度(急诊/紧急/半紧急/常规)。数据集设计原则是让模型学习跨工具泛化,而非记忆。每个样本都针对特定工具,确保覆盖整个医疗分诊领域。所有样本都经过三层验证流程(包括结构验证、语义检查和LLM法官评估)确保质量。数据集包含用户查询、响应、解析响应、工具调用、紧急类别、生成模型ID、语言、LLM法官ID、法官判决和哈希值等字段。

The LatentSig Medical Triage Router Dataset is a collection of 1,000 verified medical triage tool-call samples—500 English + 500 Hinglish—for fine-tuning Small Language Models (SLMs) as structured medical triage routers. This dataset trains SLMs (1B–3B parameters) to act as reliable structured tool-callers for clinical medical triage. Given a patient symptom description, the model must: 1. Select the correct tool from 7 available medical tools, 2. Output a valid JSON tool call with correct arguments, 3. Classify urgency (emergency / urgent / semi_urgent / routine). The key design principle is that the model learns to generalize across tools, not memorize. Each sample targets a specific tool, ensuring balanced coverage across the entire medical triage domain. All samples passed a 3-layer verification pipeline (including structural validation, semantic checks, and LLM judge evaluation) for quality assurance. The dataset includes fields such as user_query, response, parsed_response, tool_called, category, generation_model_id, language, llm_judge_id, judge_verdict, and hash.
提供机构:
fhai50032
搜集汇总
数据集介绍
fhai50032/latentsig-med-triage-router 数据集图片
构建方式
LatentSig Medical Triage Router 数据集的构建遵循了一套严谨而系统的流程,旨在为临床医疗分诊场景下的小型语言模型(SLM)提供高质量的结构化工具调用训练样本。该数据集的生成采用了多教师蒸馏策略,利用三种不同的Mistral模型生成原始样本,确保了训练数据的多样性。其核心设计原则在于实现工具层面的泛化能力,而非简单的记忆。为实现这一目标,构建过程中引入了工具平衡生成机制,通过加权随机采样优先使用频率较低的医疗工具,从而保证七个预定义医疗工具(如triage_assessment、emergency_dispatch等)在训练集中获得均等的表示。更关键的是,所有样本均需通过一个严格的三层验证管线:第一层使用Pydantic进行JSON结构与字段枚举的有效性校验;第二层通过模糊匹配与工具强制约束,确保目标工具与语义逻辑的一致性;第三层则引入独立的LLM裁判(mistral-small),在不获知目标工具的前提下,基于医学合理性对工具选择做出评判。最终,仅通过全部三层验证的去重样本被纳入数据集,构建出共计2000条、囊括英语与印地英混合语(Hinglish)的双语分诊语料库。
特点
该数据集最为突出的特质在于其高度的结构化与专业化设计,专为训练SLM成为可靠的医疗分诊路由器而生。样本涵盖7种核心医疗工具,分布高度均衡(各约286条),有效避免了模型对特定工具的偏好。在病情紧急程度分布上,数据集遵循真实分诊场景的规律,以紧急(44.2%)和急迫(35.6%)类病例为主,辅以半急症和常规病例,构建了层次分明的分类体系。语言方面,数据集巧妙融合了英语与印地英混合语,后者以罗马字母书写,保留了印地语的自然口语风格,同时混用英语医学术语,这使模型能够处理多语言混杂的临床主诉,平均查询长度分别为154与176字符。此外,每一条数据均包含丰富的元信息,如生成模型标识、验证裁判标识、SHA-256去重哈希以及裁判判决结果,为研究者提供了追溯样本生成与验证全链条的透明度。数据集中无任何重复样本,所有条目均以100%的通过率通过三层验证,展现了极高的数据纯净度与可靠性。
使用方法
该数据集适用于通过监督式微调(SFT)优化小型语言模型,以使其具备从患者症状描述出发,输出结构化JSON格式工具调用的能力。使用者通常采用Hugging Face的TRL库加载数据集与SFTTrainer,核心步骤包括将数据集中的system_prompt、user_query与response字段格式化为包含系统、用户与助理角色的多轮对话结构,再将其传入Qwen2.5-1.5B-Instruct等小型指令模型进行微调。为加速训练,亦可借助Unsloth库实现4位量化与LoRA高效微调。模型的输出必须严格遵循预定JSON架构,包含临床推理、紧急分类、目标科室、选用的工具名称及其参数键值对。值得注意的是,无论输入症状为英语或Hinglish,模型均以英语JSON格式输出,确保了输出的标准化与可解析性。该数据集明确声明仅用于科研原型开发,不得直接用于临床环境,且当前仅涵盖7种工具,实际生产系统需扩展至更多种类。
背景与挑战
背景概述
在临床分诊领域,快速准确地评估患者症状并匹配相应医疗资源是降低急诊拥堵和改善预后的关键环节。LatentSig Medical Triage Router数据集于2026年由LatentSig团队发布,旨在解决小语言模型在结构化医疗工具调用中的泛化难题。该数据集包含2,000条经过三层验证的高质量样本,涵盖英语与印地英语两种语言,每条样本均映射至七种医疗工具之一并标注紧急程度。通过平衡的工具分布与多教师生成策略,该数据集为训练1B-3B参数规模的小语言模型提供了可靠的监督信号,推动了轻量级模型在临床分诊场景中的结构化输出能力。其发布为低成本、高隐私的医疗AI原型验证开辟了新路径。
当前挑战
该数据集所应对的领域核心挑战在于:临床分诊系统需在资源受限环境下(如边缘设备)实现实时、可解释的决策支持,而传统大语言模型因高算力与隐私需求难以部署。小语言模型虽具优势,却普遍面临工具调用泛化弱、多语言症状理解不准确等问题。构建过程中,团队需解决合成数据与真实临床场景的语义鸿沟,通过三轮验证(结构化校验、模糊匹配与独立LLM裁判)确保工具选择与医学合理性。此外,印地英语中混合的印地语口语风格与英语医学术语增加了生成难度,需保持输出JSON格式的一致性。数据平衡策略(加权随机工具采样)和去重机制进一步增加了生成管线的复杂性。
常用场景
经典使用场景
LatentSig Medical Triage Router Dataset的核心用途在于对参数量在1B至3B之间的小语言模型(SLM)进行指令微调,使其能够胜任结构化的医疗分诊工具调用任务。具体而言,模型需要根据患者的主诉症状描述,从预定义的七项医疗工具(如急诊调度、分诊评估、精神健康筛查等)中精准选择并调用相应工具,同时以标准JSON格式输出包含临床推理、紧急程度分级(紧急、危急、半紧急和常规)、目标科室以及工具参数的完整结果。该数据集中英语与印地英语(Hinglish)样本各半,共计2000条经过严格三层验证的高质量问答对,为跨语言医疗场景下的工具泛化能力训练提供了坚实基础。
解决学术问题
在学术研究中,该数据集着力应对小语言模型在医疗领域中的结构化输出与工具调用泛化能力不足这一核心难题。传统大语言模型虽能实现复杂推理,但部署成本高且隐私风险大,而小模型常因参数量限制难以精准生成符合格式要求的多工具调用逻辑。该数据集通过均衡覆盖七种医疗工具并提供严格的分层验证机制(结构验证、语义匹配及独立医学评判),使模型学会在不同工具间灵活泛化而非机械记忆,从而有效提升了小模型在资源受限环境下执行临床分诊任务的可靠性。这一设计为研究小参数模型在医疗决策支持中的实用化路径提供了关键基准与数据支撑。
衍生相关工作
该数据集的推出为小语言模型在医疗工具调用领域的研究开创了若干衍生工作方向。围绕其核心理念,研究者可探索基于混合专家框架的多语言分诊路由模型,将英语与印地语以外的更多印度方言纳入训练,扩展工具库至五十项以上以适应真实生产环境。此外,将数据集的三层验证流水线抽象为通用评估范式,可衍生出医疗结构化输出的自动化质量监控基准。进一步地,结合检索增强生成(RAG)技术,该数据集亦可成为构建动态知识增强型分诊系统的起点,使小模型在调用工具时能够实时汲取最新临床指南,提升决策的时效性与准确性。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

