
electricsheepeurope/europe-ilo-ged-xlu4-sex-hht-geo-rt-prime-age-composite-rate-of-labour-underutilizatio
收藏数据链接:
官方服务:
资源简介:
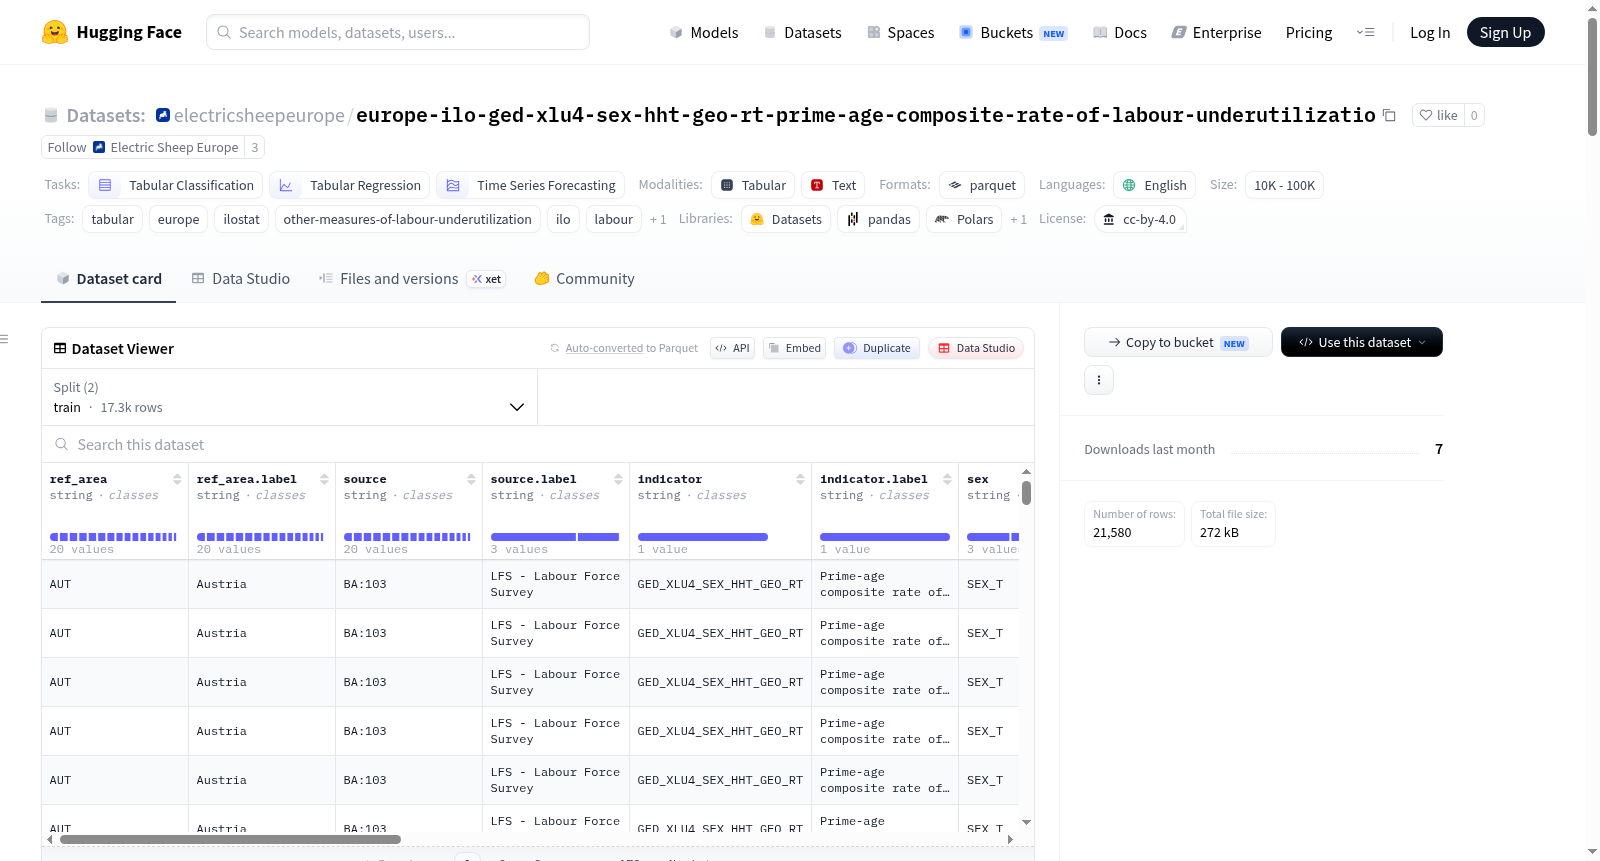
该数据集包含21,580个观测值,覆盖25个欧洲国家,时间跨度为2000年至2024年,涉及1个指标:Prime-age composite rate of labour underutilization (LU4) by sex, household type and rural / urban areas (%),即按性别、家庭类型和城乡地区划分的黄金年龄劳动力利用不足复合率(LU4)。数据来源于国际劳工组织(ILO)的ILOSTAT数据库,通过REST API提取并过滤到欧洲国家代码,主题为其他劳动力利用不足的衡量指标。数据集包含结构化列,如国家代码、指标、性别分类、年份、观测值等,适用于表格分类、回归和时间序列预测任务。
Prime-age composite rate of labour underutilization (LU4) by sex, household type and rural | Europe (ILOSTAT)
提供机构:
electricsheepeurope搜集汇总
数据集介绍
构建方式
该数据集基于国际劳工组织(ILO)的ILOSTAT数据库构建,通过REST API从指定指标端点(GED_XLU4_SEX_HHT_GEO_RT)直接拉取原始数据,并经过欧洲ISO3国家代码的过滤处理。ILOSTAT数据库整合了各国劳动力调查、家庭收入调查、企业调查和行政记录等多源微观数据,并依据国际劳工统计学家会议(ICLS)定义进行统一协调,确保跨时间和地域的可比性。数据集中的每个观测值均包含来源标签(source.label),以保障数据的可追溯性。最终数据由Electric Sheep Europe团队进行重新打包、标准化为Parquet格式,并发布在HuggingFace平台,便于机器学习和时间序列分析任务的直接调用。
特点
本数据集涵盖2000年至2024年间25个欧洲国家的21,580条观测记录,聚焦于壮年劳动年龄人口的劳动利用不足综合比率(LU4),并按照性别、家庭类型和城乡地域进行精细分层。数据集的独特之处在于其多维分类结构,包括性别(总、男、女)、家庭类型(如总家庭类型)和地域覆盖(国家层面),以及观测状态标记(如不可靠值)和来源注释等元数据字段。所有数据均为年度频率,并统一采用cc-by-4.0许可协议,为劳动经济学研究、国际比较和政策评估提供了高粒度、高质量且标准化的数据基础。
使用方法
用户可通过HuggingFace的datasets库以load_dataset()函数一行加载该数据集,并直接转换为Pandas DataFrame进行灵活操作。常用分析方法包括按国家代码筛选特定国家的子集(如德国),对特定指标按时间排序以绘制时序趋势图,以及利用数据透视表构建国家×年份的观测值矩阵。数据集中的分类列(如性别、家庭类型)可用于进一步的分组分析和统计建模。由于数据已标准化为表格格式,研究人员可直接将其应用于分类、回归或时间序列预测等机器学习任务,无需额外清洗步骤,显著降低了劳动统计数据分析的入門門檻。
背景与挑战
背景概述
该数据集由国际劳工组织(ILO)于2024年通过其ILOSTAT数据库发布,并由Electric Sheep Europe团队重新打包整理,聚焦欧洲25个国家2000至2024年间青壮年劳动利用不足综合率(LU4)的统计指标。作为全球劳动力统计的权威来源,ILOSTAT基于国际劳工统计学家会议(ICLS)定义对各国劳动力调查、家计调查等微观数据进行统一协调,提供了按性别、家庭类型和城乡地域分层的精细化数据。这一数据集的出现,为研究欧洲劳动力市场结构性失衡、非充分就业的时空演变以及社会经济不平等提供了标准化、可复现的量化基础,在劳动经济学、人口社会学与公共政策研究领域具有重要参考价值。
当前挑战
该数据集所应对的核心领域挑战在于,传统失业率指标(如ILO定义的失业率)往往低估了劳动力市场的真实闲置程度,尤其忽略了因经济原因减少工时、求职受挫退出劳动力市场等隐性就业不足现象,而LU4综合率通过纳入时间相关不充分就业、边缘劳动力等维度提供了更全面的度量框架。构建过程中面临的挑战包括:各国统计调查的问卷设计、抽样框架与数据发布频率差异显著,ILO需通过多源数据清洗与协调确保跨国可比性;部分观测值被标记为不可靠(obs_status字段含U标识),加之按性别、家庭类型等多维分类后样本量稀疏,对缺失值插补与统计推断模型提出严格要求。
常用场景
经典使用场景
在欧洲劳动力市场研究的浩瀚图景中,评估劳动利用不足的深度与广度一直是学术探求的核心议题。该数据集聚焦于25个欧洲国家2000至2024年间的主要劳动年龄人口综合劳动利用不足率(LU4),并依据性别、家庭类型及城乡地域进行精细分层。研究的经典范式通常包括利用面板数据模型构建多水平分析框架,以此捕捉劳动利用不足在不同社会群体间的异质性分布,揭示结构性失业与隐性就业不足的演化规律,为比较欧洲各国劳动力市场的韧性与脆弱性提供量化基石。
实际应用
在现实场景中,该数据集为国际组织与各国劳动部门制定精准化就业促进政策提供了决策锚点。通过剖析不同性别、家庭类型与城乡单元下的LU4差异,政策制定者能够识别出最亟需干预的脆弱群体,例如单身母亲或农村青年,从而设计靶向性技能培训与灵活雇佣方案。数据还赋能了区域经济发展战略的模拟推演,辅助智慧城市与乡村振兴规划中劳动力供需的动态匹配,提升公共资源的配置效率与包容性。
衍生相关工作
围绕这一核心指标,学术界已衍生出多项影响深远的研究脉络。一方面,后续工作利用该数据构建了劳动利用不足的贝叶斯动态预测模型,融入宏观景气周期变量,产出了对欧洲劳动力市场趋势的前瞻性分析。另一方面,学者们将其与收入不平等数据集或社会保护覆盖率数据联动分析,开展了关于劳动权益保障与福祉水平的多维关联研究。此外,该数据也被用于训练机器学习分类器,实现对国家间劳动利用不足模式的聚类与异常值检测,拓展了比较社会政策的量化边界。
以上内容由遇见数据集搜集并总结生成


