Duet Dataset (基于DAMP-VSEP)
收藏资源简介:
该数据集基于DAMP-VSEP构建,专为多歌手混合场景下的目标歌手提取任务设计。通过DNSMOS质量过滤和语音活动检测,从原始录音中提取干净歌声片段,并剔除噪音和干扰。为解决真实二重唱样本不足问题,将不同歌手录音配对并与背景音乐混合,生成约5.6万条合成二重唱训练样本,同时保留559条原始二重唱作为测试集。数据集旨在评估歌手知情分离方法在多歌手场景下的性能,提升目标歌手提取的准确性和感知质量。
This dataset is built upon DAMP-VSEP, and is specifically designed for the target singer extraction task in multi-singer mixed scenarios. Clean singing voice segments are extracted from original recordings via DNSMOS quality filtering and Voice Activity Detection (VAD), while noise and interference are removed. To address the shortage of real duet samples, recordings from different singers are paired and mixed with background music to generate approximately 56,000 synthetic duet training samples, while 559 original duet samples are reserved as the test set. This dataset aims to evaluate the performance of singer-informed source separation methods in multi-singer scenarios, and enhance the accuracy and perceptual quality of target singer extraction.
Singer-Informed Vocal Source Separation 数据集项目概述
项目简介
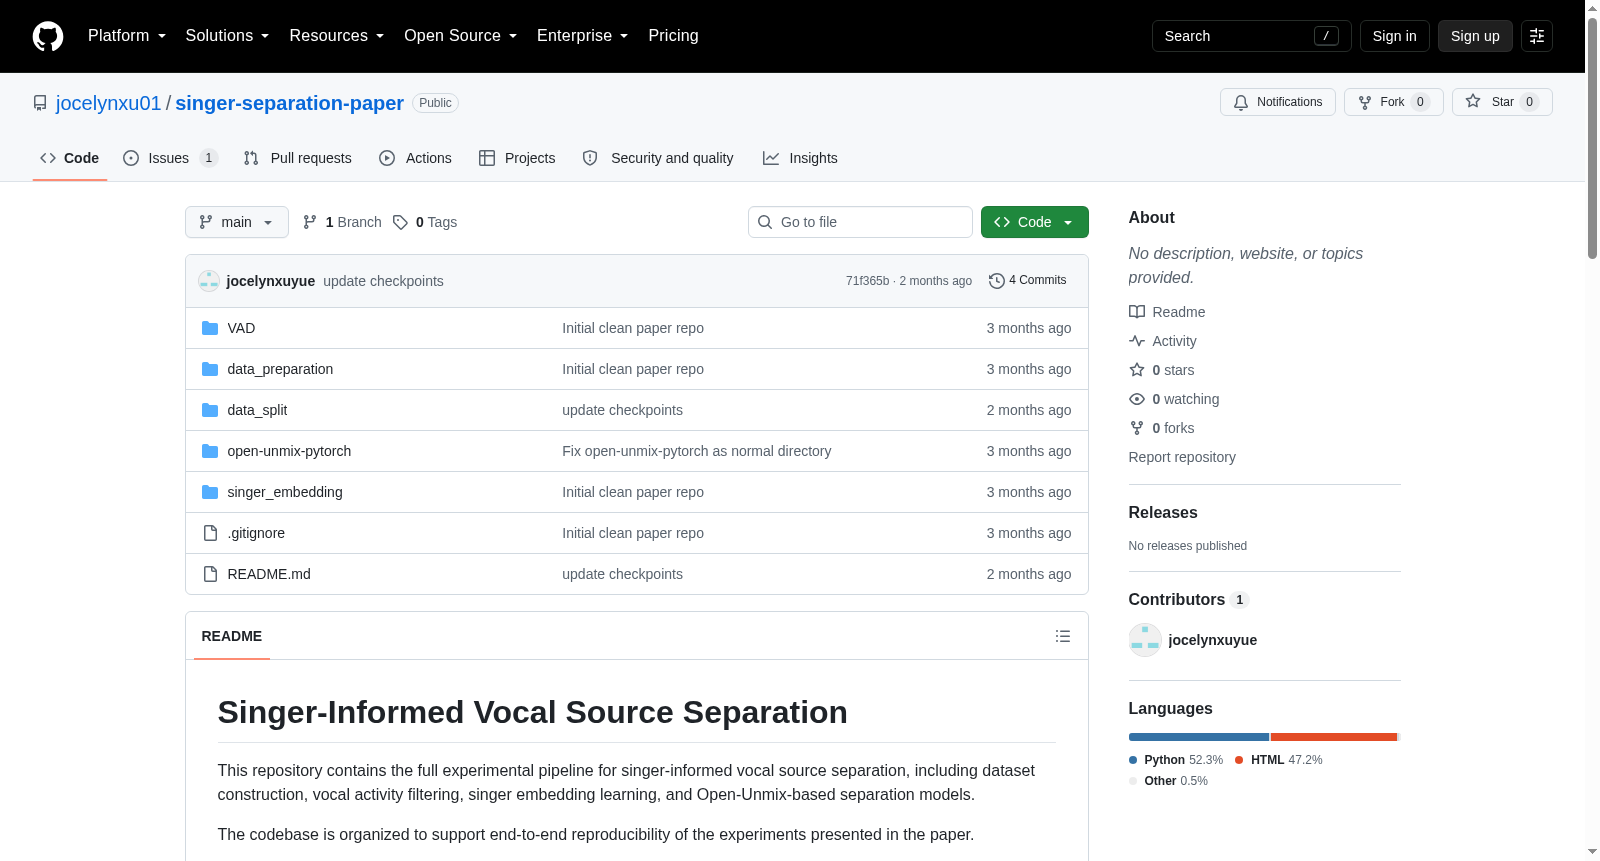
该项目是一个面向歌唱者感知的歌声源分离(Singer-Informed Vocal Source Separation)完整实验流程仓库,涵盖数据集构建、歌声活动过滤、歌唱者嵌入学习以及基于Open-Unmix的分离模型。
核心流程阶段
- 数据准备:从原始歌声录音构建独唱和合唱混合数据。
- 质量过滤与VAD:使用DNSMOS进行录音质量过滤,并基于能量的语音活动检测提取有效歌声片段。
- 歌唱者嵌入:训练歌唱者嵌入模型或使用预训练嵌入。
- 数据划分:将数据分为训练集、验证集和测试集。
- 嵌入预计算:预计算歌唱者嵌入,用于条件化分离模型。
- 分离模型训练与评估:训练歌唱者条件的Open-Unmix模型,或使用预训练检查点进行评估。
仓库结构
| 目录 | 功能 |
|---|---|
data_preparation/ |
数据集构建(独唱和合唱生成) |
VAD/ |
DNSMOS过滤与基于能量的VAD |
singer_embedding/ |
歌唱者嵌入模型及训练脚本 |
prepare_trainvalidtest_data/ |
数据集划分工具 |
open-unmix-pytorch/scripts |
修改后的Open-Unmix实现 |
预训练模型
歌唱者嵌入模型
- Clean Embedding:在高质量过滤数据上训练
- 下载链接:https://drive.google.com/file/d/1DTzLtKgtxBdwuOD5D4K8b9Ugj8PSN-EA/view?usp=drive_link
- Noisy Embedding:在未过滤数据上训练
- 下载链接:https://drive.google.com/file/d/1LXj0Af3beXb4sgcQL4iJ6QuitASixRiG/view?usp=drive_link
分离模型(Open-Unmix变体)
FiLM 条件化模型:
- FiLM(无 λ):https://drive.google.com/drive/folders/1jrpADqXGYaeFwhDy-35bcHKq5MUHaidy?usp=drive_link
- FiLM(λ=0.05):https://drive.google.com/drive/folders/18ZQs5OJDzcSDQviJdjKW45OxjJHtUTDo?usp=drive_link
- FiLM(λ=0.1):https://drive.google.com/drive/folders/1Ie_yzfhz0VCFS4GC136Rq3YXnqYPHD7_?usp=drive_link
- FiLM(λ=0.2):https://drive.google.com/drive/folders/1pzFy2GGWJNywCIIafwrj-tH8O7bBkG94?usp=drive_link
Concatenation 条件化模型:
- Concatenation(无 λ):https://drive.google.com/drive/folders/183kVl-I_jRTlwCZC9aG3cGQkDdzIwPsT?usp=drive_link
- Concatenation(λ=0.05):https://drive.google.com/drive/folders/1HnImboaTn7XREHJZ2fxHBnrrGY9Pf5EH?usp=drive_link
- Concatenation(λ=0.1):https://drive.google.com/drive/folders/1ovJF41lq71FhCwD44qRHkrAr_bX3_ki3?usp=drive_link
- Concatenation(λ=0.2):https://drive.google.com/drive/folders/1nQxKw8JM1teJa5ZS2WEw4oTFoAkes57F?usp=drive_link
技术特点
- 基于Open-Unmix的修改版本(原始实现:https://github.com/sigsep/open-unmix-pytorch)
- 新增歌唱者条件分离模型
- 支持Concatenation和FiLM两种条件化变体
- 提供SI-SDR训练脚本
- 包含嵌入预计算脚本