遇见数据集

bergson-smollm2-lds-chunks

收藏
Hugging Face2026-07-16 更新2026-07-17 收录
官方服务:

资源简介:

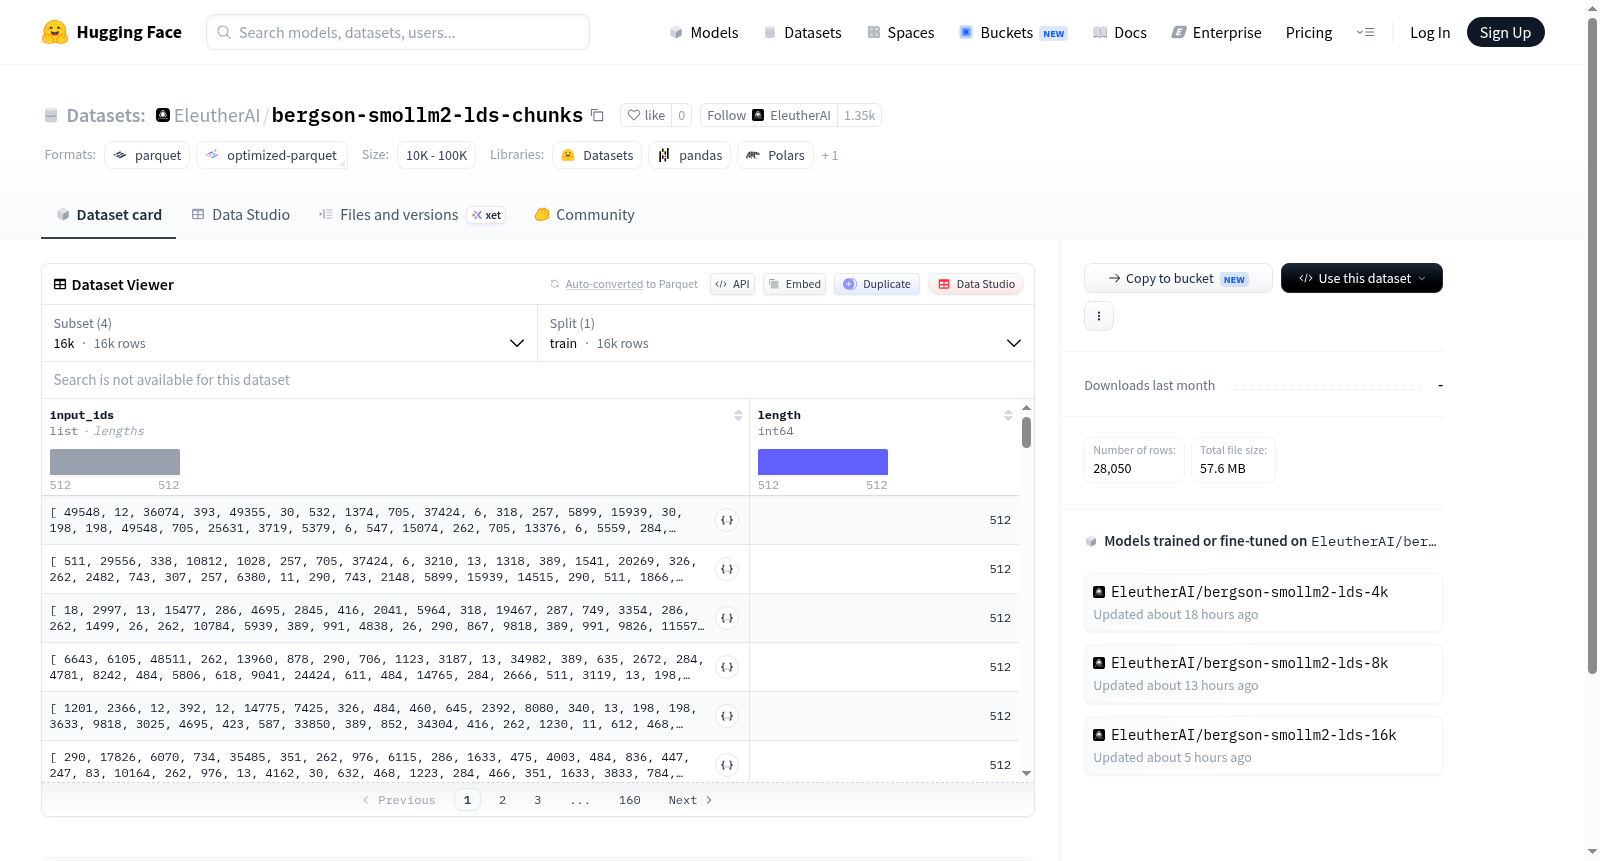
该数据集是一个文本或序列数据集,包含四个不同配置:16k、4k、8k和query。每个配置对应一个训练集,样本数量分别为16000、4000、8000和50。每个数据样本由两个特征组成:input_ids是一个int32类型的列表,用于存储序列的标记ID;length是一个int64类型的标量,表示序列的长度。数据集以结构化格式存储,适用于需要对序列数据进行建模、分析或预训练的任务,例如语言模型训练、序列长度分析或特定查询任务。

This dataset is a text or sequence dataset containing four different configurations: 16k, 4k, 8k, and query. Each configuration corresponds to a training set with sample counts of 16000, 4000, 8000, and 50, respectively. Each data sample consists of two features: input_ids is an int32 list used to store token IDs of the sequence, and length is an int64 scalar representing the length of the sequence. The dataset is stored in a structured format and is suitable for tasks that require modeling, analysis, or pre-training of sequence data, such as language model training, sequence length analysis, or specific query tasks.

提供机构:
EleutherAI
创建时间:
2026-07-16
原始信息汇总

数据集概述

该数据集名为 bergson-smollm2-lds-chunks,由 EleutherAI 提供,托管于 Hugging Face。数据集包含多个配置(config),每个配置对应不同规模的训练数据。

数据集配置

数据集包含以下五个配置:

配置名称 样本数量 下载大小 数据集大小
4k 4,000 8,215,619 字节 8,240,000 字节
8k 8,000 16,429,680 字节 16,480,000 字节
16k 16,000 32,858,009 字节 32,960,000 字节
32k 32,000 65,714,654 字节 65,920,000 字节
query 50 104,111 字节 103,000 字节

数据特征

每个配置下的数据都具有相同的特征:

  • input_ids: 类型为 list[int32],表示输入 token 的 ID 序列。
  • length: 类型为 int64,表示序列的长度。

数据划分

所有配置均仅包含一个数据划分(split):

  • train: 训练集。每个配置的 train 划分包含对应数量的样本。

数据文件

每个配置的数据文件存放在以配置名称命名的目录下,文件名模式为 train-*。例如,16k 配置的数据文件路径为 16k/train-*

搜集汇总
数据集介绍
bergson-smollm2-lds-chunks 数据集图片
构建方式
该数据集基于伯努瓦·德·斯宾诺莎的哲学著作《伦理学》,通过长度感知的文档分割策略(Length-Dependent Segmentation, LDS)进行精细化切分。原始文本被划分为不同粒度的块,分别形成配置名为4k、8k和16k的数据子集,其中数量标识符对应序列的最大标记数。此外,还特别构建了一个名为query的微型子集,包含50个样本,专为检索实验设计。数据以预训练常用格式存储,每个样本包含输入ID序列及其对应的序列长度。
特点
数据集最显著的特征在于其多粒度结构,提供了4k、8k和16k三种不同长度的序列切分,分别包含4000、8000和16000个训练样本。这种层次化的设计允许研究者灵活选择匹配下游任务需求的上下文窗口大小。query子集虽然规模极小,却专为快速验证检索增强生成(RAG)系统的检索性能而设计,体现了在哲学文本分析场景中的实用导向。
使用方法
使用该数据集时,可从HuggingFace直接加载各配置:'16k'、'8k'、'4k'或'query'。每个配置仅包含训练集切分,适合直接用于语言模型的预训练或微调。加载后的数据以字典形式呈现,键'input_ids'存储标记化后的整数序列,'length'记录实际长度。开发者可依据目标模型的最大标记容纳范围选择对应配置,若进行检索任务评估,则专门调用query子集作为查询集合。
背景与挑战
背景概述
该数据集名为bergson-smollm2-lds-chunks,源自巴西圣保罗大学的研究团队,是在大型语言模型(LLM)压缩与高效推理领域(如SMoLLM2项目)背景下创建的。数据集聚焦于解决大规模语言模型在资源受限环境下的部署问题,通过将文本数据切割为不同长度的块(chunk),支持模型在长依赖关系学习与计算效率之间取得平衡。核心研究问题在于如何优化序列长度与模型容量之间的权衡,从而提升轻量级语言模型在下游任务中的性能。该数据集提供了16k、8k、4k及query等多种配置,为研究者提供了灵活的实验基准,对推动高效语言模型的发展具有参考价值。
当前挑战
数据集所应对的领域挑战包括:大规模语言模型在处理长序列时面临的计算开销与内存瓶颈,尤其是训练与推理阶段对硬件资源的过度依赖;而构建过程中的挑战则涉及如何合理切割文本块以保持语义连贯性,同时避免因固定长度截断导致的关键信息丢失。此外,多个配置下的数据规模(如16k样本仅包含3296万字节)要求模型在有限数据中高效学习,这对稀疏性与正则化策略提出了更高要求。query配置的极小规模(仅50例)进一步考验模型在零样本或少样本场景下的泛化能力,这在现实应用中极具挑战性。
常用场景
经典使用场景
在自然语言处理与信息检索的交汇领域,该数据集主要服务于长文本语义理解与密集检索任务。其精心配置的16k、8k、4k及query子集,分别对应于不同长度的文本块和查询样本,为训练和评估长文档的嵌入模型提供了标准化的数据基础。研究者常利用此数据集对基于Transformer架构的密集检索器进行微调,以提升模型在海量长文本中精准捕获语义关联的能力。
衍生相关工作
基于该数据集的结构特点,衍生了众多关于长文档分段与表示学习的经典工作。这些工作探索了不同分块粒度对下游检索性能的影响,例如对比固定长度分块与基于语义边界的动态分块策略。此外,该数据集常被作为基准,用于评估结合稀疏与密集检索的混合模型,或是验证针对长序列进行高效微调的方法,如利用注意力池化或滑动窗口技术来优化计算与存储效率。
数据集最近研究
最新研究方向
在轻量化语言模型与知识蒸馏的交叉领域,bergson-smollm2-lds-chunks数据集凭借其多粒度分块设计(包含4k、8k、16k等不同长度配置)与查询集构建,为小参数模型的预训练与下游任务适配提供了精细化的数据支撑。该数据集聚焦于前沿的低资源场景下高效微调技术,如LoRA与混合精度蒸馏,其分层结构使得研究者能够针对不同计算预算与语义粒度需求,灵活研究模型在长上下文理解、压缩推理及迁移学习中的表现。特别是在边缘计算与实时交互系统亟需小型化模型的热潮中,该数据集的出现为探索模型规模与语料复杂度之间的最优平衡点开辟了新路径,对推动绿色人工智能与私有化部署的落地具有显著意义。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务