
遇见数据集

neomatrix369/reverse-text-gpt-5-4-nano-rollouts

收藏
Hugging Face2026-05-30 更新2026-05-31 收录
官方服务:

资源简介:

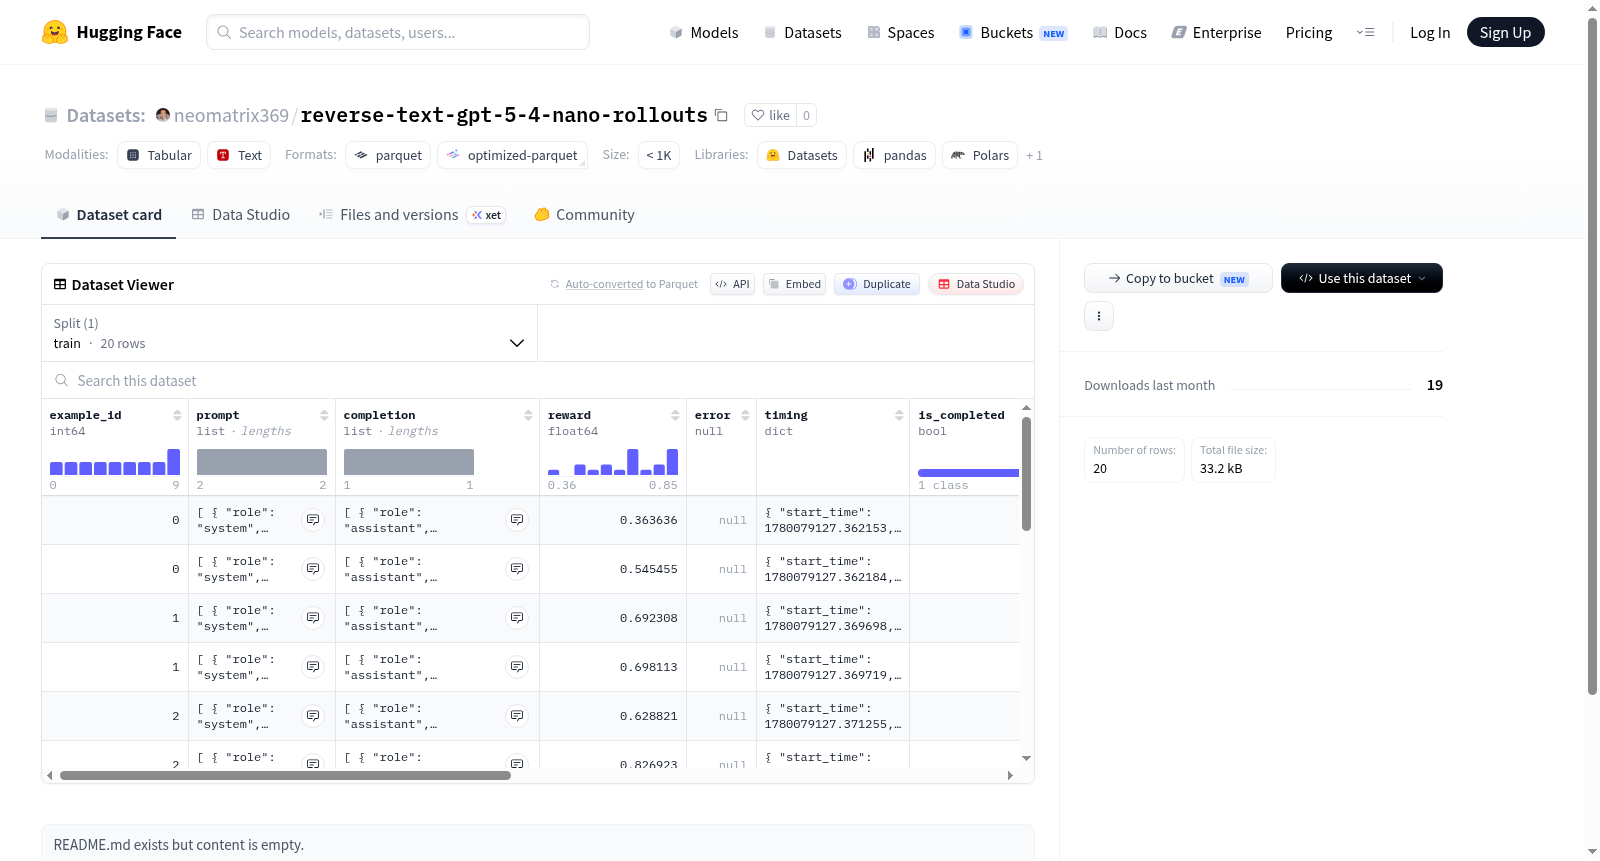
该数据集包含20个训练示例,用于对话或文本生成任务,可能涉及强化学习或模型评估。每个示例包括唯一标识符(example_id)、提示信息(prompt,包含角色和内容字段)、完成信息(completion,结构类似)、奖励分数(reward)、错误信息(error,可能为空)、详细时间记录(timing,涵盖设置、生成、评分等阶段的时间戳和持续时间)、完成状态(is_completed)、截断状态(is_truncated)、停止条件(stop_condition)、评估指标(metrics,如lcs_reward和num_turns)、工具定义(tool_defs,可能为空)以及令牌使用统计(token_usage,包括输入和输出令牌数)。数据集还包含lcs_reward和num_turns的单独字段,可能用于进一步分析。总体而言,该数据集旨在支持模型训练、性能评估和优化,特别关注时间效率和生成质量。

This dataset contains 20 training examples for dialogue or text generation tasks, likely involving reinforcement learning or model evaluation. Each example includes a unique identifier (example_id), prompt information (prompt with role and content fields), completion information (completion with a similar structure), reward score (reward), error information (error, possibly null), detailed timing records (timing covering timestamps and durations for setup, generation, scoring, etc.), completion status (is_completed), truncation status (is_truncated), stop condition (stop_condition), evaluation metrics (metrics such as lcs_reward and num_turns), tool definitions (tool_defs, possibly null), and token usage statistics (token_usage including input and output token counts). The dataset also includes separate fields for lcs_reward and num_turns, potentially for further analysis. Overall, the dataset is designed to support model training, performance evaluation, and optimization, with a focus on temporal efficiency and generation quality.
提供机构:
neomatrix369
搜集汇总
数据集介绍
neomatrix369/reverse-text-gpt-5-4-nano-rollouts 数据集图片
构建方式
该数据集基于强化学习框架中的策略回滚机制构建,利用GPT-5-4-Nano模型在特定环境中进行多轮交互采样。每个样本包含一个唯一的示例标识符、多轮对话历史、模型生成的补全内容以及对应的奖励值。构建过程中详细记录了每个时间步的时序信息,包括上下文设置、生成、评分及环境交互的起止时间与耗时,旨在为偏好学习与奖励建模提供细粒度的行为数据。数据集共包含20个训练样本,形成一个专注于小型、高质量轨迹的微调基准。
特点
数据集的核心特点在于其结构化与多模态时序信息的深度融合。每个样本不仅承载完整的对话轮次与奖励信号,还附带精密的时间戳分层结构,能够精确反映模型在生成、评分与环境交互中的实时性能。同时提供了LCS(最长公共子序列)奖励与轮次数作为评估指标,支持对模型推理效率与任务完成度的双重分析。此外,数据集中包含令牌使用统计(输入、输出及最终轮次令牌数),为计算资源优化与行为策略研究提供了量化依据。
使用方法
该数据集适用于通过监督微调或强化学习优化语言模型的对话策略。用户可加载默认配置下的训练分割,利用'prompt'与'completion'字段构建输入输出对进行序列到序列学习,或使用'reward'字段进行偏好排序训练。时间戳信息可用于分析模型行为的时间分布,辅助调试生成延迟与性能瓶颈。建议配合支持多轮对话结构的训练框架使用,并可根据任务需求忽略工具定义等空字段,聚焦于核心对话与奖励建模。
背景与挑战
背景概述
在大型语言模型(LLM)的快速发展中,如何通过强化学习从人类反馈(RLHF)来优化模型的对齐能力,已成为一项核心研究挑战。reverse-text-gpt-5-4-nano-rollouts数据集正是在这一背景下由相关研究机构构建,旨在探索一种新颖的逆向文本生成任务,作为评估和训练模型推理与自纠错能力的基准。该数据集创建于近期,核心研究问题是通过设计需反向推理的文本任务,检验GPT系列模型(如GPT-5)在复杂指令遵循与多轮交互中的表现。其影响力在于为RLHF中的奖励模型训练、策略优化及探索逆向逻辑任务提供了标准化测试环境,推动了语言模型在非直接生成场景下的适应性与鲁棒性研究。
当前挑战
该数据集所解决的领域问题核心在于,传统文本生成任务多聚焦于正向序列输出,而逆向文本生成需要模型具备逆向思维与精确的指令重构能力,这对其推理与自纠错机制提出了更高要求。构建过程中,主要挑战包括:设计具有明确逆向逻辑且不引入歧义的prompt,需确保模型能理解反转顺序或语义重组的要求;在多轮交互中记录完整的时序与奖励信息,以捕捉模型在不同阶段的策略变化;收集包含lcs_reward等细粒度指标的评估反馈,用于准确衡量模型在逆向任务中的表现优劣。这些挑战共同考验了数据集在复杂任务定义、细粒度性能测量与多样化交互建模方面的构建能力。
常用场景
经典使用场景
在自然语言处理与强化学习交织的研究前沿,reverse-text-gpt-5-4-nano-rollouts数据集承载着对反转文本生成任务的精细探索。其经典使用场景聚焦于评估和优化语言模型在执行逆序生成指令时的表现,例如将一句完整的正向语句转换为字符或词汇顺序完全颠倒的输出。研究者通常利用该数据集构建从prompt到completion的映射,通过奖励信号(reward)与最长公共子序列奖励(lcs_reward)等指标,量化模型在规范性约束下的生成质量。这一场景为动态测试模型对明确规则的理解能力提供了基准。
衍生相关工作
围绕reverse-text-gpt-5-4-nano-rollouts数据集衍生了一系列经典工作,主要包括基于逆序任务设计的偏好优化算法与过程监督策略。研究者借鉴其奖励标注结构,开发了用于修正序列生成误差的细粒度学习框架,并探索通过引入最长公共子序列指标来引导模型在逐级反转中保持完整性。此外,该数据集催生了针对小型语言模型在约束环境下效率评估的基准体系,促使后续工作将反转测试作为检验模型对称性推理能力的标准环节,深刻影响了指令微调的实验设计规范。
数据集最近研究
最新研究方向
该数据集聚焦于通过逆向文本生成与奖励信号对齐技术,探索大规模语言模型在细粒度指令微调与强化学习中的前沿应用。当前研究热点包括利用提示-完成对结构模拟真实对话场景,结合时序性能指标与复合奖励函数(如LCS奖励)优化模型决策过程,并分析生成阶段的延迟与误差来源。这一方向紧密关联语言模型的可信度与效率提升,尤其在多轮交互任务中平衡响应质量与计算开销,为构建更稳健的智能对话系统提供了实证基础。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

