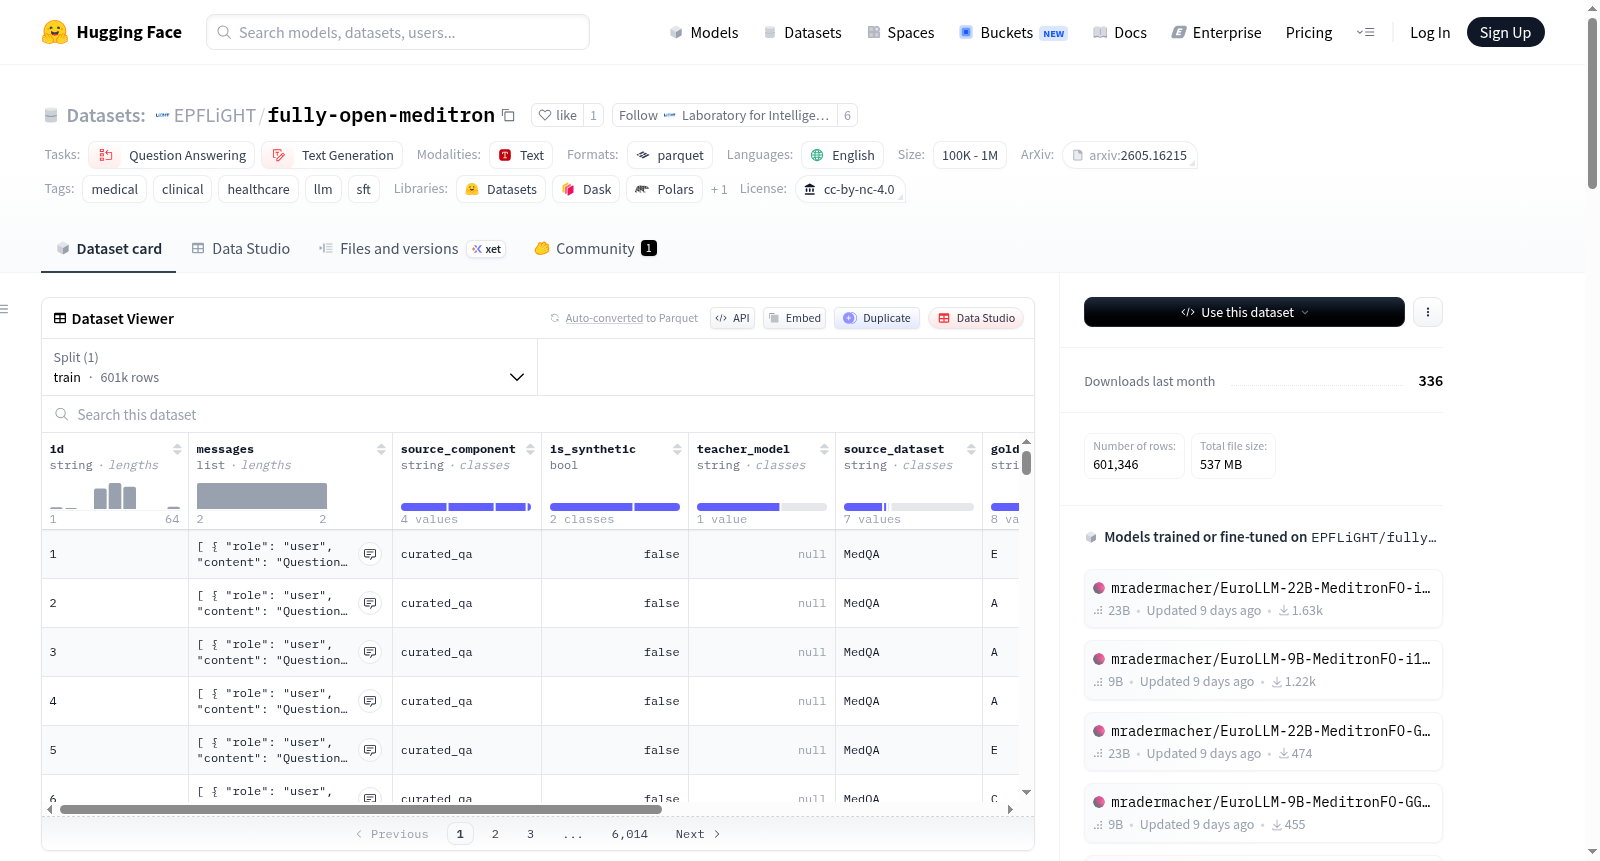
fully-open-meditron
收藏资源简介:
Fully Open Meditron Corpus 是一个专为医疗大语言模型设计的临床医生审核训练语料库,旨在支持临床决策支持和医疗问答任务的监督微调。该语料库整合了八个公开医疗问答数据集的聚合数据以及三个经过临床医生审核的合成组件,总共包含约601,346个样本(约1.5亿词元),并确保数据来源、生成提示和去污染过程的完全透明。核心组件包括:1) curated_qa(216,546个样本),来自MedQA、MedMCQA、PubMedQA等公开医疗QA数据集的训练分割,已归一化为(系统、用户、助手)对话格式;2) synthetic_curated_qa(214,654个样本),由gpt-oss-120b生成的新型考试风格问答,基于精选池种子生成,并按问题类型分层以监控答案位置偏差;3) guidelines_qa(145,681个样本),基于来自16个全球机构的46,469份临床实践指南的问答;4) synthetic_moove(24,465个样本),基于专家编写的临床案例库生成的开放式临床案例提示,旨在引发复杂诊断推理。默认配置为这四个组件的拼接。数据采用统一模式,包含唯一标识符、OpenAI风格对话消息列表、来源组件、是否为合成数据标志、教师模型、原始数据集名称、多项选择黄金答案字母和文本、教师预测匹配标志以及重采样尝试次数。构建过程涉及数据聚合、临床医生审核的合成生成(由四名医生小组审核生成提示模板)以及幻觉缓解(通过重采样确保预测答案与黄金标签匹配)。合成组件以CC BY-NC 4.0许可证发布供研究使用,而curated_qa组件作为衍生聚合数据保留其原始数据集许可证。该语料库仅用于研究目的,包括可重复性、审核和医疗大语言模型的红队测试,不应替代临床判断或未经独立安全评估直接部署。
数据集概述:Fully Open Meditron Corpus
基本信息
- 数据集名称: Fully Open Meditron Corpus
- 许可证: CC BY-NC 4.0(合成组件);原始数据集各保留其原有许可证(
curated_qa组件) - 语言: 英语
- 任务类型: 问答、文本生成
- 数据规模: 约 601k 样本(约 1.5 亿 tokens),属于 100K–1M 范围
- 标签: 医疗、临床、医疗保健、大型语言模型、监督微调
数据集描述
这是一个经过临床医生审核的医学大型语言模型训练语料库,伴随论文《Fully Open Meditron: An Auditable Pipeline for Clinical LLMs》发布。该语料库结合了八个聚合的公共医学问答数据集与三个经临床医生审核的合成组件,旨在支持用于临床决策支持和医学问答的大型语言模型的监督微调,并提供数据来源、生成提示和去污染过程的完全透明性。
数据组件
数据集包含四个子组件,可通过加载不同的 config 名称访问:
| 组件名称 | 样本数量 | 描述 |
|---|---|---|
curated_qa |
216,546 | 聚合的公共医学问答训练集(MedQA、MedMCQA、PubMedQA、MedExpQA、HealthSearchQA、LiveQA、AfriMed-QA v1/v2),归一化为 (system, user, assistant) 对话格式。系统级去污染移除了 173 项。 |
synthetic_curated_qa |
214,654 | 由 gpt-oss-120b 生成的新的考试式问答,从 curated 池中种子化,按问题类型分层,并持续监测答案位置以防止标签偏差。 |
guidelines_qa |
145,681 | 基于来自 16 个全球机构的 46,469 份临床实践指南的问答。 |
synthetic_moove |
24,465 | 开放式的临床小场景提示,种子化自专家编写的小场景池,旨在引发复杂的诊断推理。 |
| 总计 | 601,346 | 默认配置(default)串联所有四个组件。 |
数据模式
每条记录包含以下字段:
| 字段 | 类型 | 描述 |
|---|---|---|
id |
字符串 | 唯一标识符 |
messages |
列表(包含 role 和 content) |
对话,采用 OpenAI 风格格式,角色包括 system、user、assistant |
source_component |
字符串 | 来源组件名称:curated_qa、synthetic_curated_qa、guidelines_qa、synthetic_moove 之一 |
is_synthetic |
布尔值 | 该行是否由 LLM 教师生成 |
teacher_model |
字符串 | 用于生成的教师模型(gpt-oss-120b)或 null(对于原始条目) |
source_dataset |
字符串 | 原始公共数据集名称(仅 curated_qa 行) |
gold_label |
字符串 | 多项选择题的金标准答案字母(如适用) |
label_text |
字符串 | 多项选择题的金标准答案文本(如适用) |
exact_match |
布尔值 | 教师预测是否在拒绝采样后匹配金标准标签 |
try_count |
整数 | 所需的重新采样尝试次数(1–8) |
构建流程
语料库分三个阶段构建:
- 聚合阶段:八个公共医学问答数据集被归一化为统一的对话模式,无法明确映射的条目被丢弃。
- 临床医生审核的合成生成阶段:一个由四位医生组成的专家小组对每个少样本生成提示模板的三个抽样输出进行审核,分歧通过小组讨论解决。审核产生了生成流程的四项结构性改进,包括收紧对“争议性”和“过时”内容的宽泛约束;要求明确的疾病进展和地理背景;将问题主干与答案分离;以及排除过于美国中心化的措辞。合成组件随后由 gpt-oss-120b 生成。
- 幻觉缓解阶段:对于每个带有标注答案的多项选择题,通过数据集特定的正则表达式提取预测的字母,并在温度 0.7 下独立重新采样最多 8 次,直到提取的字母与金标准标签匹配。
预期用途
仅限研究用途,包括可重复性、审计和医学大型语言模型的红队测试。不旨在替代临床判断。基于此语料库训练的模型不应在未经独立领域特定安全性评估的情况下部署。
相关资源
- 论文: Fully Open Meditron: An Auditable Pipeline for Clinical LLMs
- 基于此语料库训练的模型: MeditronFO Collection
- 所属机构: LiGHT(EPFL),合作机构包括 Ariadne Labs(哈佛大学)和 Ashoka 大学 Koita 数字健康中心