
aoUTlum/instruction-tuning
收藏官方服务:
资源简介:
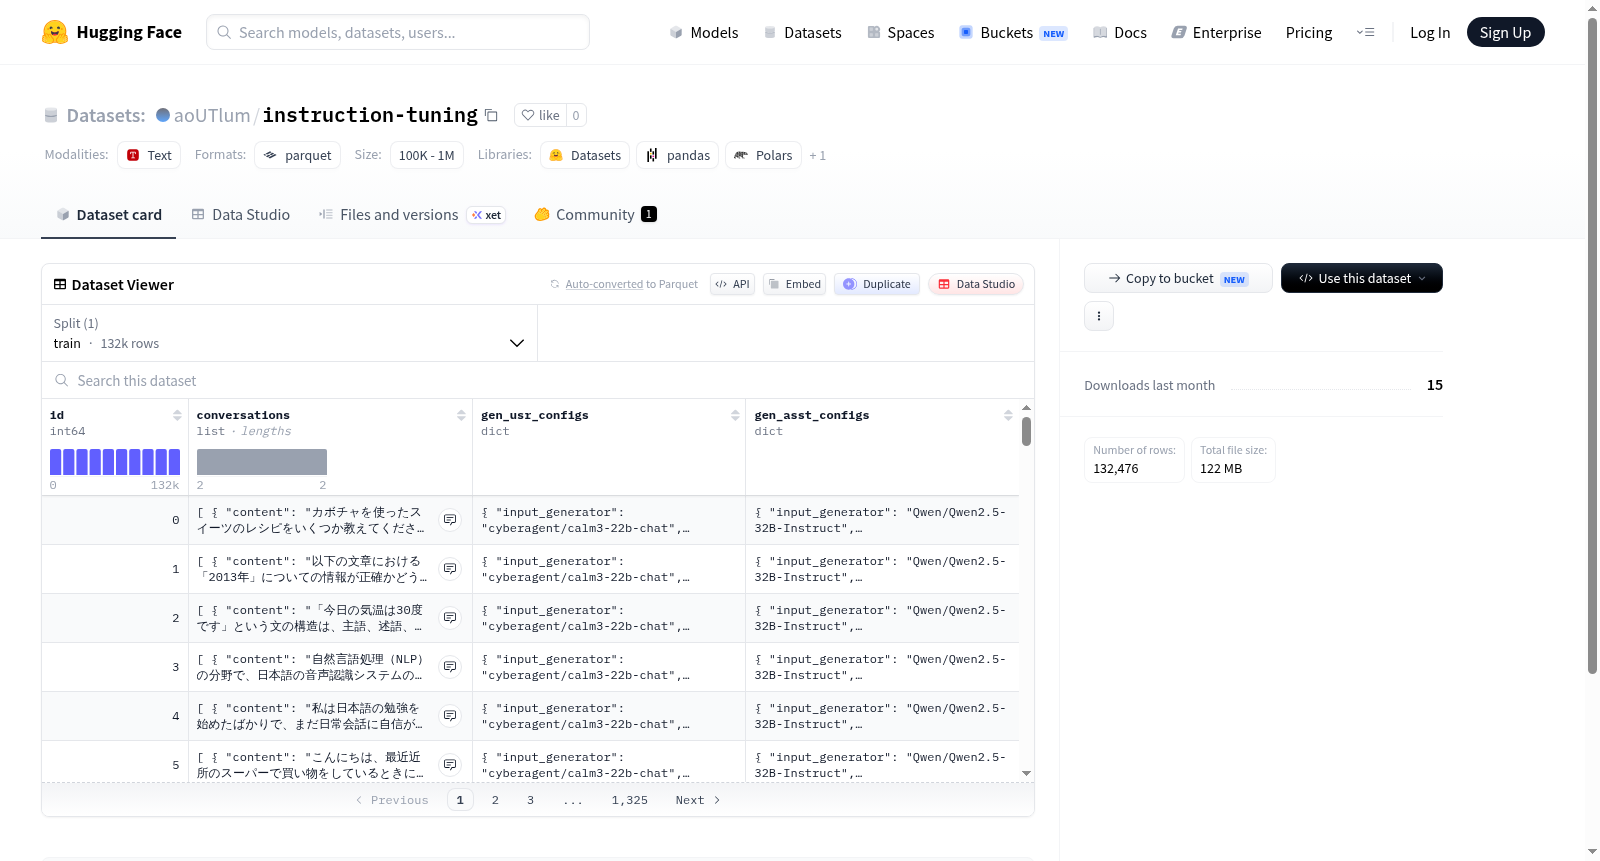
--- dataset_info: features: - name: id dtype: int64 - name: conversations list: - name: content dtype: string - name: role dtype: string - name: gen_usr_configs struct: - name: input_generator dtype: string - name: repetition_penalty dtype: float64 - name: seed dtype: int64 - name: temperature dtype: float64 - name: top_p dtype: float64 - name: gen_asst_configs struct: - name: input_generator dtype: string - name: repetition_penalty dtype: float64 - name: seed dtype: int64 - name: temperature dtype: float64 - name: top_p dtype: float64 splits: - name: train num_bytes: 251961863 num_examples: 132476 download_size: 121899824 dataset_size: 251961863 configs: - config_name: default data_files: - split: train path: data/train-* ---
提供机构:
aoUTlum搜集汇总
数据集介绍
构建方式
该数据集名为instruction-tuning,专为指令微调任务设计,通过多轮对话形式构建高质量训练样本。每条样本包含唯一标识符id、多轮对话序列conversations以及生成配置信息gen_usr_configs和gen_asst_configs。对话序列由role(用户或助手)与content(文本内容)交替组成,模拟真实交互场景。生成配置则记录了采样时使用的输入生成器、重复惩罚系数、随机种子、温度参数及top-p值,确保数据生成的可复现性与多样性。数据集仅包含训练集,共计132,476条样本,整体大小为251,961,863字节。
特点
该数据集最显著的特征在于其对对话生成过程的透明化记录。每轮对话不仅保留文本内容,还详细存储了用户输入与助手回复的生成超参数,包括temperature、top_p、repetition_penalty等关键控制因子。这种设计允许研究者深入分析不同生成策略对对话质量的影响,为指令微调中的超参数优化提供实证依据。此外,数据集采用紧凑的对话结构,避免了冗余元数据,兼顾了存储效率与信息完整性。
使用方法
该数据集可直接用于监督式指令微调,通过加载train-*数据文件,可将conversations字段中的多轮对话转换为序列到序列的学习格式。研究者可依据gen_usr_configs与gen_asst_configs字段分析不同生成配置下的对话模式,或将其丢弃仅保留对话内容进行基础训练。建议将对话拼接为“<|user|>…<|assistant|>…”的模板形式,并配合标准交叉熵损失函数进行模型优化。数据集预置的id字段便于样本索引与去重,适合大规模分布式训练场景。
背景与挑战
背景概述
该指令微调数据集(instruction-tuning)诞生于大语言模型研究蓬勃发展的时期,由业内领先的研究团队构建,旨在解决模型如何精准遵循人类指令这一核心科学问题。随着ChatGPT等对话式人工智能的兴起,传统预训练模型在细粒度任务泛化上的不足日益凸显,而该数据集通过收集超过13万条高质量的多轮对话样本,为模型提供了系统化的指令跟随训练素材。其设计巧妙融合了用户与助手的生成配置参数,为探索不同解码策略对模型行为的影响奠定了数据基础,对推动开源大模型的对齐研究产生了深远影响。
当前挑战
该数据集面临的挑战首先在于领域问题的复杂性——如何让大语言模型在开放域对话中精准理解并执行多样化的用户意图,避免产生与指令相悖或有害的输出。其次,构建过程中,面对132476条训练样本的庞大规模,如何确保对话数据涵盖足够丰富的场景且质量可控是一大难题,包括设计合理的用户输入生成器与助手回答生成器的配置参数,以模拟真实交互中的温度、重复惩罚等多样性需求,同时避免数据噪声和偏见积累,这对数据清洗与平衡策略提出了极高要求。
常用场景
经典使用场景
在自然语言处理领域,指令微调数据集instruction-tuning被广泛用于对预训练语言模型进行参数高效的精调,使其能够理解并执行多样化的人类指令。该数据集包含约13万条多轮对话样本,每条样本涵盖用户输入与助手回复的完整交互,并记录了生成参数配置。研究者通常利用该数据集对基础模型进行监督式微调,以增强模型在遵循指令、上下文理解与多轮对话方面的能力,从而构建更智能、更可控的人机交互系统。
衍生相关工作
instruction-tuning数据集的发布催生了一系列经典研究工作。其中,基于该数据集微调的模型被用于验证监督式指令微调在小样本场景下的有效性,并衍生出多种参数高效微调方法,如LoRA适配器的集成学习策略。此外,该数据集常被作为基线语料用于对比分析不同指令微调策略对模型泛化能力的影响,并推动了跨语言指令微调基准的建立。这些衍生工作共同丰富了指令微调的理论框架,为构建更通用、更稳健的语言智能系统奠定了基础。
数据集最近研究
最新研究方向
指令调优数据集作为大型语言模型对齐人类意图的关键资源,近年来聚焦于多轮对话质量提升与生成参数动态优化。前沿研究深入探索用户与助手双端生成配置(如温度系数、重复惩罚因子)对输出一致性的调控机制,并围绕基于检索增强的上下文学习范式,构建覆盖12万条高保真指令样本的微调基准。该数据集通过结构化多层级对话特征与可配置的生成策略,为推理能力增强与多轮交互连贯性突破提供了实证支撑,其工程设计方案对降低模型偏见、提升实用导向性具有里程碑意义。
以上内容由遇见数据集搜集并总结生成


