
topvenues
收藏官方服务:
资源简介:
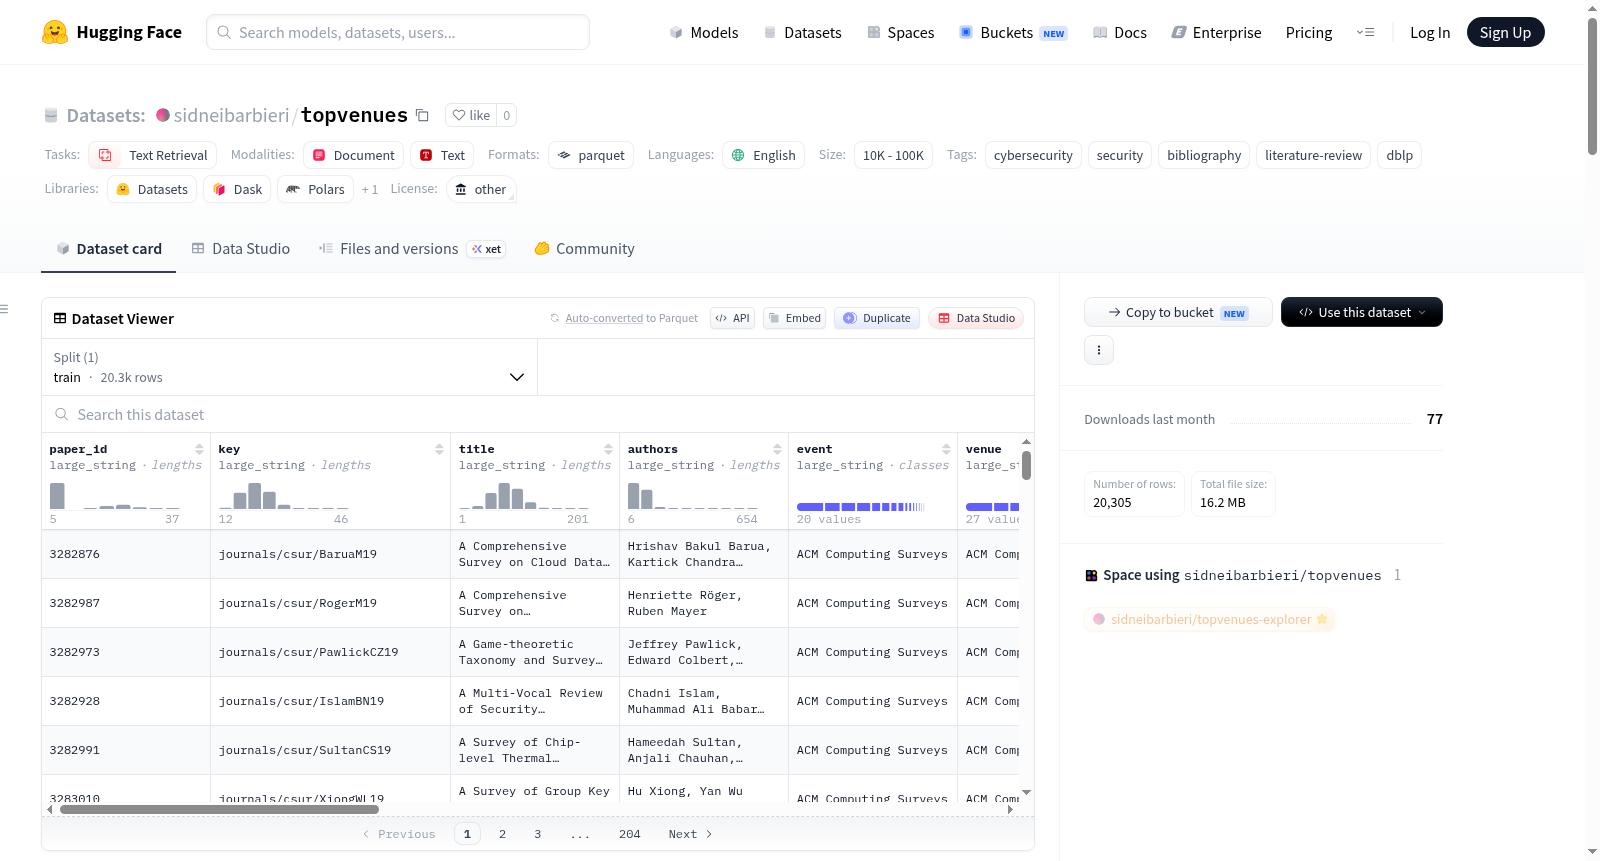
TopVenues 网络安全语料库是一个专为网络安全领域文献综述设计的可复现书目语料库。该数据集旨在提供一个高质量、聚焦的学术文献集合,以支持网络安全研究的系统文献回顾、检索和分析。语料库包含了 2017 年至 2026 年间,来自 20 个顶级网络安全及跨领域综述会议/期刊的 20,305 篇论文记录。每条记录均包含从 DBLP 获取的完整书目元数据(如唯一标识符、标题、作者列表、发表年份、出处、研究领域等)和规范的 BibTeX 条目。其中,17,491 条记录附有摘要,这些摘要通过整合 Semantic Scholar、OpenAlex、CrossRef 等开放学术资源及出版商页面获得。数据经过精心筛选,核心的 16,806 篇安全领域论文实现了 85.0% 的摘要覆盖率,未覆盖部分(如某些出版社限制的近期论文)已明确报告,确保了数据集的透明度和可追溯性。该数据集适用于文本检索任务,特别是网络安全领域的学术文献搜索、主题分析、引文网络构建及自动化文献综述工作。
创建时间:
2026-07-17
原始信息汇总
- 数据集名称: TopVenues Research Literature Corpus
- 发布时间: 2017-2026
- 许可协议: 其他(CC0,摘要版权归原始来源)
- 语言: 英语
- 任务类别: 文本检索
- 标签: 网络安全、安全、系统、网络、机器学习、参考文献、文献综述、DBLP
- 数据集规模: 100K < n < 1M
- 配置:
- default: 20,305 条记录,14,863 个独立 DBLP 键,覆盖 20 个场所(安全领域,冻结版本)。
- complete-40: 118,817 条记录,118,817 个独立 DBLP 键,覆盖 40 个场所(安全、系统、网络、移动、AI、NLP 领域),去重,包含 14,289 篇摘要及所有记录的 BibTeX。
- 使用示例:
- 加载 default 配置:
load_dataset("sidneibarbieri/topvenues", split="train") - 加载 complete-40 配置:
load_dataset("sidneibarbieri/topvenues", "complete-40", split="train") - 按特定场所过滤(如四大安全顶会):
complete.filter(lambda paper: paper["event"] in {"ACM CCS", "USENIX Security", "IEEE S&P", "NDSS"})
- 加载 default 配置:
- 数据字段:
paper_id: 稳定的 DBLP 衍生标识符key: DBLP 键title: 论文标题authors: 作者列表event/venue: 规范化的事件和来源场所area: 领域(安全、系统、网络、移动、AI、NLP 或跨领域)year: 出版年份paper_type/pages: 文献类型和页码url/ee: DBLP 和电子版链接abstract: 摘要(如有)bibtex: 规范的 BibTeX 记录
- 数据来源与许可: 书目元数据和 BibTeX 来自 DBLP(CC0 许可);摘要来自开放学术元数据服务和出版社页面(版权归原始来源)。
- 工具代码: 可在 https://github.com/sidneibarbieri/topvenues-tool 获取
- 引用: 见 README 中提供的 BibTeX 条目
搜集汇总
数据集介绍
构建方式
TopVenues数据集的构建严格遵循可复现与领域聚焦的原则,依托DBLP的CC0许可书目元数据,精选2017至2026年间20个安全及安全相关会议与期刊的20,305篇论文。其中17个为安全核心会议,3个为综述导向期刊,确保摘要覆盖率达85%以上。通过整合开源学术资源(Semantic Scholar、OpenAlex、CrossRef)回溯摘要,缺失部分由出版商标识或服务器限制所致,均明确披露。每条记录均含有DBLP规范的BibTeX条目,并以Gzipped SQLite快照为可信源,最终导出为Parquet格式,保障数据一致性与持久性。
特点
该数据集的核心特点在于其高度专注的网络安全文献范畴,摒弃混合领域噪声,使得17,491篇摘要的覆盖率紧贴安全研究实际。每条论文记录包含稳定的DBLP衍生标识、标准化会议名称、研究领域分类(如security、ai、networks)及BibTeX元数据,结构清晰。即使缺失摘要的论文仍可通过标题、作者、年份等字段检索。数据集的发布附有完整性校验值(SHA-256),确保用户可验证版本的一致性,契合科学研究的可复现要求。
使用方法
使用TopVenues数据集极为便捷,用户可通过Hugging Face的datasets库加载训练集,并基于灵活过滤功能进行定制化查询,例如直接筛选特定领域(如“security”)的论文。数据集以Parquet格式存储,兼容主流数据处理框架。此外,项目提供了独立的本地可视化工具,支持基于摘要内容的精确筛选(如提取包含“intrusion detection”的论文),并可预览搜索结果,提升文献综述的检索效率与直观性。
背景与挑战
背景概述
TopVenues网络安全语料库是由Sidnei Barbieri、Agney Lopes Roth Ferraz和Lourenço Alves Pereira Júnior于2026年创建的一个可复现的、专注于网络安全领域的书目语料库。该数据集旨在解决网络安全文献综述中语料库构建不透明、覆盖范围不完整的问题,收录了2017至2026年间来自20个安全及安全相关会议的20,305篇论文,其中包含17,491篇摘要和每条记录的BibTeX条目。通过聚焦于纯网络安全领域(17个安全会议和3个调研类会议),TopVenues显著提升了摘要覆盖率(安全核心部分达85.0%),为网络安全研究者提供了一致且可复现的文献综述基础。该数据集依托DBLP、Semantic Scholar、OpenAlex和CrossRef等开放学术来源构建,具有高度的透明性和可溯源特性,对推动网络安全领域系统性文献综述的规范化和自动化具有重要意义。
当前挑战
TopVenues语料库面临多重挑战。从领域问题角度,该数据集解决了网络安全文献综述中语料库构建标准不统一、覆盖范围碎片化的难题,尤其是传统方法常将安全论文混入AI、系统或网络等不相关领域,导致文献检索效率低下。在构建过程中,首要挑战是确保摘要的高覆盖率,特别是来自Springer出版的ESORICS等会议以及受出版商限制的最新论文集存在结构性缺失,部分记录仅有标题、作者等元数据而无摘要。其次,从多个开放来源(Semantic Scholar、OpenAlex、CrossRef)聚合摘要时,需协调数据格式差异和版权归属问题,第三方摘要文本的版权仍归原出版商所有。此外,语料库的日常维护和更新也面临挑战,需持续追踪新增会议、论文及元数据变化,以保持其作为可复现文献综述工具的有效性。
常用场景
经典使用场景
TopVenues网络安全语料库是专为网络安全领域的文献综述与信息检索而构建的精选语料资源,覆盖2017至2026年间来自20个顶级安全及相关期刊和会议的20,305篇论文,其中17,491篇包含摘要。该数据集最经典的使用场景是对网络安全研究方向进行系统性的文献映射与主题挖掘,研究人员可借助其规范化的元数据字段,如论文标题、作者、发表年份、研究领域及DBLP标识符,对特定安全子领域(如入侵检测、隐私保护或恶意软件分析)执行高效的过滤与检索,从而快速定位核心文献并构建知识图谱。其高质量的摘要和BibTeX条目集成,极大简化了文献管理流程,为大规模文献计量分析提供了可复现且可靠的数据基础。
实际应用
在实际应用中,TopVenues数据集深度赋能安全领域的自动化文献分析与知识服务系统。例如,安全分析师可利用其内置的抽象文本检索功能,对“入侵检测”等主题执行即时过滤与预览,从而迅速掌握最新防御技术动向。该语料库还支持构建领域专属的语言模型或知识图谱,用于自动生成研究综述、识别潜在合作者或评估学术影响力。对于企业安全团队而言,其跨年代与跨会议的数据结构有助于跟踪漏洞披露、攻击模式演化等实践议题的学术对应关系,为安全策略制定提供权威的文献证据,进而缩短从学术发现到工业部署的转化周期。
衍生相关工作
TopVenues数据集的推出催生了多个衍生经典工作方向。一方面,研究者利用其标准化语料开发了面向网络安全的文本分类与主题建模工具,用于自动标注论文的研究子领域或方法类别。另一方面,基于该语料中的BibTeX和摘要信息,衍生出针对安全会议影响力的计量评估框架,动态分析不同会址在时空维度上的学术传播效应。此外,该数据集作为可复现的基准,被用于对比不同文献检索策略的召回率与准确率,并为构建跨领域安全知识图谱提供了底层数据支撑。这些相关工作共同推动了网络安全文献信息学的体系化发展,强化了数据驱动型安全研究的理论基础。
以上内容由遇见数据集搜集并总结生成


