
遇见数据集

Bluefir/escampe-dataset

收藏
Hugging Face2026-05-30 更新2026-05-31 收录
官方服务:

资源简介:

该数据集包含数百万个棋盘游戏Escampe的评估游戏状态,旨在训练深度神经网络(如BandDPER架构)以准确预测任何给定棋盘状态的启发式值。Escampe是一款确定性的、完全信息的6x6棋盘游戏,使用独角兽和圣骑士进行。数据集通过Java中的Alpha-Beta搜索引擎程序化生成,该引擎自我对弈Escampe游戏,采用随机开局和半随机走子来保证棋盘状态的高多样性。数据集中的每个位置都通过minimax引擎使用多种启发式配置(默认、SPSA、贝叶斯和单纯形)进行深度评估,以分配连续得分。数据字段包括表示白方和黑方圣骑士位置的64位整数位棋盘掩码、独角兽的索引、当前玩家必须开始移动的所需带子约束、轮到哪方移动的布尔标志,以及归一化到[-1.0, 1.0]范围的得分(从当前移动玩家的视角)。数据集生成过程强调多样性,通过混合最佳走子和随机走子(70%探索)来暴露子最优、混沌和终局位置,并将原始启发式得分钳位并归一化。使用数据时需注意得分字段严格基于移动玩家的视角,并建议将位棋盘转换为6x6空间张量以更好地处理空间约束。

This dataset contains millions of evaluated game states for the board game Escampe. It is designed to train Deep Neural Networks (such as the BandDPER architecture) to accurately predict the heuristic value of any given board state. Escampe is a deterministic, perfect-information 6x6 board game played with Unicorns and Paladins. The dataset was procedurally generated using an Alpha-Beta search engine in Java that plays games of Escampe against itself, taking random opening positions and semi-random moves to guarantee high diversity in board states. Every position in this dataset has been deeply evaluated by the minimax engine using various heuristic configurations (Default, SPSA, Bayes, and Simplex) to assign a continuous score. The data fields include bitboard masks for Whites and Blacks Paladins, indices for Unicorns, an integer for the required band constraint, a boolean for which player is to move, and a normalized score in the range [-1.0, 1.0] from the perspective of the current player to move. The creation process emphasizes diversity through a mix of best-moves and random moves (70% exploration), and scores are clamped and normalized. Considerations include inverting the score when white_to_move is false for absolute advantage models and translating bitboards into spatial tensors for neural network input.
提供机构:
Bluefir
搜集汇总
数据集介绍
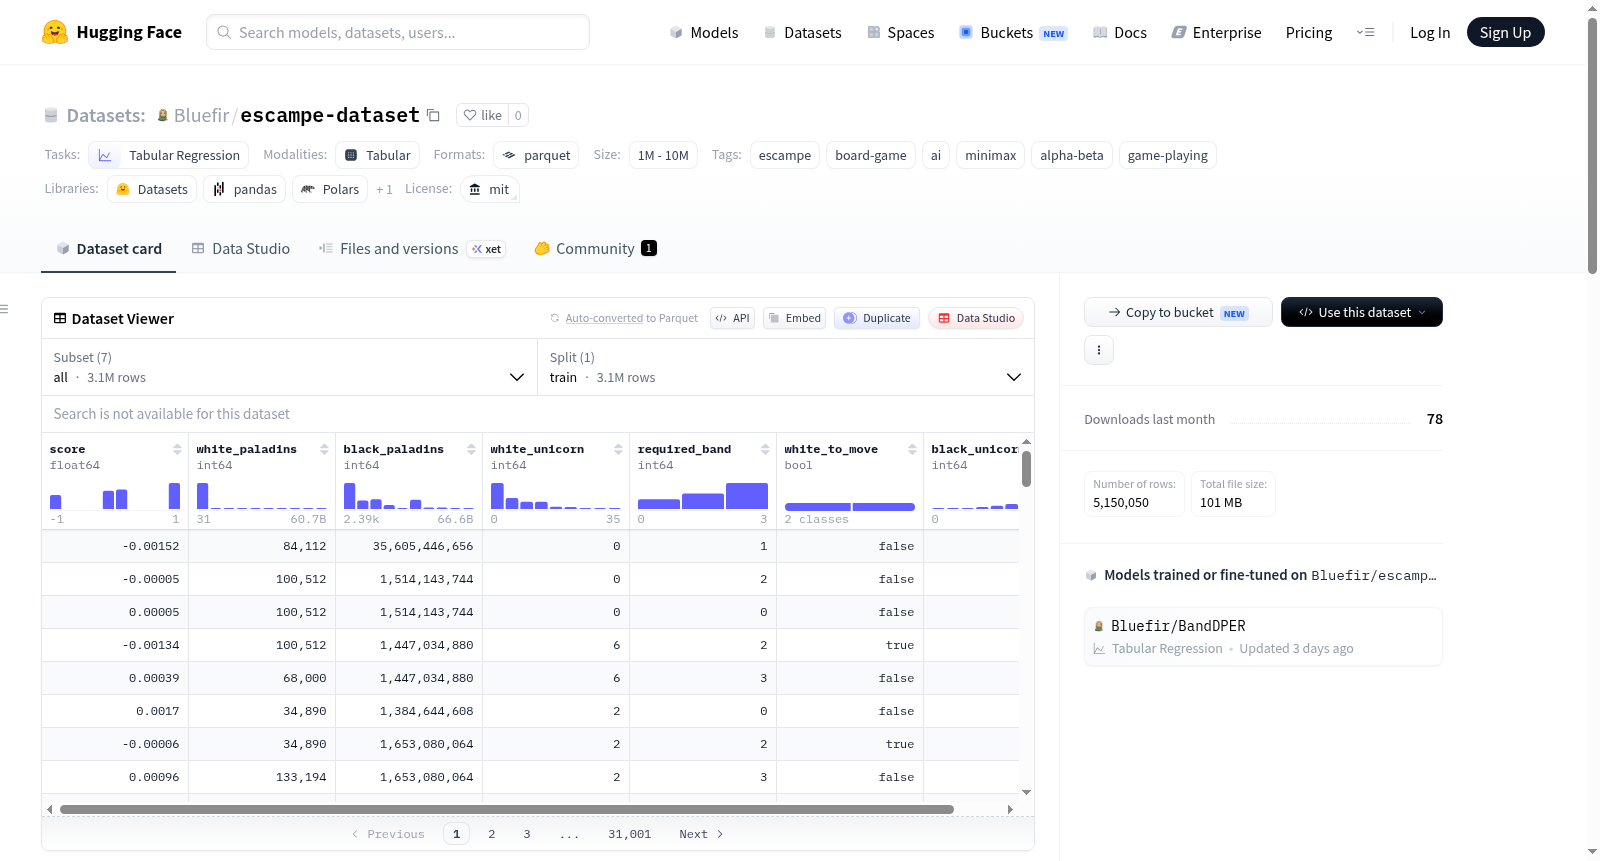
Bluefir/escampe-dataset 数据集图片
构建方式
该数据集通过一款基于Alpha-Beta剪枝算法的高性能多线程Java博弈引擎,在对战模式中自动生成海量棋盘状态。为保障样本多样性,引擎从预设的开局库中随机选取起始局面,并以70%的探索概率混合最优走法与随机落子,从而涵盖次优、混乱乃至终局阶段的丰富局面。每一局面的评估分数均由搜索引擎在不同启发式配置(默认、SPSA、贝叶斯及单纯形法)下深度计算而得,原始分数被钳制并归一化至[-1.0, 1.0]区间,形成连续的目标标签。
特点
数据集包含约310万个已评估的Escampe六乘六棋盘状态样本,每个样本以64位整数位棋盘掩码表示白马与黑马骑士的位置,以0至35索引表示白独角兽与黑独角兽的格子,并以整数字段标明当前行棋方需遵循的约束色带等级。布尔型字段white_to_move指示轮到哪一方行动,而浮点型score则代表从当前行棋方视角出发的标准化评估值,+1.0对应必胜局面,-1.0对应必败局面。数据集提供了从5万至100万样本不等的多个子集配置,便于研究者按需选择。
使用方法
用户可通过Hugging Face Datasets库加载该数据集,并指定所需的配置名称,如dataset_1m_d6或all以获取全部样本。每一行JSON记录均对应一个独立的棋盘状态。在训练模型时需特别注意,score字段严格从当前行棋方视角给出,若模型需输出白方的绝对优势值,则应在white_to_move为false时反转分数。建议将位棋盘表示转换为6x6空间张量,以充分暴露Escampe棋盘的正交路径与色带几何约束,从而提升神经网络的学习效果。
背景与挑战
背景概述
该数据集名为escampe-dataset,由Escampe AI项目团队创建,旨在为棋盘游戏Escampe的训练深度神经网络提供高质量的局面对局评估数据。Escampe是一种确定性、完美信息的6×6棋盘游戏,其中包含独角兽和圣骑士角色,游戏策略高度依赖于空间约束和阻挡逻辑。该数据集通过Java编写的Alpha-Beta搜索引擎自我对弈生成,结合随机开局和半随机走法以确保局面多样性,并利用多种启发式配置(如默认、SPSA、贝叶斯和单纯形法)对每个局面进行深入评估。数据集规模达到数百万次记录,为相关游戏AI研究提供了基础资源,具有推动类似零和游戏评估模型发展的潜力。
当前挑战
该数据集所解决的领域问题核心在于如何精准地评估Escampe游戏局面的启发式价值,尤其是面对多变的约束条件(如必需带条)和有限的6×6空间时,传统的评估方法往往难以兼顾效率与准确性。构建过程中面临的挑战主要包括:初始局面多样性保证困难,需在随机性与代表性之间取得平衡;多线程Alpha-Beta剪枝引擎的高效实现需处理复杂的并行计算与同步问题;启发式分数的归一化处理需谨慎设计,以将理论上的高数值(最大达100,000分)合理压缩到[-1,1]区间,同时保留胜负关键信息。
常用场景
经典使用场景
在人工智能与博弈论交叉领域,escampe-dataset被广泛用作训练深度神经网络以精准预测棋盘状态启发式价值的经典基准。该数据集包含由Alpha-Beta剪枝引擎在Escampe六乘六棋盘游戏中自对弈生成的大量已评估局面,每一样本均以连续分数编码当前玩家的胜负概率。研究者通常利用其结构化特征——如白方与黑方圣骑士的位棋盘掩码、独角兽位置及强制移动区域——来构建可解析空间约束的神经网络模型,如BandDPER架构。该数据集因涵盖从开局到终局的多样化状态,成为验证博弈评估算法泛化能力的理想平台。
解决学术问题
该数据集解决了博弈树搜索中启发式函数学习这一核心学术难题。传统极小极大搜索依赖手工设计的评估函数,难以适应复杂状态空间,而escampe-dataset通过提供大规模、高保真的标注局面,使得研究者能够训练深度学习模型直接从棋盘配置中学习价值函数。这显著缓解了零和博弈中状态评估的维度灾难问题,同时为理解神经网络如何捕获方位约束(如必选色带)和阻挡逻辑提供了实验依据。其影响在于推动了从规则驱动到数据驱动的博弈评估范式转变,并为多智能体强化学习中的奖励建模提供了可复用的数据基础。
衍生相关工作
基于escampe-dataset衍生出多项代表性研究工作。最典型的是BandDPER神经网络架构,它专为解析位棋盘输入而设计,能够学习不同色带约束下的走法优先级。此外,数据集的不同配置(如dataset_1m_d6_parra)催生了混合优化策略研究,将SPSA和Simplex调参方法与深度回归结合,以提升极小极大搜索的剪枝效率。后续工作还探索了该数据集在迁移学习中的应用——将Escampe中学到的空间推理能力迁移至其他棋盘游戏(如国际象棋变体)的评估函数初始化。这些衍生成果共同构建了从数据生成到模型部署的完整研究链条。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

