Amazigh-English-Tatoeba-Extended
收藏资源简介:
该数据集为阿马齐格语-英语分层复述数据集,旨在通过扩展目标端(英语)的句子多样性,加速阿马齐格语的自然语言处理、文本对齐和机器翻译任务。数据源自Tatoeba项目的标准摩洛哥阿马齐格语(使用阿马齐格文字)句子及其英语翻译平行语料。核心特征是为每个英语句子利用`gemini-3.1-flash-lite`模型生成了两组(rephrasings1和rephrasings2)共六个合成英语变体,其中rephrasings1组优先保持原句结构,rephrasings2组则更具创造性地选择其他表达方式,从而为下游任务提供了在严格结构遵从与灵活语境多样性之间的选择。数据集以JSON字典格式组织,以唯一的Tatoeba英语句子ID为索引,每个条目包含阿马齐格语句子ID、阿马齐格语文本、原始英语文本以及两个重述列表。该数据集适用于微调翻译模型以增强短语灵活性、训练大语言模型进行结构化文本复述,以及评估需要区分语法结构保留与自由形式创造性重写的NLP对齐策略。
This dataset is a Tamazight-English hierarchical paraphrasing dataset designed to accelerate natural language processing, text alignment, and machine translation tasks for Tamazight by expanding sentence diversity on the target side (English). The data originates from standard Moroccan Tamazight (using the Tifinagh script) sentences and their English translation parallel corpora from the Tatoeba project. A key feature is the generation of two sets (rephrasings1 and rephrasings2) totaling six synthetic English variants for each English sentence using the `gemini-3.1-flash-lite` model, where the rephrasings1 group prioritizes maintaining the original sentence structure, while the rephrasings2 group more creatively selects alternative expressions, thus providing a choice between strict structural adherence and flexible contextual diversity for downstream tasks. The dataset is organized in JSON dictionary format, indexed by unique Tatoeba English sentence IDs, with each entry containing Tamazight sentence ID, Tamazight text, original English text, and two rephrasing lists. It is suitable for fine-tuning translation models to enhance phrase flexibility, training large language models for structured text paraphrasing, and evaluating NLP alignment strategies that require distinguishing between grammatical structure preservation and free-form creative rewriting.
数据集卡片:Amazigh-English Tiered Rephrasing Dataset
数据集名称:Amazigh-English Tiered Rephrasing Dataset
主页:https://huggingface.co/datasets/abdelhaqueidali/Amazigh-English-Tatoeba-Extended
许可证:CC-BY-2.0
数据集描述
该数据集旨在通过扩展目标端英语多样性,加速阿马齐格语的自然语言处理、文本对齐和机器翻译任务。利用 gemini-3.1-flash-lite 进行高通量自动化处理,每条英语句子被扩展为两组(rephrasings1 和 rephrasings2),使下游训练流程能够在严格结构遵从性与灵活语境多样性之间进行选择。
数据集详情
- 策划者:Abdelhaque id ali
- 语言(NLP):标准摩洛哥阿马齐格语(阿马齐格文字)、英语
- 许可证:CC-BY-2.0(继承自底层 Tatoeba 源语料库)
- 数据集来源:
- 存储库:Tatoeba 项目(句子对的原始来源)
- 标签:对齐、微调、句子改写、文本生成、amazigh、tamazight、tifinagh
用途
- 直接使用:
- 使用增强目标端微调翻译模型,提升短语灵活性。
- 在结构化文本释义和规则遵从性上训练大语言模型。
- 评估语法结构保持与自由创意改写分离的 NLP 对齐策略。
- 非预期用途:不适用于没有人工验证的高风险法律、医疗或安全关键翻译部署。
数据结构
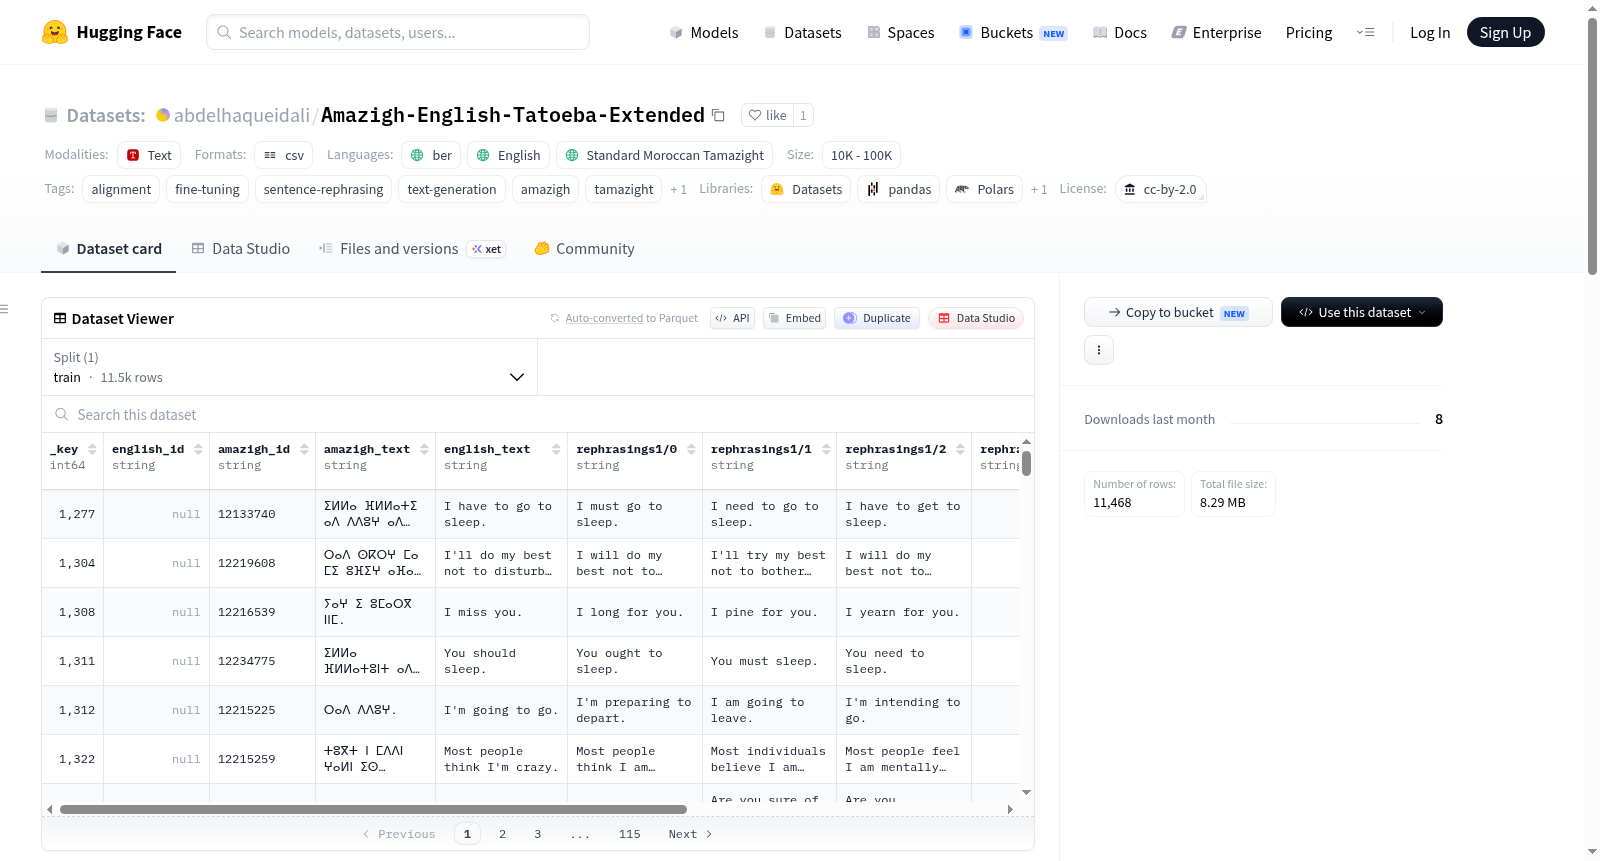
数据集包含两个改写组,english_text 是来自 Tatoeba 的原始翻译。rephrasings1 优先保持句子结构尽可能不变,rephrasings2 在句子含义上有更多创意选择。
数据集以 JSON 字典结构存储,索引为唯一的 Tatoeba 英语句子 ID,示例: json { "6666152": { "amazigh_id": "9732314", "amazigh_text": "ⵓⵔ ⴰ ⴱⴰⵀⵔⴰ ⵜⴳⴳⴰⵖ ⴰⵎⴰⴽⵢⴰⵊ", "english_text": "I dont often wear makeup.", "rephrasings1": [ "I do not frequently put on makeup.", "It is not often that I wear makeup.", "I seldom wear cosmetics." ], "rephrasings2": [ "I usually go without any makeup.", "Wearing makeup isnt a regular thing for me.", "I tend to keep my face natural most of the time." ] } }
另有 CSV 版本,字段 phrasing1/0、1/1、1/2 表示优先级改写。
特征列表
_key(int64):唯一键english_id(string):英语句子 IDamazigh_id(string):阿马齐格语句子 IDamazigh_text(string):阿马齐格语文本english_text(string):英语原始翻译rephrasings1/0至rephrasings1/3(string):第一组改写(结构保持优先)rephrasings2/0至rephrasings2/2(string):第二组改写(创意变化)