遇见数据集

nirantk/esci_ranking_lite

收藏
Hugging Face2024-01-22 更新2024-03-04 收录
官方服务:

资源简介:

--- dataset_info: features: - name: example_id dtype: int64 - name: query dtype: string - name: query_id dtype: int64 - name: product_id dtype: string - name: product_locale dtype: string - name: esci_label dtype: string - name: small_version dtype: int64 - name: large_version dtype: int64 - name: split dtype: string - name: product_title dtype: string - name: product_description dtype: string - name: product_bullet_point dtype: string - name: product_brand dtype: string - name: product_color dtype: string - name: relevance_pos dtype: int64 - name: __index_level_0__ dtype: int64 splits: - name: train num_bytes: 1481733293 num_examples: 1118011 download_size: 714939828 dataset_size: 1481733293 configs: - config_name: default data_files: - split: train path: data/train-* ---

数据集信息: 特征: - 名称:example_id(示例ID),数据类型:int64(64位整数) - 名称:query(查询文本),数据类型:string(字符串) - 名称:query_id(查询ID),数据类型:int64(64位整数) - 名称:product_id(商品ID),数据类型:string(字符串) - 名称:product_locale(商品地域),数据类型:string(字符串) - 名称:esci_label(ESCI标签),数据类型:string(字符串) - 名称:small_version(小样本版本标识),数据类型:int64(64位整数) - 名称:large_version(大样本版本标识),数据类型:int64(64位整数) - 名称:split(数据集划分),数据类型:string(字符串) - 名称:product_title(商品标题),数据类型:string(字符串) - 名称:product_description(商品描述),数据类型:string(字符串) - 名称:product_bullet_point(商品要点说明),数据类型:string(字符串) - 名称:product_brand(商品品牌),数据类型:string(字符串) - 名称:product_color(商品颜色),数据类型:string(字符串) - 名称:relevance_pos(相关性位置),数据类型:int64(64位整数) - 名称:__index_level_0__(索引列_0),数据类型:int64(64位整数) 数据集划分: - 名称:train(训练集),占用字节数:1481733293,示例总数:1118011 下载大小:714939828 数据集总大小:1481733293 配置项: - 配置名称:default(默认配置),数据文件: - 划分集:train(训练集),文件路径:data/train-*

提供机构:
nirantk
原始信息汇总

数据集信息

特征

  • example_id: 数据类型为 int64
  • query: 数据类型为 string
  • query_id: 数据类型为 int64
  • product_id: 数据类型为 string
  • product_locale: 数据类型为 string
  • esci_label: 数据类型为 string
  • small_version: 数据类型为 int64
  • large_version: 数据类型为 int64
  • split: 数据类型为 string
  • product_title: 数据类型为 string
  • product_description: 数据类型为 string
  • product_bullet_point: 数据类型为 string
  • product_brand: 数据类型为 string
  • product_color: 数据类型为 string
  • relevance_pos: 数据类型为 int64
  • index_level_0: 数据类型为 int64

数据分割

  • train: 包含 1118011 个样本,总字节数为 1481733293

数据集大小

  • 下载大小: 714939828 字节
  • 数据集大小: 1481733293 字节

配置

  • default: 包含训练数据文件,路径为 data/train-*
搜集汇总
数据集介绍
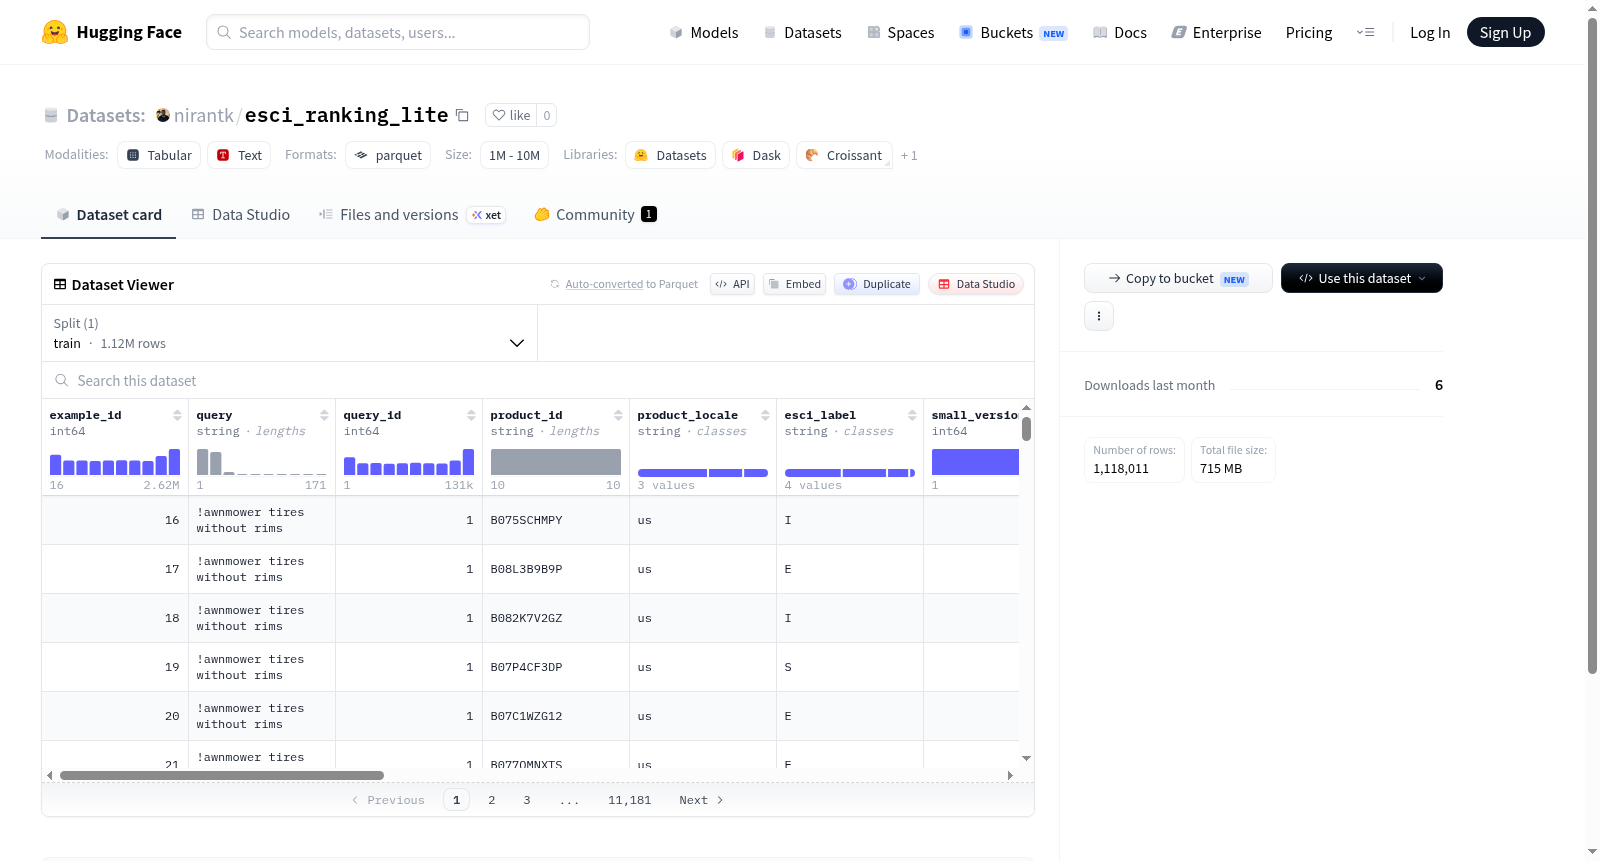
nirantk/esci_ranking_lite 数据集图片
构建方式
在电子商务搜索与推荐系统的研究领域中,高质量的相关性标注数据是模型训练的基石。nirantk/esci_ranking_lite数据集源自亚马逊公开的ESCI(Exact、Substitute、Complement、Irrelevant)标注体系,经过精心筛选与轻量化处理而成。该数据集保留了原始数据中用于排序任务的核心字段,包括查询文本、产品标题与描述、品牌颜色等属性,以及四分类的ESCI相关性标签。构建过程中,数据被组织为单一大规模训练集,包含超过111万条样本,每条记录均附有唯一标识符和标准化后的相关性排序位置,从而为排序模型的训练提供了清晰且结构化的监督信号。
特点
该数据集最显著的特点在于其轻量而全面的设计。它既保留了ESCI标签的细粒度语义区分能力,能够精确刻画查询与产品间的精确匹配、替代、互补及无关关系,又通过精简字段降低了存储与计算开销。数据涵盖多语言产品区域(product_locale)信息,支持跨地域的泛化性研究。此外,数据集提供了大小版本标识符,便于追踪数据演变,并内置了排序位置字段(relevance_pos),可直接用于学习排序(LTR)任务的损失计算与评估,是学术研究与工业实践之间的理想桥梁。
使用方法
使用该数据集时,研究者可直接通过HuggingFace Datasets库加载默认配置,获取包含111万条训练样本的标准化数据。每条样本包含查询、产品文本与结构化属性,适合构建基于双塔或交叉编码器的排序模型。建议将ESCI标签映射为四分类或多级相关性分数,结合relevance_pos字段设计pairwise或listwise损失函数。数据已预分好训练集,无需额外划分,可直接用于微调预训练语言模型,或作为电商搜索相关性评估的基准测试集。
背景与挑战
背景概述
在电子商务搜索与推荐系统的前沿研究中,查询与产品之间的相关性排序是提升用户体验与商业转化的核心任务。nirantk/esci_ranking_lite数据集由研究者在2020年代基于亚马逊公开的ESCI(Exact, Substitute, Complement, Irrelevant)标注体系构建,旨在为多语言、多模态的产品搜索排序提供大规模、细粒度的训练基准。该数据集汇集了超过110万条训练样本,涵盖查询文本、产品标题、描述、关键属性及地域信息,其核心研究问题聚焦于如何通过深度学习模型精确捕捉查询与产品之间复杂的语义匹配关系。作为ESCI数据集的轻量版,它降低了研究门槛,推动了跨语言产品检索、细粒度相关性分类及排序模型在工业级场景中的验证与部署,对电商搜索领域的学术研究与工程实践产生了深远影响。
当前挑战
该数据集所解决的领域挑战主要在于电子商务搜索中相关性排序的模糊性与多样性,例如产品与查询之间可能存在的替代、互补或完全不相关关系,传统二元相关标注难以刻画这种多级语义差异。在构建过程中,研究者面临多重困难:首先,来自不同国家与语言的产品数据需统一标注规范,确保跨地域一致性;其次,产品描述、标题与属性文本存在大量噪声与缺失,清洗与标准化工作繁重;此外,大规模标注需要平衡人工成本与标注质量,ESCI标签体系本身对标注者理解能力要求较高,易引入主观偏差。这些挑战迫使研究者在数据采样、标签映射与质量校验上设计精细策略,最终形成了兼具规模与细粒度的可用资源。
常用场景
经典使用场景
在电子商务搜索与推荐系统的研究中,nirantk/esci_ranking_lite数据集作为一项轻量级但信息丰富的资源,被广泛用于产品检索排序模型的训练与评估。该数据集源自亚马逊电商平台,涵盖了查询、产品标题、描述、属性等多维文本信息,并提供了ESCI(Exact、Substitute、Complement、Irrelevant)四类细粒度相关性标签,为研究者构建多层级语义匹配模型提供了坚实的数据基础。经典使用场景包括基于交互式或表示式的深度相关性排序模型开发,以及跨语言或跨域产品搜索的迁移学习验证。
实际应用
在实际应用中,该数据集支撑了电商平台智能搜索功能的优化,使系统能够区分用户对特定产品的直接购买意图与替代性探索需求。例如,当用户搜索“运动鞋”时,模型可依据ESCI标签优先展示精确匹配的跑鞋,而非仅呈现相关品类。此外,数据集还被用于构建个性化推荐中的互补品关联(如手机与手机壳),以及提升长尾查询的召回质量。这些应用直接降低了用户决策成本,提升了平台转化率与购物体验的流畅度。
衍生相关工作
该数据集催生了多项具有影响力的研究工作,最著名的当属亚马逊团队提出的ESCI模型框架,该框架首次将四类相关性标签引入大规模商品排序系统。后续研究包括基于预训练语言模型(如BERT)的细粒度相关性分类器,以及结合知识图谱的语义增强排序方法。此外,有学者利用该数据集验证了对比学习在稀疏查询场景下的有效性,并衍生出面向多模态(标题+图像)的跨模态检索新范式。这些工作不仅深化了学术界对电商排序问题的理解,也为工业界部署高效检索系统提供了可靠依据。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务