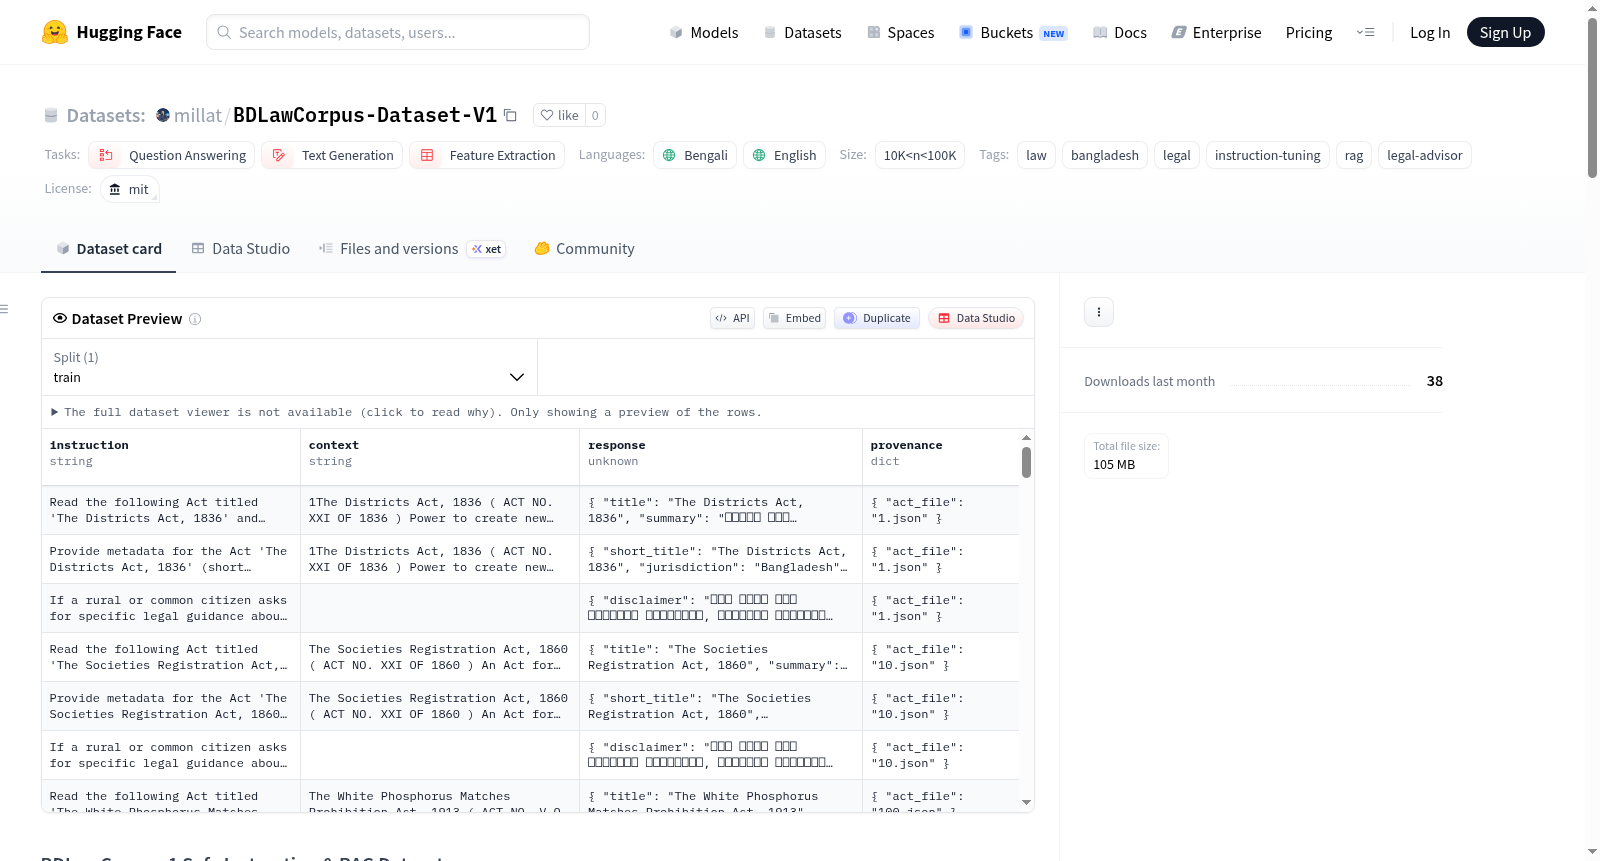
BDLawCorpus-Dataset-V1
收藏资源简介:
BDLawCorpus-1 安全指令与 RAG 数据集是首个针对孟加拉国法律的综合性、抗幻觉且经过指令调优的数据集,旨在训练法律 AI 助手。该数据集将复杂的法律条文翻译为易于理解的孟加拉语(সহজ বাংলা),并嵌入了严格的安全防护措施。数据集包含四个部分:1) `rag_passages.jsonl`(15.4k+ 段落),用于语义搜索/向量数据库;2) `finetune.jsonl`(4.7k+ 对),用于训练 LLMs 成为“法律顾问”;3) `qa_pairs.jsonl`,包含问题-答案对;4) `metadata.csv`,提供元数据框架以防止提供过时的建议。数据集适用于检索增强生成(RAG)和指令微调(LoRA/QLoRA),并已通过实证质量评估,确保其定量、安全和结构维度的有效性。
数据集概述
数据集名称:BDLawCorpus-1 Safe Instruction & RAG Dataset
数据集地址:https://huggingface.co/datasets/millat/BDLawCorpus-Dataset-V1
许可证:MIT
任务类别:问答、文本生成、特征提取
语言:孟加拉语(bn)、英语(en)
标签:法律、孟加拉国、法律、指令微调、RAG、法律顾问
数据规模:10K < n < 100K
数据集构成
该数据集包含四个独立部分,适用于RAG流水线和模型微调(LoRA):
- rag_passages.jsonl:包含15,400多个分块,涵盖1,570部孟加拉国现行及历史法案的语义分块,适用于语义搜索和向量数据库。
- finetune.jsonl:包含4,700多个指令-上下文-响应对,用于将大语言模型训练为“法律顾问”角色,每条响应均包含强制免责声明。
- qa_pairs.jsonl:包含问答分块,映射至法案目的,并包含“对抗性拒绝”训练样本,引导模型在缺乏上下文时拒绝回答。
- metadata.csv:包含元数据框架,记录“提及修正”、“已废除”及“被替代”规则,防止RAG系统提供过时建议。
数据集结构示例
-
RAG分块:
- 包含ID、标题、法案文件名、文本起始/结束位置及文本内容。
- 示例字段:
id、title、act_file、start、end、text
-
微调对:
- 包含指令(instruction)、原始法律文本(context)、结构化AI响应(response)及溯源信息(provenance)。
- 示例字段:
instruction、context、response(含disclaimer、info、next_steps)、provenance
数据集用途
- 为孟加拉国法律AI应用提供安全、结构完整且语言易用的基础。
- 限制AI作为咨询实体而非权威法院,通过内置免责声明和特定拒绝训练降低法律幻觉风险。
使用方法
可通过Hugging Face datasets 库加载数据:
-
加载RAG分块: python rag_dataset = load_dataset("millat/BDLawCorpus-Dataset-V1", data_files="rag_passages.jsonl")
-
加载微调对: python finetune_dataset = load_dataset("millat/BDLawCorpus-Dataset-V1", data_files="finetune.jsonl")
用例1:RAG:将 rag_dataset 输入多语言嵌入模型,存储向量至ChromaDB、Pinecone或FAISS。
用例2:指令微调:使用 finetune_dataset 结合Unsloth或Hugging Face TRL框架微调基础模型(如Llama-3-8B、Qwen-2.5)。
相关资源
- 代码库与方法论:完整开源,详见 GitHub 仓库:https://github.com/codermillat/BDLawCorpus
数据质量评估
-
量化统计:
- RAG分块总数:15,428个
- RAG分块平均长度:2,581.55字符,最大长度:10,934字符
- 微调场景数:4,710对
- 指令响应平均长度:260.95字符
-
对齐与安全防护:
- 免责声明注入率:33.33%(1,570条微调对)
- 对抗性拒绝嵌入率:33.33%(1,570条微调对)
-
结构完整性与溯源:
- 数据污染(HTML/JS痕迹):0%(完美清洗)
- RAG溯源链接率:100%
- 微调对溯源链接率:100%