
ipfs_serbia_laws
收藏官方服务:
资源简介:
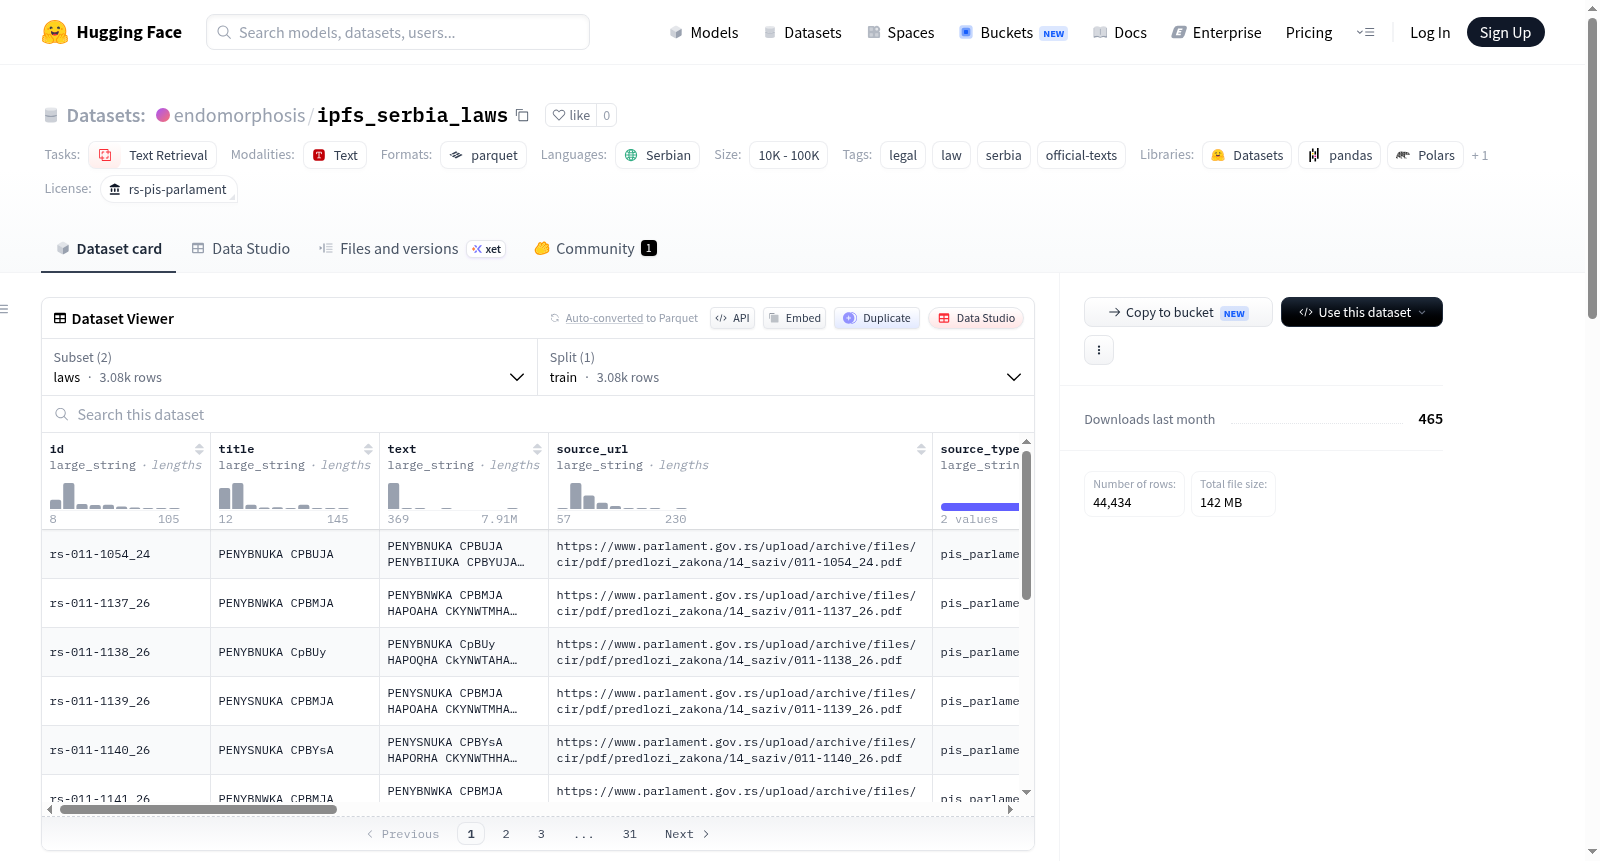
塞尔维亚法律数据集是一个官方立法的研究快照,数据来源于 PIS 和 parlament.gov.rs 的 PDF 文件。该数据集包含 2198 条法律/法规(laws)和 41004 条条款(articles),以 Parquet 格式存储。laws 子集每行对应一项法律/法规,包括标识符、标题、全文、日期、状态、法律编号、条款数量和来源 URL 等字段。articles 子集每行对应一条条款,包含所属法律 ID、条款编号、标题、文本和来源 URL。数据集适用于法律文本检索、分析、自然语言处理等研究任务,但请注意:本数据集并非官方整合版本,不构成法律建议,官方来源应优先适用。
创建时间:
2026-09-05
原始信息汇总
塞尔维亚法律数据集(Laws of Serbia)
数据集概述
该数据集是塞尔维亚官方立法的研究快照,通过从 PIS 和 parlament.gov.rs 的法律 PDF 文件收集而来。内容涵盖法律条文及具体条款,用于文本检索等任务。
重要声明: 本数据集不构成法律建议,也不属于官方整合版本,应以官方公报/政府门户网站的内容为准。
基本信息
| 项目 | 详情 |
|---|---|
| 快照日期 | 2026-09-07 |
| 覆盖范围 | 目录支持,不完整 |
| 数据来源 | PIS + parlament.gov.rs 法律 PDF 文件 |
| 语言 | 塞尔维亚语(sr) |
| 司法辖区 | 塞尔维亚 |
| 许可证 | rs-pis-parlament |
| 数据量级别 | 1K < n < 10K |
数据规模
- 法律/文书数量: 2,260 部
- 条款数量: 41,004 条
数据内容与结构
数据集包含两个配置及对应文件:
laws(法律配置)
- 文件:
data/laws.parquet - 内容: 每行对应一部法律文书,包含 ID、标题、全文、日期、状态、标识符、条款数量和来源 URL 等字段。
articles(条款配置)
- 文件:
data/articles.parquet - 内容: 每行对应一个条款/章节,包含法律 ID、条款编号、标题、文本和来源 URL。
配套脚本
数据集中还包含用于构建此快照的爬虫脚本:
scrapers/collect_rs.py— 研究用数据收集脚本scrapers/common.py— 共享收集辅助工具scrapers/world_lib.py— 共享抓取功能(实时官方 URL,Wayback 回退)scrapers/archive_fallbacks.py— Wayback / Common Crawl CDX 辅助工具
许可与复用
官方政府/公报文本,依据来源门户网站的公共部门条款进行复用。此打包、元数据和收集脚本仅供研究使用。
附加说明
技术备注:tip+21y SKIP_LIVE CC-S3 WARC+OCR tip+21y warc_fast,暗示该数据集与网络归档和 OCR 处理流程相关。
搜集汇总
数据集介绍
构建方式
在塞尔维亚法律体系数字化进程中,官方立法文本的获取与结构化处理构成法律信息学研究的基础环节。该数据集通过自动化采集脚本collect_rs.py,从塞尔维亚议会官方门户parlament.gov.rs的zakoni PDF文件及法律信息系统PIS中抓取法律文本,采用Wayback Machine与Common Crawl CDX等存档回退机制保障数据获取的鲁棒性。采集过程覆盖3084部法律文件,经文本解析与分段处理,提取出41350条条款单元,最终以Parquet列式格式存储,形成包含法律层级与条款层级的双配置文件结构,为法律文本检索与计算分析提供可复现的研究快照。
特点
该数据集呈现出法律文本资源的结构化与层次化特征。其核心特点在于双轨数据架构:laws.parquet以单行记录每部法律的全文本、颁布日期、效力状态及标识符等元数据,articles.parquet则以条款为粒度记录法律编号、条款序号、标题及正文,支持从宏观法律到微观条款的多层级检索。数据集覆盖塞尔维亚共和国官方法律文本,语言为塞尔维亚语,规模处于1K至10K区间,具有明确的司法管辖属性与官方来源标记。作为研究性快照,其覆盖范围经目录核验但非完整,且附带明确的免责声明,强调官方公报的优先效力,体现了法律数据严谨的溯源意识与合规边界。
使用方法
该数据集面向法律文本检索、法律信息提取及司法计算研究等任务。使用者可通过HuggingFace datasets库加载laws或articles配置,分别获取法律层级或条款层级的Parquet数据,进而利用法律编号、条款序号等字段进行关联查询与文本分析。数据适用于构建法律问答系统、条款相似性匹配、法律文本分类等应用场景,亦可作为塞尔维亚法律语言模型的预训练或微调语料。需注意,数据集仅作研究用途,不构成法律建议;实际法律适用应以塞尔维亚官方公报及政府门户发布的权威文本为准,使用者应遵循公共部门来源条款进行合规复用。
背景与挑战
背景概述
塞尔维亚法律文本数据集(ipfs_serbia_laws)作为一个研究快照,源自PIS与parlament.gov.rs官方门户的立法PDF文档,由研究团队于2026年9月8日构建,涵盖3084部法律文书及41350条条款,采用塞尔维亚语记录。该数据集针对法律信息检索与文本分析领域,致力于解决官方立法文本分散、格式异构导致的获取与利用难题,为法律自然语言处理、比较法学及政策研究提供结构化语料基础,其影响力在于推动东南欧地区法律数据的开放与可计算化进程。
当前挑战
该数据集所应对的领域问题在于法律文本检索中条款级语义关联的精准提取,以及跨文档法律效力状态的动态追踪。构建过程中,需克服官方PDF格式不统一、扫描件OCR噪声、网页动态加载与存档回退机制兼容等障碍,同时确保数据覆盖的完整性受限于源目录的枚举范围,且需在无官方合并文本的背景下维持条款划分的准确性,避免因碎片化采集导致的法律引用歧义与时效性偏差。
常用场景
经典使用场景
在法律信息检索与自然语言处理领域,针对特定国家法律文本的语料库构建一直备受关注。ipfs_serbia_laws数据集汇集了塞尔维亚共和国官方立法文本,以法律条文与条款为基本单元,为文本检索任务提供了结构化的数据支撑。其经典使用场景集中于法律条文检索与法条匹配,研究者可基于该数据集训练和评估检索模型,实现从自然语言查询到具体法律条款的精准定位,亦可支撑跨法条语义相似度计算与法律知识库构建等任务。
实际应用
在实务层面,该数据集可服务于法律科技产品的研发与公共法律服务的优化。法律从业者与开发者能够借助其构建面向塞尔维亚法律体系的智能检索系统、法条推荐工具或法律问答原型,辅助律师、法官及公众快速定位相关规范。同时,该数据集亦可用于政府信息公开平台的内容组织、法律文本的版本追踪以及合规审查辅助工具的探索性开发,为法律信息化的实践应用提供原始语料支撑。
衍生相关工作
围绕该数据集,已有研究将其应用于塞尔维亚语法律文本检索基线模型的构建与评测,并衍生出面向低资源法律领域的预训练语言模型微调实验。部分工作利用其条款级结构开展法律文本分段、主题分类与语义相似度分析,亦有研究将其作为多语言法律语料库的组成部分,探索跨语言法律信息检索的可行性。这些衍生工作共同拓展了该数据集在法律自然语言处理研究中的应用边界。
以上内容由遇见数据集搜集并总结生成


