
pramitsahoo/clickbait-spoiling-data-question
收藏官方服务:
资源简介:
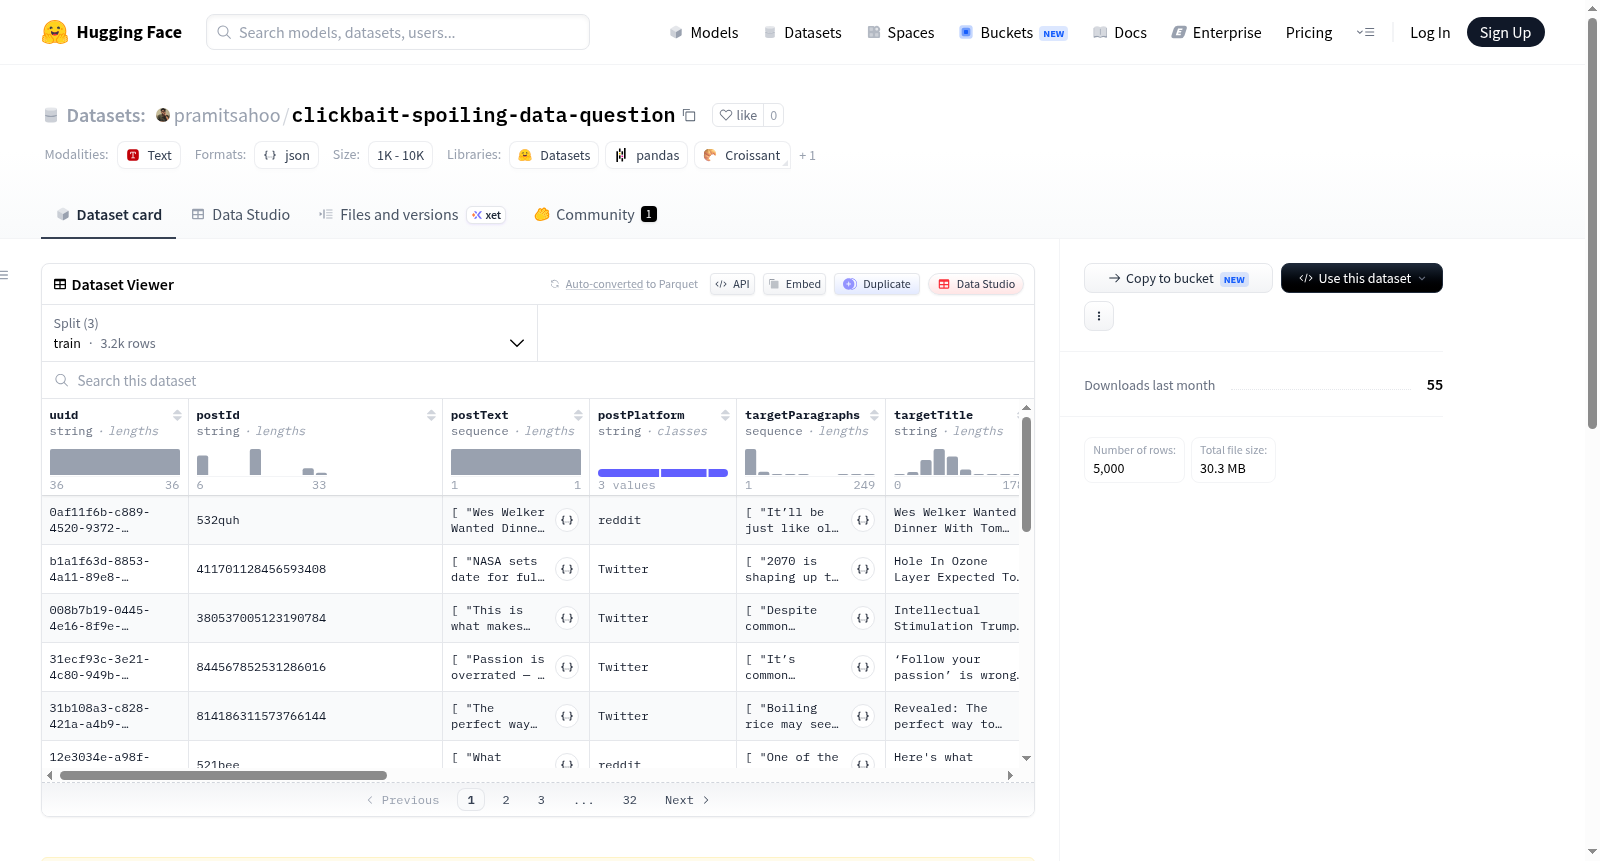
Webis Clickbait Spoiling Corpus 2022(Webis-Clickbait-22)包含从Facebook、Reddit和Twitter爬取的5,000个点击诱饵帖子。该数据集支持点击诱饵剧透任务,即生成满足点击诱饵帖子引发的简短文本。数据集包含点击诱饵帖子、手动清理的链接文档以及为每个点击诱饵帖子提取的剧透内容。剧透内容分为三种类型:短短语剧透、较长段落剧透和多个不连续的文本片段。数据集被划分为训练集、验证集和测试集,其中测试集用于SemEval-2023点击诱饵剧透任务。
Webis Clickbait Spoiling Corpus 2022(Webis-Clickbait-22)包含从Facebook、Reddit和Twitter爬取的5,000个点击诱饵帖子。该数据集支持点击诱饵剧透任务,即生成满足点击诱饵帖子引发的简短文本。数据集包含点击诱饵帖子、手动清理的链接文档以及为每个点击诱饵帖子提取的剧透内容。剧透内容分为三种类型:短短语剧透、较长段落剧透和多个不连续的文本片段。数据集被划分为训练集、验证集和测试集,其中测试集用于SemEval-2023点击诱饵剧透任务。
提供机构:
pramitsahoo原始信息汇总
Webis Clickbait Spoiling Corpus 2022 (Webis-Clickbait-22)
数据集概述
- 数据来源:Facebook, Reddit, Twitter
- 数据量:包含5,000个已解密的点击诱饵帖子
- 数据内容:包含点击诱饵帖子、手动清理后的链接文档及提取的剧透内容
- 剧透分类:分为短语剧透、长段落剧透和多段非连续文本剧透
数据集用途
- 任务支持:支持点击诱饵解密任务,即生成满足点击诱饵帖子引起好奇心的简短文本
数据集结构
- 训练集:3,200个帖子
- 验证集:800个帖子
- 测试集:1,000个帖子
- 测试集用于SemEval-2023点击诱饵解密任务
相关任务
- SemEval-2023点击诱饵解密任务:该任务通过TIRA.io组织,参与者提交Docker软件进行任务执行
搜集汇总
数据集介绍
构建方式
该数据集名为Webis Clickbait Spoiling Corpus 2022,源自对Facebook、Reddit和Twitter等社交平台上5000条具有诱导性标题的帖子进行系统化采集。每条帖子均配备了经过人工清洗的关联文档链接内容,以及针对性的揭穿型摘要文本。特别地,数据集将揭穿文本细分为三类:短短语型、段落型以及非连续多片段型,以适配不同复杂度的标题诱导模式。数据被划分为训练集(3200条)、验证集(800条)和测试集(1000条),其中测试集已被用于SemEval-2023的揭穿标题任务。
特点
该数据集的核心特色在于其精细化的揭穿文本分类体系,能够覆盖从简洁短语到连贯段落乃至非连续文本片段的多样化揭穿需求。通过人工清洗的文档链接内容,确保了揭穿文本的准确性与可靠性。此外,数据集严格遵循了预定义的训练、验证与测试划分,为模型评估提供了标准化基准。其与SemEval-2023任务的深度集成,进一步验证了数据集的实用性与领域权威性。
使用方法
使用者可直接加载预划分的JSONL格式文件,无需额外处理即可用于模型训练与评估。该数据集特别适用于序列到序列的文本生成任务,例如基于注意力机制的Transformer模型。建议采用揭穿文本类型标签作为辅助特征,以提升模型对不同类别标题揭穿的适应能力。同时,可参考SemEval-2023竞赛中提交的Docker化解决方案,通过TIRA平台复现或改进已有方法,从而快速开展对比实验与性能优化。
背景与挑战
背景概述
在社交媒体蓬勃发展的当下,标题党现象已成为网络信息生态中的顽疾,其通过夸大或误导性标题诱导用户点击,不仅降低了信息获取效率,更滋生了虚假信息的传播。为应对这一挑战,Webis研究团队于2022年发布了Webis Clickbait Spoiling Corpus 2022数据集,该数据集由来自Facebook、Reddit和Twitter的5,000条已揭露真相的标题党帖子构成,旨在推动标题党内容揭露任务的研究。该数据集的核心研究问题在于如何自动生成简洁文本以消解标题党帖子所引发的用户好奇心,从而还原信息真相。作为SemEval-2023标题党揭露任务的核心基准,该数据集为自然语言处理领域中的虚假信息治理提供了关键评估资源,显著推动了相关算法的发展与比较。
当前挑战
该数据集所面临的挑战首先体现在领域问题层面:标题党揭露任务要求模型不仅能够准确识别标题党内容,还需从链接文档中提取出足以满足用户好奇心的真相文本,这涉及复杂的语义理解与信息压缩能力。此外,数据集构建过程中亦遭遇多重困难,包括从多平台海量数据中筛选高质量样本、对链接文档进行人工清洗以去除噪声、以及将揭露文本精准分类为短短语、长段落或非连续片段三种类型。这些分类标签的界定与标注需要高度一致的判断标准,确保数据质量与任务评估的可靠性,为后续模型训练与评测奠定了坚实基础。
常用场景
经典使用场景
在网络信息爆炸的时代,标题党文章以其耸人听闻或极具诱导性的标题吸引用户点击,却往往提供与标题不符的低质内容。该数据集聚焦于标题党帖文的拆解任务,即通过生成简洁文本揭示标题背后的真实信息,从而消除用户的好奇心。经典使用场景包括训练模型自动识别并生成针对标题党帖文的拆解内容,涵盖短短语、长段落以及多段不连续文本三种拆解类型,为自然语言处理领域中的信息可信度评估与用户意图理解提供了关键支撑。
衍生相关工作
该数据集催生了多项具有影响力的研究工作,其中最著名的是基于该数据组织的SemEval-2023标题党拆解共享任务,吸引了全球数十个研究团队参与。参赛方法涵盖了从基于预训练语言模型(如BART、T5)的序列生成到检索增强型拆解等多种技术路线,推动了文本简化与信息压缩领域的进展。此外,后续研究进一步扩展了该数据集的应用边界,包括多语言标题党拆解、跨平台泛化能力分析以及结合用户反馈的迭代拆解策略,形成了以该数据集为核心的研究生态系统。
数据集最近研究
最新研究方向
在信息过载的数字时代,标题党现象严重干扰了用户的信息获取体验,而点击诱饵破坏(clickbait spoiling)作为一项前沿研究任务,旨在通过自动生成简洁文本以消解点击诱饵引发的虚假好奇心。pramitsahoo/clickbait-spoiling-data-question数据集源自Webis Clickbait Spoiling Corpus 2022,包含5000条来自Facebook、Reddit和Twitter的已破坏点击诱饵帖子,并创新性地将破坏文本划分为短语型、段落型及非连续文本型三类。该数据集被用于SemEval-2023共享任务,推动了通过自然语言处理技术对抗低质信息流的研究浪潮。其意义在于为社交媒体平台提供自动化内容治理工具,同时促进人机协作中信息真实性的维护,是当前计算语言学与虚假信息防控交叉领域的重要资源。
以上内容由遇见数据集搜集并总结生成


