
natyu666/SoloAI-SFT-20260502-0137
收藏官方服务:
资源简介:
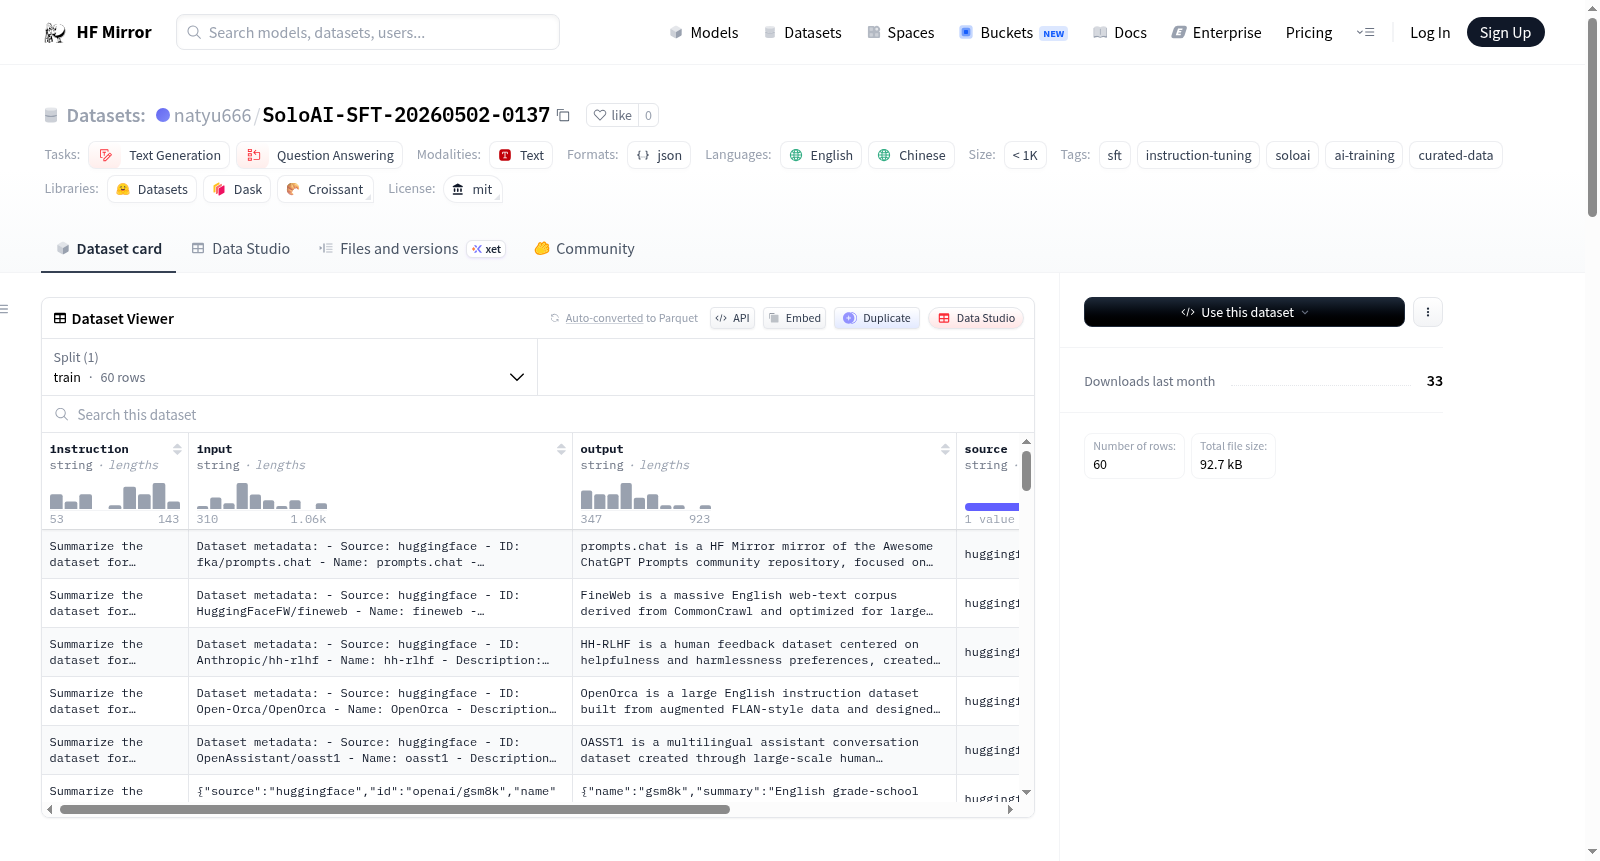
SoloAI SFT数据集是一个用于监督微调(SFT)和指令调优的多语言数据集,包含30条英文和中文数据。每条数据采用Instruction-Input-Output格式,包含任务指令、输入上下文和期望输出。数据集适用于对话型AI助手训练、提示词工程研究等场景。数据来源于HuggingFace Datasets Hub,经过AI清洗和质量过滤后发布。
The SoloAI SFT Dataset is a multilingual dataset for supervised fine-tuning (SFT) and instruction tuning, containing 30 English and Chinese data entries. Each entry follows the Instruction-Input-Output format, including task instructions, input context, and expected output. The dataset is suitable for scenarios such as training conversational AI assistants and prompt engineering research. The data is sourced from HuggingFace Datasets Hub, processed through AI cleaning and quality filtering before release.
提供机构:
natyu666搜集汇总
数据集介绍
构建方式
该数据集由SoloAI自动化数据管道构建而成,首先从HuggingFace Datasets Hub中筛选高质量数据集,随后通过AI清洗流程将其转化为标准的指令微调格式(Instruction-Input-Output),最后经过严格的质量过滤与审核后发布。整个流程旨在确保数据源的可靠性与格式的规范性,为后续的模型微调提供坚实基础。
使用方法
用户可直接加载数据集中的JSON格式样本,将instruction、input和output字段分别作为模型微调时的用户指令、可选背景信息与标准答案。该数据适用于HuggingFace Transformers、PyTorch等主流框架的SFT流程,既可用于完整微调任务,也可作为少数样本示例嵌入到few-shot评估或prompt优化研究中。
背景与挑战
背景概述
在大型语言模型(LLM)领域,指令微调(Supervised Fine-Tuning, SFT)已成为提升模型对话能力与任务执行精度的关键技术路径。SoloAI-SFT-20260502-0137数据集由SoloAI团队于2026年5月2日构建发布,面向多语言(英文与中文)的指令调优研究。该数据集通过自动化数据管道从HuggingFace Datasets Hub中筛选高质量原始数据,经AI清洗与格式转换后形成30条精心整理的Instruction-Input-Output三元组。其核心研究问题聚焦于如何为对话型AI助手提供高质量、标准化的监督微调样本,以推动Prompt Engineering、多语言AI训练等应用的发展。作为小规模但高度精选的SFT数据集,它为开发者探索指令调优的底层机制提供了可复现的实验基础。
当前挑战
该数据集所解决的领域挑战在于,当前公开的指令数据集普遍存在质量参差不齐、格式不统一、多语言支持薄弱等问题,限制了LLM在下游任务中泛化能力的提升。直接从社区平台获取的原始提示数据往往包含噪声、冗余信息或缺失结构化字段,难以直接用于高效微调。在构建过程中,SoloAI团队需应对数据清洗的挑战,即从数万条原始记录中自动识别并筛选出高质量的指令-输入-输出对齐样本,同时确保数据覆盖英文与中文场景,避免语言偏见。此外,面对仅有30条小规模样本的限制,如何设计数据管道以在极低数据量下保持数据多样性与代表性,成为平衡质量与规模的另一核心难题。
常用场景
经典使用场景
SoloAI-SFT-20260502-0137数据集专为大型语言模型的指令微调(Instruction Tuning)而设计,其经典使用场景在于训练对话型AI助手。通过提供30条精心构造的Instruction-Input-Output三元组,该数据集能够帮助模型学习如何理解自然语言指令、结合上下文信息生成精准回答。在提示工程研究领域,研究者可借助其中英双语数据深入分析提示词结构对模型输出的影响,优化Prompt设计策略。此外,数据集还可用于评估模型在多语言环境下的指令遵循能力,为后续模型迭代提供基准测试基础。
解决学术问题
在学术研究中,该数据集有效解决了小型高质量SFT数据匮乏的问题,为指令调优方法的验证提供了标准化样本。它帮助研究者探讨在有限数据量下模型泛化能力的边界,以及指令格式对学习效率的影响。通过对比不同模型在同一指令集上的表现,学者可量化分析模型架构差异与指令理解能力的关系。同时,数据集中包含的多语言条目支持跨语言迁移学习的研究,为构建统一的多模态对话系统奠定数据基础,推动了低资源场景下指令调优理论的完善。
实际应用
实际应用中,该数据集可作为快速原型开发的测试平台,帮助开发者低成本验证模型在特定任务上的表现。企业可利用其对内部聊天机器人进行初步校准,提升客服系统的回答质量。对于提示工程从业者,数据集提供了真实案例用于演练Prompt调优技巧。教育领域可将其引入课程,作为学生理解监督微调流程的实践素材。此外,数据集的清洁格式使其易于集成到自动化数据管道中,加速从实验到部署的迭代周期。
数据集最近研究
最新研究方向
随着大语言模型(LLM)在对话系统和指令理解中的广泛应用,高质量、精标注的监督微调(SFT)数据集成为推动模型性能跃升的关键资源。SoloAI-SFT-20260502-0137 作为一款专为指令调优设计的小规模多语言数据集,聚焦于 Prompt Engineering 与多轮对话生成的前沿方向,其 Instruction-Input-Output 结构为研究细粒度指令遵循、跨语言泛化及少样本学习提供了优质范本。当前领域内,数据质量与任务的多样性正超越规模成为核心关注点,此类经自动化管道清洗与过滤的精选数据,有利于探索高效微调策略,减少对大规模原始语料的依赖,从而加速 LLM 在垂直场景中的落地,并推动社区对数据集标准化与复现性伦理的进一步反思。
以上内容由遇见数据集搜集并总结生成


