
AISNP/ChestMNIST
收藏官方服务:
资源简介:
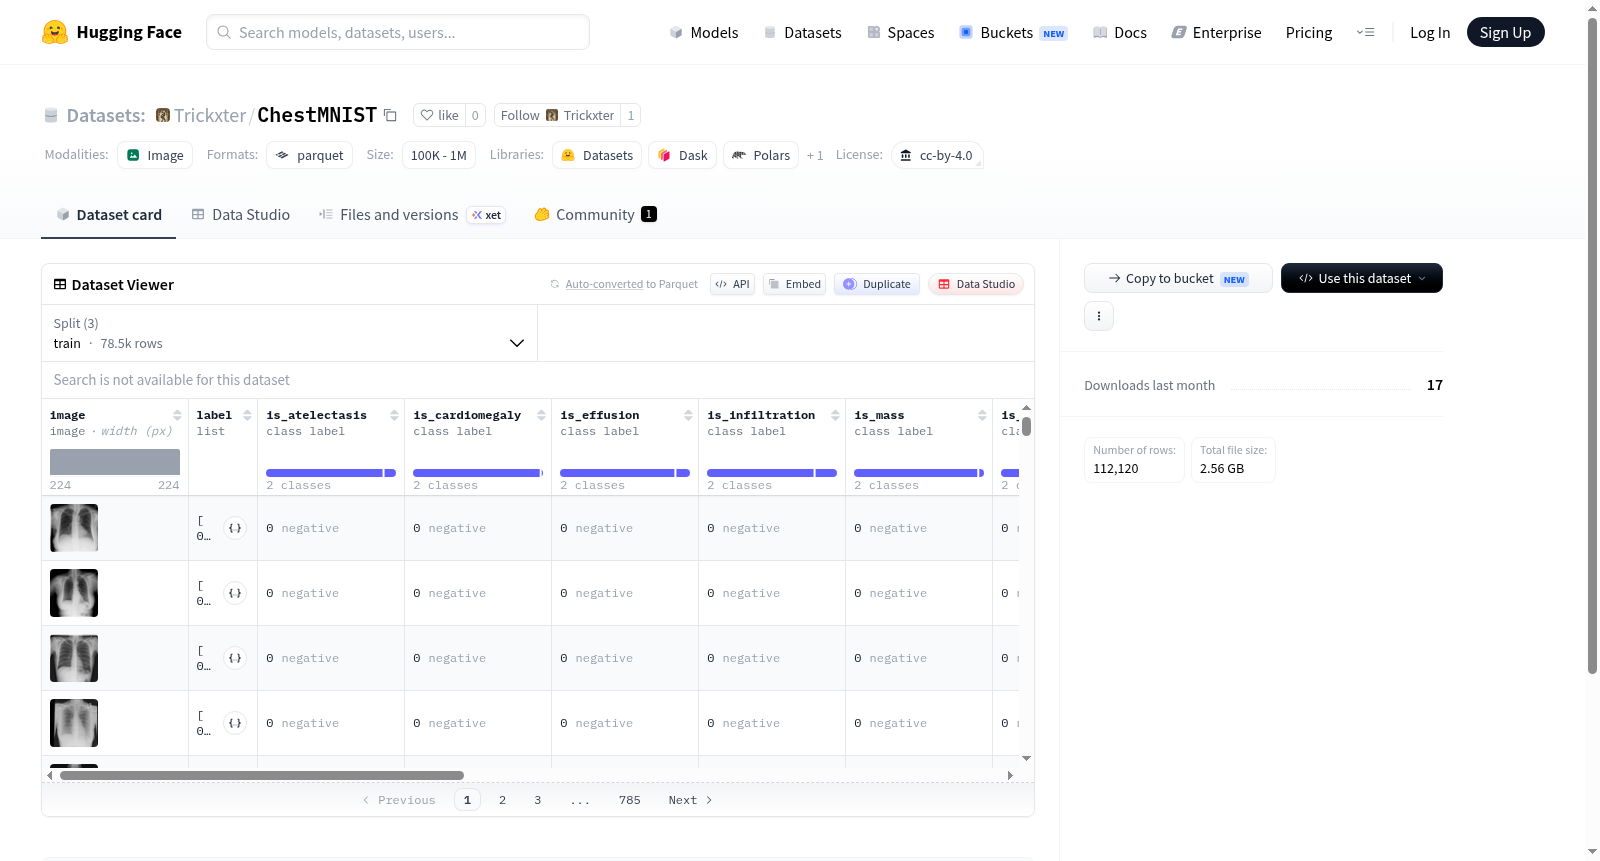
该数据集是一个医学图像数据集,包含图片及其对应的14个二分类标签,用于识别医学图像中是否存在特定的病症,如肺不张、心脏增大、胸腔积液等。数据集分为训练集、验证集和测试集,共有超过25亿字节的数据,样本数量超过11万。
This dataset is a medical image dataset containing images and their corresponding 14 binary classification labels, used to identify specific diseases in medical images, such as atelectasis, cardiomegaly, pleural effusion, etc. The dataset is divided into training, validation, and test sets, with a total of over 2.5 billion bytes of data and more than 110,000 samples.
提供机构:
AISNP搜集汇总
数据集介绍
构建方式
在胸部X光影像分析领域,多标签分类任务对疾病筛查具有重要意义。AISNP/ChestMNIST数据集基于公开的胸部X光影像资源构建,遵循CC-BY-4.0许可协议。该数据集精心划分为训练集、验证集和测试集,分别包含78468、11219和22433张影像,总计超过11万张样本。每张影像均配备14种胸部疾病标签,涵盖肺不张、心脏肥大、胸腔积液、浸润、肿块、结节、肺炎、气胸、实变、水肿、肺气肿、纤维化、胸膜病变及疝气,采用二元分类标注(阴性/阳性)。数据以图像格式存储,并通过分片文件高效组织,便于分布式加载与处理。
特点
该数据集的核心特色在于其多标签标注体系,每张影像同时关联14种疾病的独立标签,而非单一类别,这使其能够支持复杂的共病识别任务。标签分布均衡,涵盖从常见病症(如浸润、胸腔积液)到罕见病变(如疝气)的广泛谱系,为模型泛化能力提供充分考验。数据规模庞大,训练集样本量近8万,测试集超2.2万,确保模型评估的统计可靠性。此外,数据集采用标准化的HuggingFace格式,集成图像与标签字段,并预设了明确的拆分比例,便于研究者直接用于监督学习场景。
使用方法
使用者可通过HuggingFace Datasets库轻松加载该数据集,指定配置名称为'default'后,自动获取train、validation和test三个拆分。加载后的数据包含'image'字段(PIL图像对象)和'label'字段(14维向量,对应各疾病标签),以及每个疾病的独立布尔字段(如is_atelectasis)。典型应用流程包括:利用transformers库的预训练视觉模型进行特征提取,将图像输入后与多标签损失函数(如二元交叉熵)结合训练;或使用PyTorch的DataLoader进行批量迭代。数据集已自动划分,无需额外拆分,可直接用于模型微调与性能基准测试。
背景与挑战
背景概述
胸部X光影像作为临床诊断肺部疾病的核心手段,其自动化分析对提升医疗效率与准确性具有重大意义。ChestMNIST数据集由多个研究机构联合创建,旨在为多标签胸部疾病分类任务提供标准化基准。该数据集整合了14种常见胸部病理标签,包括肺不张、心脏肥大、胸腔积液等,覆盖了从感染性病变到结构性异常的广泛范畴。其发布不仅推动了计算机辅助诊断系统在胸片分析中的发展,更成为评估深度学习模型在医学影像多标签分类性能上的重要参考,对促进人工智能在放射学领域的应用产生了深远影响。
当前挑战
该数据集面临的核心挑战在于多标签分类中标签共现与类别不平衡问题,例如肺炎与浸润性病变常同时出现,而疝气等病征样本稀少,导致模型难以学习判别性特征。构建过程中,从原始影像中精确提取14种病理标签需依赖临床专家标注,然而不同标注者间的一致性控制与罕见病例的标注覆盖成为显著难题。此外,影像来源于不同设备与采集参数,引入的域偏移进一步增加了模型泛化的难度,要求算法在兼顾细粒度特征的同时具备鲁棒性,以应对真实临床场景的复杂性。
常用场景
经典使用场景
在医学影像分析领域,ChestMNIST数据集以其多标签胸部X光片分类任务而著称。该数据集源自NIH ChestX-ray14,经过精心预处理后,每张图像对应14种常见胸部疾病的二元标签,包括肺不张、心脏肥大、胸腔积液等。研究者可基于此构建深度学习模型,同时预测多种病理状态,从而评估模型在复杂多标签场景下的泛化能力与诊断精度。这一经典用法为计算机辅助诊断系统的性能验证提供了标准化基准。
解决学术问题
ChestMNIST数据集的提出旨在解决胸部X光片自动解读中的多标签分类难题,推动弱监督学习与多任务学习在医学图像分析中的理论发展。它帮助研究人员攻克了数据不平衡、标签噪声及特征重叠等学术挑战,通过提供大规模、高质量的训练样本,支持了从单标签到多标签诊断范式的跨越。该数据集的意义在于降低了医学影像AI研究的准入门槛,促进了可复现性实验与算法公平比较,对提升全球公共卫生领域的疾病筛查效率具有深远影响。
衍生相关工作
ChestMNIST数据集衍生了一系列经典研究工作,包括基于注意力机制的CheXNet模型、多尺度特征融合的DenseNet架构以及用于解释性诊断的Grad-CAM可视化方法。这些工作进一步探索了从图像级标签到像素级定位的迁移学习策略,催生了如CheXpert和MIMIC-CXR等更大型数据集的构建标准。此外,该数据集还被用作对抗训练和联邦学习等前沿技术的验证平台,推动了医学AI在隐私保护与鲁棒性方面的理论创新。
以上内容由遇见数据集搜集并总结生成


