遇见数据集

gooshkon-chunks

收藏
Hugging Face2026-09-06 更新2026-09-07 收录
官方服务:

资源简介:

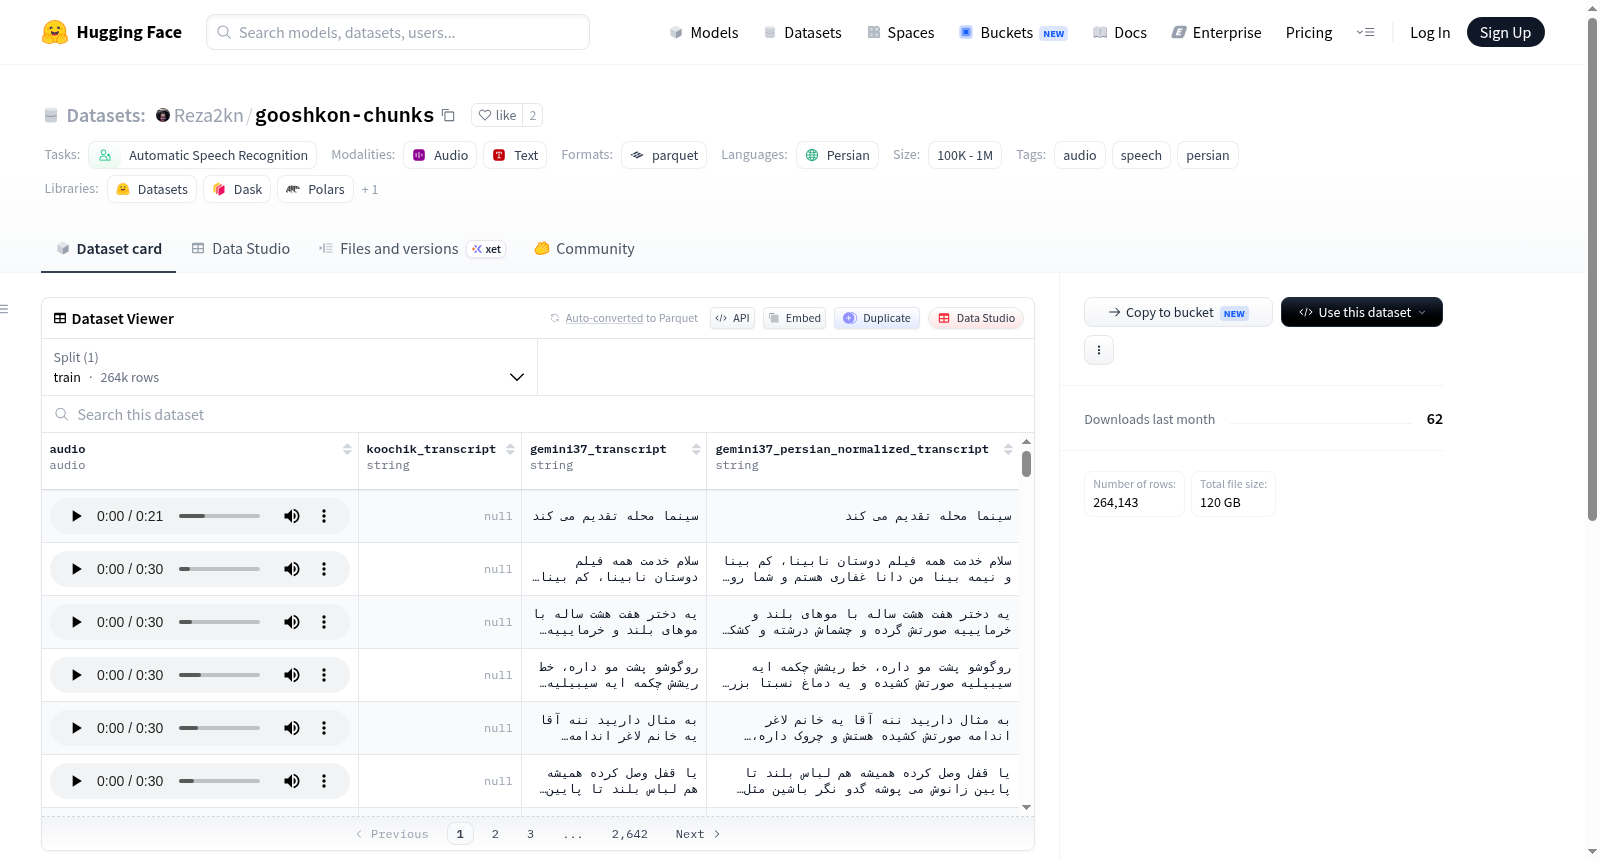
Gooshkon MP3 chunks 是一个面向波斯语自动语音识别(ASR)任务的音频数据集。该数据集包含嵌入的 MP3 格式音频片段,每个片段时长约为30秒,基于检测到的安静间隔进行切分,安全范围在12至48秒之间。数据集中每个样本包含四个字段:音频文件(audio)、来自 Koochik 的转录文本(koochik_transcript)、来自 Gemini 3.7 的转录文本(gemini37_transcript)以及经过波斯语归一化处理的 Gemini 3.7 转录文本(gemini37_persian_normalized_transcript)。需要注意的是,源录音与转录本并非严格对齐,而是利用声学静默边界来避免切分单词,从而尽可能保留语音的完整性。该数据集可用于训练和评估波斯语语音识别模型。

Gooshkon MP3 chunks is an audio dataset for Persian automatic speech recognition (ASR) tasks. The dataset contains embedded MP3 audio chunks, each approximately 30 seconds long, segmented based on detected silence intervals with a safe range of 12 to 48 seconds. Each sample includes four fields: audio file, transcript from Koochik, transcript from Gemini 3.7, and the Gemini 3.7 transcript normalized for Persian. Note that the source recordings and transcripts are not strictly aligned; instead, acoustic silence boundaries are used to avoid splitting words, preserving speech integrity as much as possible. This dataset can be used for training and evaluating Persian speech recognition models.

创建时间:
2026-08-31
原始信息汇总

数据集概述

名称:Gooshkon MP3 chunks
标签:音频、语音、波斯语
任务类别:自动语音识别(Automatic Speech Recognition)
语言:波斯语(fa)

数据集特点

  • 数据集格式为 Hugging Face 音频数据集,为单列结构。
  • 每一行数据在 audio 列中包含可嵌入、可播放的 MP3 音频字节。
  • 音频片段目标时长约为 30 秒,选择在检测到的静音区间进行切分,安全范围为 12–48 秒

数据字段

字段名 数据类型 说明
audio 音频 包含音频文件内容
koochik_transcript 字符串 Koochik 转录文本
gemini37_transcript 字符串 Gemini 3.7 转录文本
gemini37_persian_normalized_transcript 字符串 Gemini 3.7 转录文本的波斯语规范化版本

处理说明

  • 源录音并未与转录文本进行对齐。
  • 本次发布使用声学静音边界进行切分,以便在存在可用停顿时避免切割单词。
搜集汇总
数据集介绍
gooshkon-chunks 数据集图片
构建方式
该数据集的构建根植于语音信号处理中的静音检测技术,旨在解决非对齐音频的切分难题。具体而言,开发团队从3,497个可用源文件中,依据声学静音边界精心选取约30秒的音频片段,并设置了12至48秒的安全范围,以确保切割点不会横跨词汇,从而保障了语音的完整性。鉴于源录音未与文本转录对齐,该构建策略巧妙地利用自然停顿,实现了音频与后续自动语音识别任务的适配。最终,数据集囊括了约2,217.6小时的音频内容,覆盖了波斯语的广泛语音现象。
特点
该数据集的核心特色在于其高度工程化的音频处理流程与明确的任务导向性。嵌入的MP3音频字节以单列格式存储,便于直接加载与播放,大幅简化了数据迭代流程。片段时长精准控制在约30秒,兼顾了ASR模型对输入长度的偏好与计算效率。尤为引人注目的是,数据集提供了三种转录文本:原始转录、经过Gemini 3.7增强的转录及其波斯语归一化版本,这为后续的多层次语音研究,如鲁棒性分析或文本后处理评估,提供了宝贵资源。此外,对于运行时长的精确统计,也体现了开发者对数据质量的严谨态度。
使用方法
使用时,研究人员可通过Hugging Face datasets库轻松加载该数据集,每一步均包含可直接用于训练的音频特征与对应的文本标签。推荐将'audio'列作为模型输入,并根据研究目标选择恰当的转录列:对于标准ASR任务,可采用'gemini37_persian_normalized_transcript'以保证文本的一致性;若需探究模型对口语化文本的适应性,则可选用原始的'koochik_transcript'。鉴于数据集规模庞大,建议利用Hugging Face的流式模式或分片加载以优化内存管理,并可将音频特征提取为梅尔频谱等表征以适配主流语音识别架构。
背景与挑战
背景概述
在自动语音识别(ASR)领域,对非英语、低资源语言的研究长期受限于高质量音频数据集的匮乏,尤其在波斯语(波斯语族)中,缺乏大规模且易于获取的语音资源严重阻碍了模型的泛化能力与实用化进程。为弥合这一鸿沟,由研究团队于近期构建的“Gooshkon MP3 chunks”数据集应运而生,其名称蕴含“听觉”之意,旨在为波斯语ASR提供坚实的基础。该数据集汇集了约2,217.6小时(相当于92.4天)的连续语音,源自3,497个可用源文件,利用静音检测技术将长音频切分为约30秒的片段,以确保语音的连贯性与可训练性。该数据集的发布不仅为波斯语语音识别研究提供了大规模、可复用的训练资源,还通过公开可访问的Hugging Face平台降低了下游任务的门槛,对推动低资源语言的语音技术发展具有里程碑意义。
当前挑战
该数据集所应对的领域挑战主要源于波斯语ASR的固有难点和资源稀缺性:波斯语存在丰富的方言变体、重音模式及正式/非正式语体差异,加之缺乏大规模、转录对齐的语音语料,使得传统监督学习方法难以取得理想性能。Gooshkon MP3 chunks通过利用不易中断语义的静音边界(设定12-48秒的安全缓冲区间)进行片段切割,旨在确保每个片段内语音的完整性,从而缓解语音识别中对跨词切割的敏感性。然而,在数据集构建过程中,技术挑战同样不容忽视:源录音并未与现有转录精准对齐,此次发布仅依赖声学静音检测来界定边界,这有可能导致部分片段含有重叠或噪声尾迹,影响转录标注的质量。此外,鉴于MP3帧填充可能引发的微小时长误差,数据集的总体时长存在约0.5%的不确定性,这对需要精确时间戳的应用场景构成潜在困扰。另有一个零字节源文件被剔除,暴露出数据来源的异构性与质量问题,需谨慎进行预处理和过滤以确保最终模型训练的可靠性。
常用场景
经典使用场景
该数据集以波斯语语音为核心,提供了约2217.6小时的音频片段,每段时长约为30秒,并通过静音检测技术精准切分,确保语音完整无切割。其典型应用场景是自动语音识别(ASR)模型的训练与评估,尤其适用于波斯语的端到端语音识别系统。研究者可直接利用其音频和转写文本进行监督学习,或结合多版本转写进行噪声鲁棒性研究。
实际应用
实际应用中,该数据集可支撑波斯语智能语音助手、实时语音转写服务、会议记录生成等产品的开发。企业可利用其训练高精度ASR模型,应用于客服语音分析、语音搜索、字幕生成等场景。此外,多版本转写可辅助语音翻译和跨语言信息检索系统的构建。教育领域也可用于波斯语发音评测或听力材料生成,推动语言学习工具的智能化。
衍生相关工作
基于该数据集,衍生出众多相关研究,例如波斯语预训练语音模型的微调与评估、端到端ASR中的数据增强策略、静音检测与语音分段算法的改进。其多转写结构也催生了文本规范化与逆规范化的对比研究,以及多任务学习在ASR和语音翻译中的联合优化。开源特性使其成为语音社区基准测试的组成部分,带动了波斯语语音识别、说话人验证及语音事件检测等方向的纵深研究。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务