zixianma/mnms
收藏资源简介:
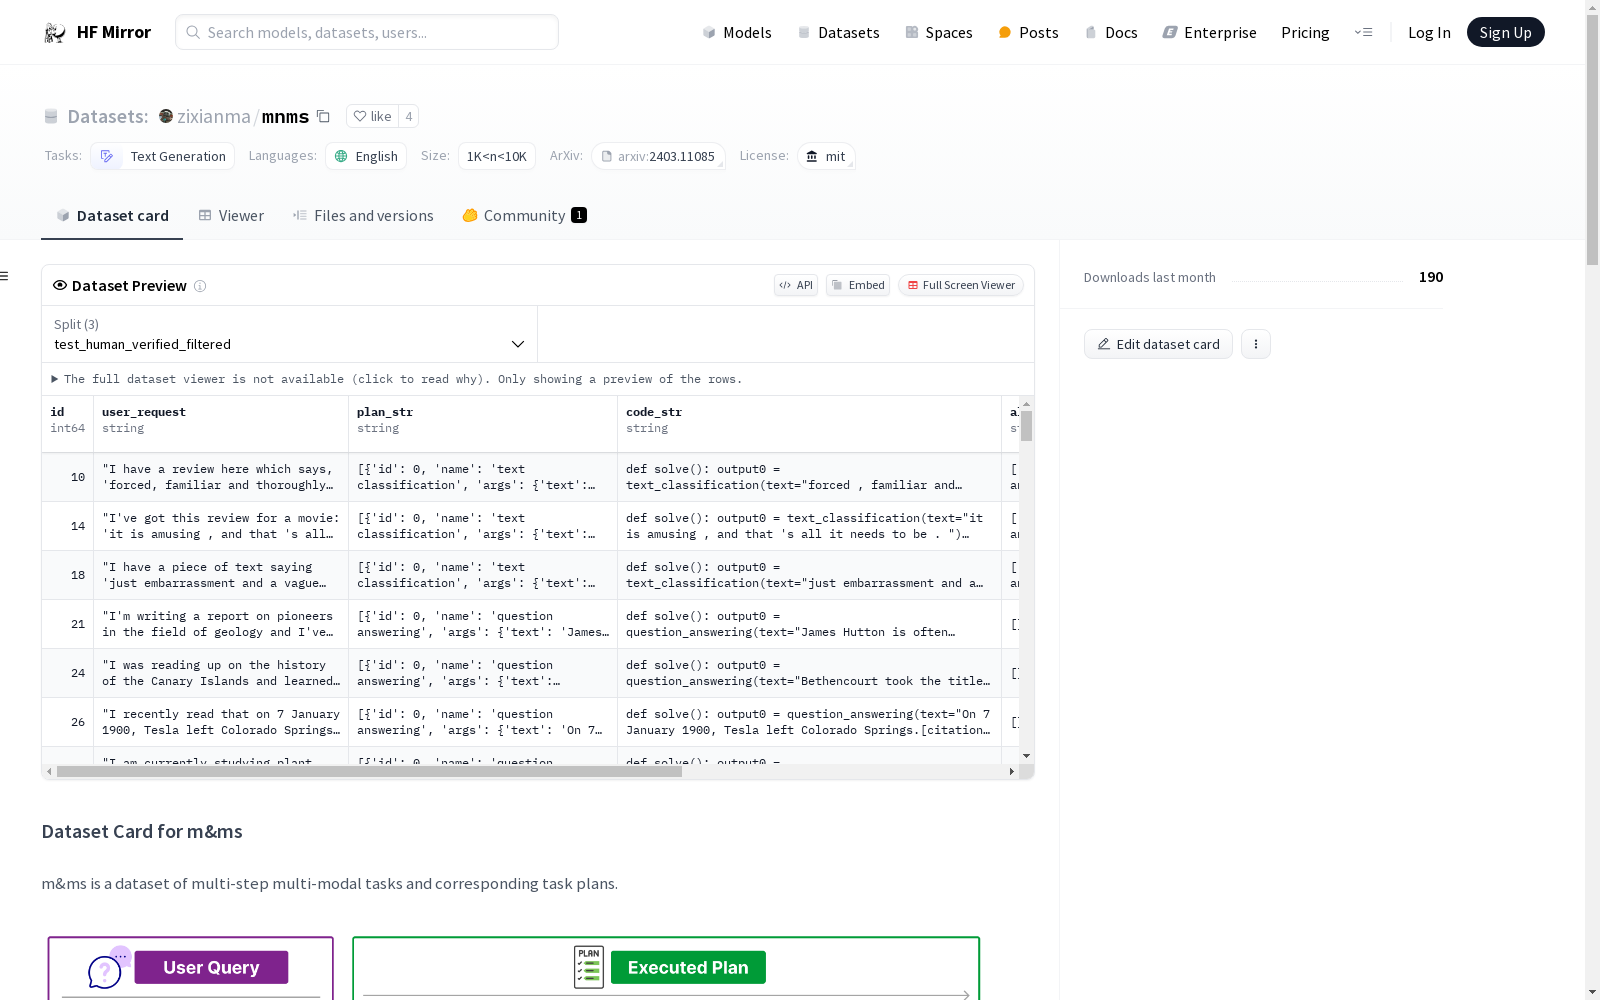
m&ms数据集包含4,000多个多步多模态任务,涉及33种工具,包括13种多模态模型、9种公共API和11种图像处理模块。对于每个任务查询,数据集提供了使用这些工具自动生成的任务计划。此外,数据集还提供了一个高质量的子集,包含1,565个人工验证的任务计划和882个人工验证、过滤且可正确执行的计划。该数据集主要用于评估大型语言模型(LLM)代理在多步多模态任务中的工具使用能力。
The M&Ms Dataset contains over 4,000 multi-step multimodal tasks involving 33 tools, including 13 multimodal models, 9 public APIs, and 11 image processing modules. For each task query, the dataset provides automatically generated task plans using these tools. Additionally, the dataset offers a high-quality subset consisting of 1,565 manually verified task plans and 882 plans that have been manually verified, filtered, and proven to execute correctly. This dataset is primarily used to evaluate the tool utilization capabilities of large language model (LLM) agents in multi-step multimodal tasks.
数据集概述
数据集名称: m&ms
数据集描述: m&ms是一个包含多步骤多模态任务及其对应任务计划的数据集。该数据集包含超过4,000个多步骤多模态任务,涉及33种工具,包括13种多模态模型、9个公共API和11个图像处理模块。此外,还提供了一个高质量的1,565个人工验证的任务计划和882个人工验证、过滤并可正确执行的计划。
数据集用途: 该数据集旨在评估大型语言模型(LLM)代理在多步骤多模态任务中使用工具的能力。
数据集文件:
test_human_verified_filtered.jsontest_human_verified.jsontest_raw.json
数据集语言: 英语 (en)
数据集规模: 1K<n<10K
许可证: MIT
数据集详细信息
任务类别: 文本生成
数据集来源:
数据集生成: 数据输入来自多个现有数据集,包括ImageNet, sst2, SQUAD, C4, CNN daily news, COCO, COCO-Text v2.0, GQA, Visual Genome, MagicBrush, 和librispeech。
数据集限制
- 用户请求可能存在偏差,因为它们是由GPT-4生成的,并不一定代表真实世界的用户请求。
- 任务计划都是顺序的,需要1-3个工具来解决。
引用信息
BibTeX:
@misc{ma2024mms, title={m&ms: A Benchmark to Evaluate Tool-Use for multi-step multi-modal Tasks}, author={Zixian Ma and Weikai Huang and Jieyu Zhang and Tanmay Gupta and Ranjay Krishna}, year={2024}, eprint={2403.11085}, archivePrefix={arXiv}, primaryClass={cs.CV} }