遇见数据集

华夏地名谱 TopoScholar

收藏
github2026-07-16 更新2026-07-19 收录
官方服务:

资源简介:

华夏地名谱是一个面向Agent、RAG和地名研究的中国地名知识底座,不只保存有哪些地名,还要持续回答这个地名为什么这么叫。项目已建立省、市、县、乡镇/街道、村/社区五级基础库,并系统化补齐每个地名的由来、含义、历史沿革、旧称和证据来源,形成一个可查询、可消歧、可溯源、可扩展的中文地名知识系统。

Huaxia Geographic Name Catalogue is a Chinese geographic name knowledge base oriented to AI Agents, Retrieval-Augmented Generation (RAG) and geographic name research. It not only stores the names of geographic locations, but also continuously provides answers to the reasons behind the naming of each place. The project has established a five-level basic database covering provinces, prefecture-level cities, counties, towns/streets, and villages/communities, and systematically supplemented the origin, meaning, historical evolution, former names and supporting evidence sources of each geographic name, thus forming a Chinese geographic name knowledge system that supports query, disambiguation, traceability and extensibility.

创建时间:
2026-07-10
原始信息汇总

数据集概述:华夏地名谱 (TopoScholar)

华夏地名谱是一个面向 Agent、RAG 和地名研究的中文地名知识数据集,旨在系统化记录中国地名的由来、含义、历史沿革等信息,形成一个可查询、可消歧、可溯源、可扩展的知识系统。

数据规模与组成

数据集包含五级基础地名库及知识表,当前进度如下:

模块 当前规模
基础地名 places 665,276
行政层级边 admin_edges 665,245
别名索引 place_aliases 2,981,225
地名由来知识 place_knowledge 3,209
由来采集队列 collection_queue 3,227
基础层级 数量
省级 31
地级 342
县级 2,978
乡镇/街道级 41,352
村/社区级 620,573

核心能力

  • 五级地名底座:覆盖省、市、县、乡镇/街道、村/社区,支持按行政代码下钻或回溯上级。
  • 别名与消歧:支持模糊查询与常见后缀匹配,可通过省、市、县、层级约束缩小同名结果。
  • 地名由来知识表:结构化存储地名的由来、含义、历史沿革、旧称、来源及置信度。
  • Agent / MCP 友好:提供 JSON CLI 和 MCP Server 工具,支持地名解析、别名解析、行政下级查询、同名地名对比、由来查询、知识检索等。

数据来源

已接入或规划的数据源包括:

  • modood/Administrative-divisions-of-China:五级行政区划基础 CSV。
  • xiangyuecn/AreaCity-JsSpider-StatsGov:四级行政区划补充数据。
  • 中国·国家地名信息库:地名由来、含义、历史沿革的按需补齐来源。
  • 地方政府网站、地方志、地名志。
  • OpenStreetMap/Geofabrik(后续规划)。

当前限制

  • 五级基础底表主要为 2023 年统计口径,不完全等同于最新民政/地名库口径。
  • “街道”当前指行政街道办事处,非道路街巷。
  • 港澳台未纳入当前五级主表。
  • 地名由来知识库仍在持续采集中。
  • 国家地名信息库的数据使用需注意限速与授权。
搜集汇总
数据集介绍
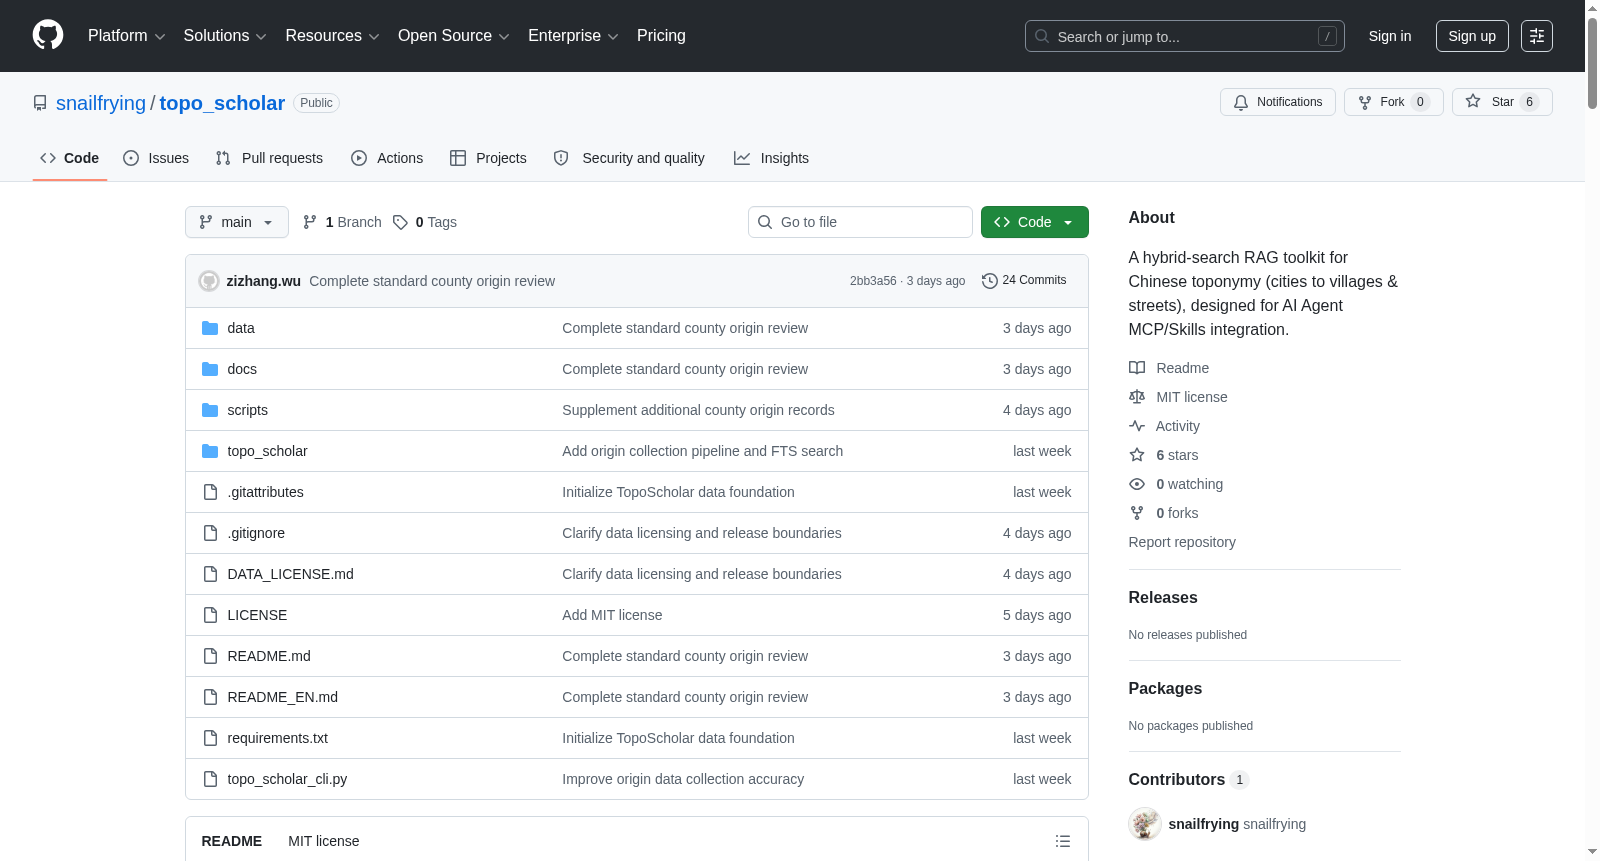
华夏地名谱 TopoScholar 数据集图片
构建方式
华夏地名谱(TopoScholar)以公开行政区划数据为基础,构建省、市、县、乡镇/街道、村/社区五级基础地名库。通过集成modood和xiangyuecn等开源项目的CSV数据,生成统一的places、admin_edges和place_aliases表,并利用place_knowledge表系统化存储地名由来、含义、历史沿革等结构化知识。项目内置保守的采集流水线,先构建采集队列,再限速从国家地名信息库等地按需补齐地名由来,同时保留候选审计记录以避免错配。最终数据被整合为SQLite数据库,支持CLI和MCP Server调用。
使用方法
用户可通过CLI工具直接查询,如使用`python topo_scholar_cli.py resolve 武汉市 --province 湖北省`进行地名消歧,或通过`alias`、`children`、`same-name`、`origin`等命令执行别名解析、下级查询、同名分布及由来检索。项目支持显式重建数据库,运行`build_places.py`等脚本即可从原始数据重新构建。高级应用可启动MCP Server,通过`pip install -r requirements.txt`后运行`python -m topo_scholar.mcp_server`,利用预留的10个工具如`resolve_place_name_tool`等与Agent系统集成。
背景与挑战
背景概述
中国地名蕴藏着丰富的历史沿革、民族文化与地理变迁信息,然而现有行政区划数据仅能提供空间位置,难以揭示地名背后的深层含义。为弥合这一鸿沟,华夏地名谱(TopoScholar)项目于2024年由独立研究者发起,旨在构建一个面向智能体(Agent)、检索增强生成(RAG)与地名学研究的结构化知识底座。该项目系统整合了省、市、县、乡镇/街道、村/社区五级共计逾66万个基础地名,并逐步录入地名由来、含义、旧称等知识条目,目前已积累三千余条可信知识记录。华夏地名谱通过提供别名消歧、行政层级查询、同名地名对比等核心功能,不仅服务于学术研究,更成为智能问答系统与地理信息应用的重要数据支撑,对推动中文地名知识的数字化与智能化利用具有开创性意义。
当前挑战
该数据集面临的挑战主要来自三个方面。其一,领域层面上,中国地名普遍存在大量同名异址、异名同址及历史沿革复杂等问题,例如“南高村”在全国多地重复出现,普通查询极易产生歧义,如何实现高效且精准的消歧是核心难题。其二,构建过程中,地名由来知识的采集与验证高度依赖中国国家地名信息库等外部来源,这些站点通常限速且结构不一,大规模自动化采集易受访问限制,同时还需人工介入复核与补录,当前县级由来数据仍有20条待多方校验,乡镇级来源更是尚未系统发掘。其三,数据动态性挑战显著,行政区划会随撤并、更名、代码调整而频繁变动,而现有基础底表主要基于2023年统计口径,难以实时同步最新民政数据,维护版本演进的差异表成为长期任务。
常用场景
经典使用场景
华夏地名谱TopoScholar作为一座系统化的中文地名知识底座,其经典用途在于为自然语言处理与地理信息检索提供精细化的五级地名消歧与层级解析能力。该数据集整合了省、市、县、乡镇/街道、村/社区共计超过66万个基础地名,辅以近300万条别名索引,能够有效应对中文地名中普遍存在的同名异指、简称混用和行政层级模糊等难题。研究者可借助其结构化查询接口,快速实现地名标准化解析、行政归属追溯与上下级关系遍历,从而为地名知识图谱构建、地理实体链接以及地理问答系统提供坚实的数据支撑。
解决学术问题
该数据集系统性地回应了中文地名研究中长期存在的三个核心学术问题:地名由来知识的结构化缺失、跨层级地名的消歧困难以及地名历史沿革的数字化空白。通过构建涵盖省级至村级的地名由来知识表,并附有来源标题、证据摘要与置信度标注,TopoScholar将零散分布于地方志与地名信息库中的历史文化信息转化为可查询、可复现的结构化数据。这不仅为计算语言学中的地名实体识别与关系抽取提供了高质量的训练基准,也为历史地理学中关于地名演变、行政区划变迁及屯垦迁徙模式的研究开辟了定量分析的路径。
实际应用
在实际应用层面,TopoScholar展现出显著的工程价值,尤其适用于智能代理与检索增强生成系统的部署场景。通过提供MCP Server与JSON CLI接口,该数据集使得大型语言模型能够可靠地执行地名解析、别名消歧和由来知识检索等细粒度工具调用。在政务智能问答、地理信息导航、地名文化普及以及新闻事件的地域关联分析中,开发人员可以依托其保守的采集流水线与可审计的置信度机制,有效抑制模型在地名问题上常见的幻觉现象,从而构建更加准确且可溯源的智能化信息服务管线。
数据集最近研究
最新研究方向
在地理信息科学与数字人文交叉领域,华夏地名谱TopoScholar聚焦于构建可查询、可消歧、可溯源的中文地名知识底座,其前沿研究方向体现为面向大语言模型Agent与RAG系统的地名解析与溯源能力。该数据集不仅收录超过66万条五级行政区划基础地名,更系统化采集了各省、市、县的地名由来与历史沿革,通过别名索引与消歧机制解决同名地名误判问题,并支持按需补齐与知识检索。这一工作紧密关联当前AI落地的热点事件——即大模型在中文场景中频繁出现地名编造与坐标幻觉的困境,TopoScholar通过结构化知识表和MCP Server接口,为Agent提供了可靠的地名知识工具,显著降低地名问答中的错误率,对推动地理知识库在智能体应用中的可信度提升具有深远意义。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务