
AndyVampiro/Patricia_Windsor_V1
收藏官方服务:
资源简介:
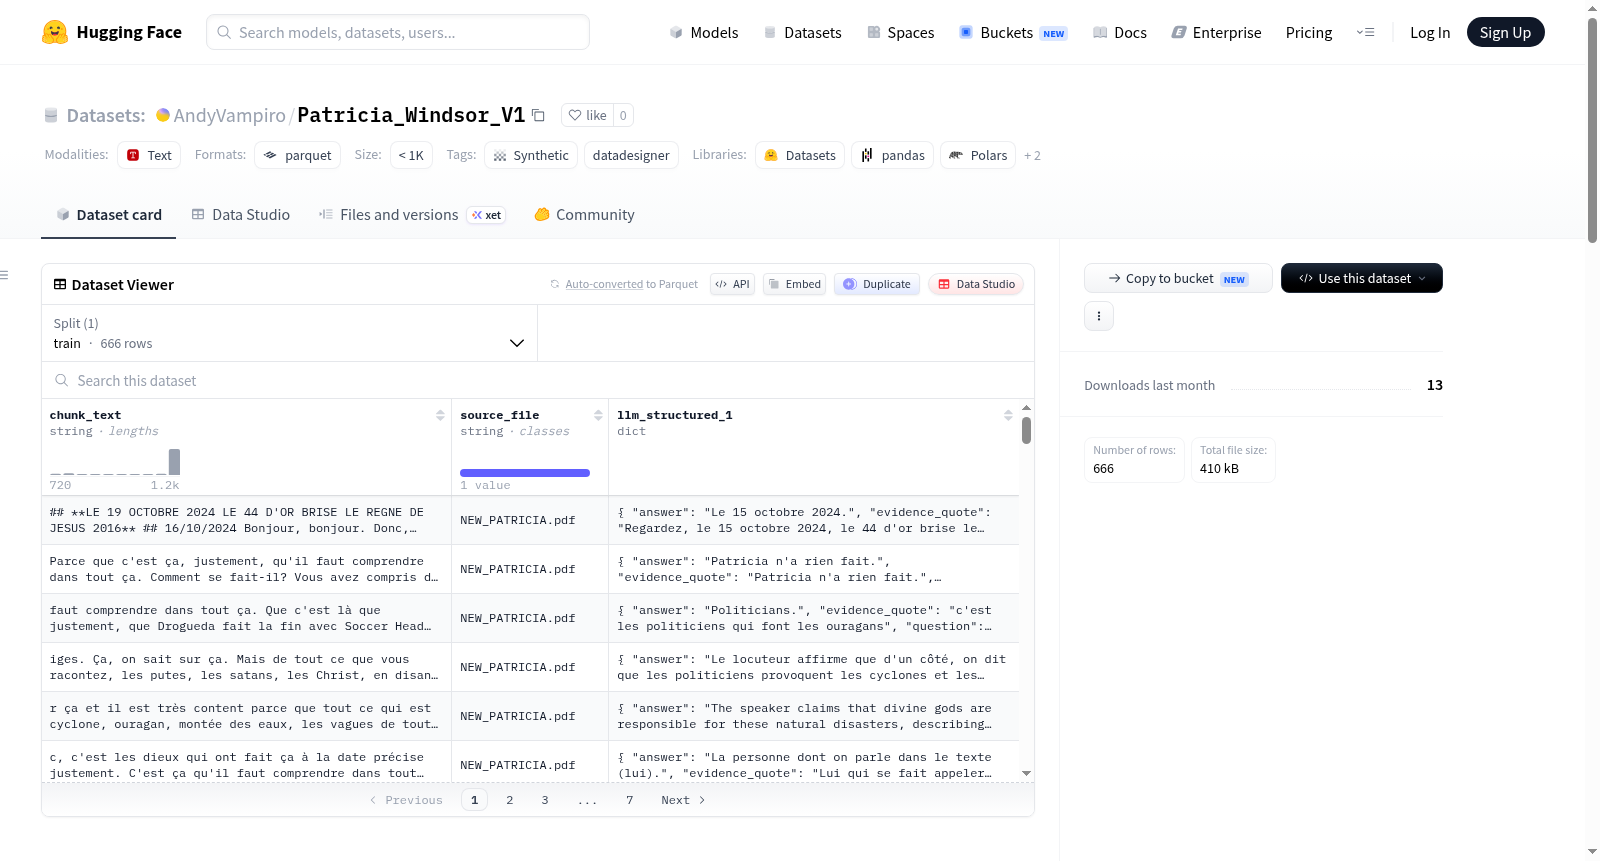
Patricia Windsor V1 使用 Unsloth Recipe Studio 生成。它包含 666 条生成的记录。
Patricia Windsor V1 was generated with Unsloth Recipe Studio. It contains 666 generated records.
提供机构:
AndyVampiro搜集汇总
数据集介绍
构建方式
该数据集名为Patricia Windsor V1,由NVIDIA NeMo Data Designer框架通过Unsloth Recipe Studio生成,属于合成数据集(synthetic)。其构建过程依托于配置化的数据生成机制,包含3列配置,其中1列为llm-structured类型,由大语言模型驱动生成;其余2列源自种子数据集(seed-dataset),通过统计采样或依赖关系控制实现字段间的关联。数据集共生成666条记录,存储为Parquet格式,便于高效加载与处理。
特点
Patricia Windsor V1数据集的核心特点在于其高度结构化的合成数据属性,记录数为666,包含3个字段,其中llm_structured_1列为字典类型,显示99.8%的唯一性,零缺失值,体现了生成过程的高质量与低冗余。此外,该数据集具有明确的依赖感知生成与质量验证机制,支持LLM-as-a-judge评分,确保了数据的一致性与可靠性,适用于需要多样化、低噪声合成数据的场景。
使用方法
使用该数据集极为简便,推荐通过HuggingFace的datasets库加载:调用load_dataset("AndyVampiro/Patricia_Windsor_V1", "data", split="train")即可获取训练集,并支持一键转换为pandas DataFrame以进行后续分析。数据集采用Parquet格式,能高效处理大规模数据操作。用户还可参考附带的builder_config.json与metadata.json文件,深入了解生成配置与元数据,便于复现或调整生成流程。
背景与挑战
背景概述
Patricia_Windsor_V1数据集由AndyVampiro于2026年基于NVIDIA NeMo Data Designer框架生成,旨在探索合成数据在小规模场景下的应用潜力。该数据集仅包含666条记录,核心研究问题聚焦于利用LLM驱动的生成工具(如Unsloth Recipe Studio)创建结构化数据,并验证其在低资源环境中的有效性。作为合成数据领域的早期探索,其为后续研究提供了基准参考,并展示了数据设计器在快速原型开发中的价值,尤其适用于对数据规模要求不高的任务。
当前挑战
该数据集面临的核心挑战是合成数据的真实性与泛化能力,即如何确保LLM生成的666条记录能准确反映现实世界的分布特征,避免引入系统性偏差。构建过程中,受限于小样本规模(<1K),数据多样性不足且易过拟合,同时依赖单一的llm-structured列配置和种子数据集可能限制字段间的语义关联性。此外,缺乏针对生成质量的量化验证标准,使得评估合成数据的实用性和鲁棒性成为关键难题。
常用场景
经典使用场景
在自然语言处理与合成数据研究的交汇处,Patricia_Windsor_V1数据集主要作为验证和测试合成数据生成框架效能的基准。该数据集由NVIDIA NeMo Data Designer框架基于Unsloth Recipe Studio生成,包含666条带有结构化字典字段的记录,典型使用场景包括评估LLM在受控条件下生成结构化输出的一致性、多样性以及字段间依赖关系的建模能力。研究人员常将其用于对比不同生成策略(如基于统计采样与基于提示生成)的输出质量差异。
实际应用
在实际应用中,Patricia_Windsor_V1展示了合成数据在数据稀疏场景下的替代能力,例如在保护隐私的前提下为商业智能分析、推荐系统冷启动、以及低资源领域的机器翻译或对话系统提供训练样本。其生成过程可复现的特性也使其适合用于企业级数据管线中合成数据质量的迭代验证,帮助团队在正式生产前快速预览与调校数据生成配置。
衍生相关工作
围绕该数据集,衍生工作在合成数据生成框架优化、LLM结构化输出评估以及依赖感知生成等领域展开。参考NVIDIA NeMo Data Designer的设计哲学,后续研究借鉴了其统计采样与种子数据混合策略,探索了如何通过Python和SQL验证器提升数据完整性。此外,基于LLM-as-a-judge的评分机制启发了多项针对合成数据质量自动评估与反馈循环的改进工作,推动了低资源场景下数据生成工具的标准化进程。
以上内容由遇见数据集搜集并总结生成


