
遇见数据集

KennyChowww/openalex-snapshot-2026-05

收藏
Hugging Face2026-05-28 更新2026-05-31 收录
官方服务:

资源简介:

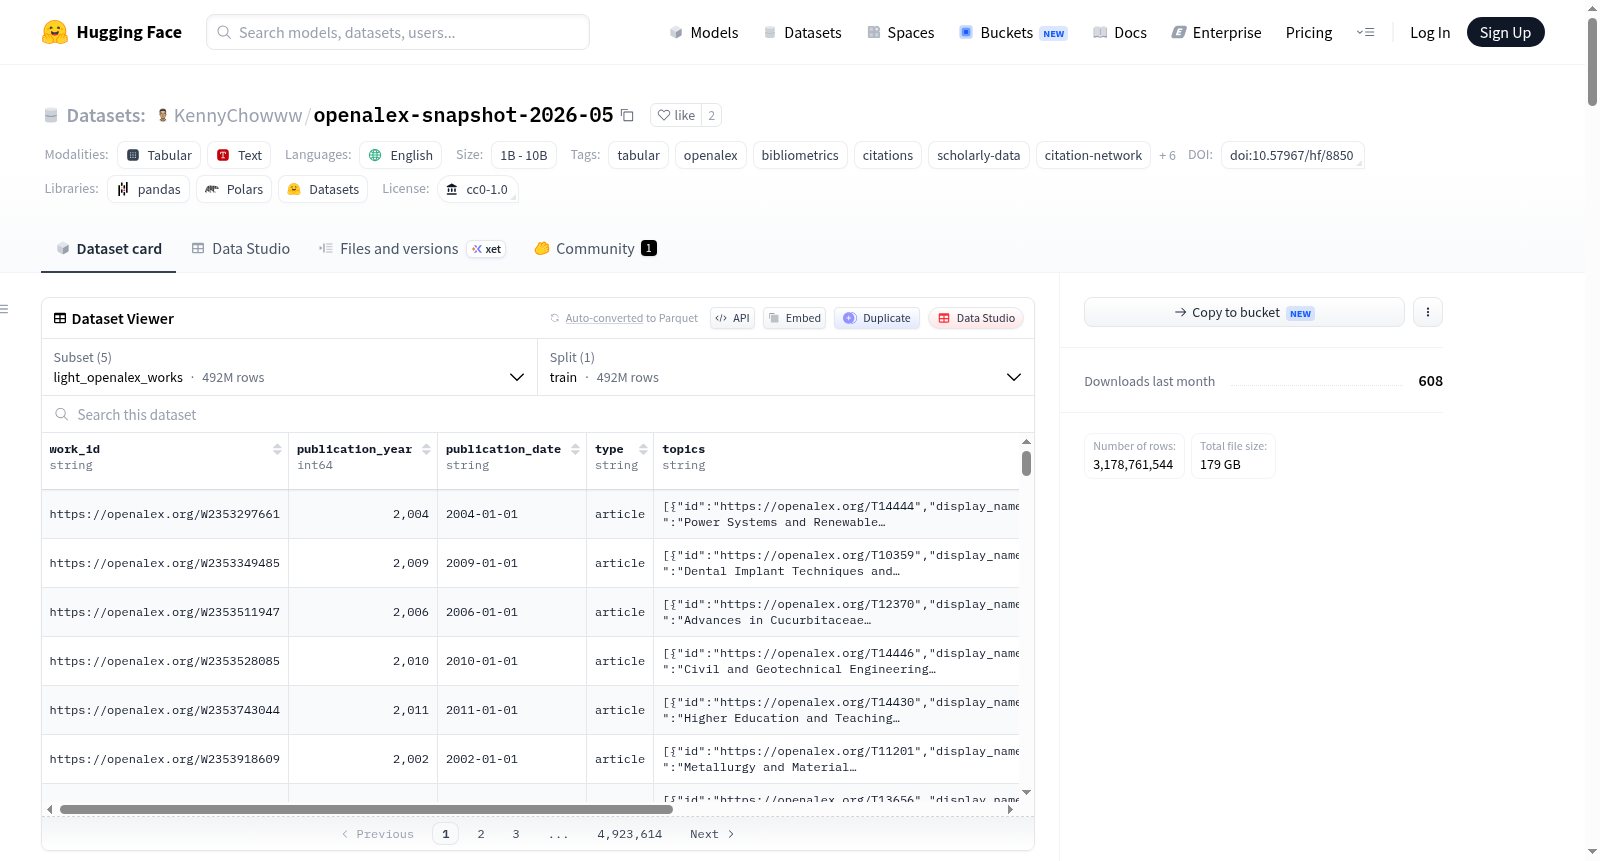
该数据集是OpenAlex 2026年5月快照的处理版本,包含处理后的作品记录和衍生引用边表,以及选定的下游文献计量数据集。它专为大规模学术元数据分析、引用网络分析和文献计量研究而设计。主要子集light_openalex_works提供了轻量级的OpenAlex作品记录,以Parquet格式分片存储,包含作品ID、出版年份、类型、主题、作者身份等关键列。其他子集包括扩展的引用边、过滤后的作品类型样本、AI领域作品样本(含机构部门信息)以及包含DI5(五年破坏指数)值的最终AI样本。数据集支持使用Hugging Face datasets库或DuckDB进行加载和查询,适用于文献计量研究、OpenAlex元数据分析、引用网络构建、破坏指数研究等领域。但需要注意的是,数据集受OpenAlex元数据覆盖范围和引用链接的限制,且衍生子集不代表所有学术作品的完整表示。

This dataset is a processed version of the OpenAlex Works snapshot from May 2026, including derived citation-edge tables and selected downstream bibliometric datasets. It is intended for large-scale scholarly metadata analysis, citation-network analysis, and bibliometric research. The main subset, light_openalex_works, contains lightweight OpenAlex Works records stored in Parquet shards, with key columns such as work ID, publication year, type, topics, and authorships. Other subsets include expanded citation edges, filtered work type samples, an AI-domain article/preprint sample enriched with institution-sector information, and a final AI sample with DI5 (five-year disruption index) values. The dataset can be loaded using the Hugging Face datasets library or queried with DuckDB, and it is useful for bibliometric research, OpenAlex metadata analysis, citation-network construction, disruption-index studies, and more. Limitations include dependencies on OpenAlex metadata coverage and citation links, and derived subsets should not be treated as complete representations of all scholarly works.
提供机构:
KennyChowww
搜集汇总
数据集介绍
KennyChowww/openalex-snapshot-2026-05 数据集图片
构建方式
在学术大数据与文献计量学领域,大规模结构化数据集是推动知识发现与科研评价的重要基础。OpenAlex Snapshot 2026-05 数据集基于 OpenAlex 在 2026 年 5 月发布的学术作品快照,经过轻量化处理与结构化重构而成。构建过程首先从原始快照中提取核心字段,形成 light_openalex_works 子集;随后将每篇作品所引用的参考文献扩展为 citing-referenced 二元组,生成 citation_edges 边表,并过滤掉不在作品宇宙中的悬挂节点。在此基础上,进一步筛选出类型为文章、预印本与书籍的作品,并针对人工智能领域的文章与预印本样本,融合机构部门信息,最终衍生出包含 DI5 颠覆性指数等文献计量字段的 final_ai_di5 子集。所有数据均以 Parquet 格式存储,并分为多个分片,便于高效加载与分布式处理。
特点
该数据集最显著的特点在于其多层级、跨维度的结构设计,能够同时服务于元数据解析、引文网络分析与文献计量指标计算。light_openalex_works 子集提供了作品的核心属性,如出版年份、类型、主题与作者归属,以轻量化方式降低存储与查询开销。citation_edges 边表将复杂的引用列表转化为规整的边关系,并剔除非宇宙内的引用节点,为构建无断点的引文网络提供了清洁的数据基础。此外,数据集专门针对人工智能领域设计了富含机构部门信息的样本,并整合了基于五年引用窗口计算的 DI5 颠覆性指数,使得研究者能够直接评估某篇作品相对于其参考文献的颠覆性程度。整个数据集以 Hugging Face Datasets 格式组织,支持流式加载与分片读取,适合处理数十亿条记录的大规模学术数据场景。
使用方法
使用者可通过 Hugging Face Datasets 库灵活加载该数据集的不同子集。默认采用 load_dataset 函数并指定子集名称,如 light_openalex_works 或 citation_edges,设置 streaming=True 即可实现流式迭代,避免内存溢出。对于需要跨数据源关联分析的场景,推荐使用 DuckDB 直接查询 Parquet 文件,利用 SQL 语法对多个分片进行高效聚合与连接。在分析引文网络时,citation_edges 边表可与 light_openalex_works 中的作品信息通过 work_id 字段进行 Join,构建完整网络拓扑。对于聚焦人工智能领域颠覆性创新的研究,可直接加载 final_ai_di5 子集,利用其预计算的 DI5 值进行分布统计、趋势分析或作者机构层面的对比。所有子集均采用 Parquet 列式存储,支持 Apache Arrow 生态工具,便于集成到 Pandas、Polars 或 PySpark 等数据处理管道中。
背景与挑战
背景概述
在科学计量学与学术大数据分析领域,全景式、高时效性的引用网络数据是揭示知识演化脉络与评估学术影响力的基石。由Kenny Chow于2026年5月构建并发布的OpenAlex快照数据集(openalex-snapshot-2026-05),依托开放学术图谱(OpenAlex)的元数据体系,整合了约十亿量级的学术著作记录与引用边信息,并进一步衍生出聚焦人工智能领域、包含颠覆性指数(DI5)的深度分析子集。该数据集旨在为大规模文献计量、引用网络构建及颠覆性创新测度研究提供标准化的数据基础设施,其轻量化的Parquet格式与可流式加载的设计,显著降低了学术共同体在百亿级节点规模下开展实证研究的门槛,推动了开放科学数据在跨机构、跨学科协作中的可复现应用。
当前挑战
该数据集面临的核心挑战集中于领域问题与方法论两个维度。在领域问题层面,它旨在解决传统引用分析中因节点缺失、类型混杂导致的网络拓扑失真问题,然而引用窗口内离散时间戳的不一致性与开放图谱自身消歧算法的局限,使得精准计算五年期颠覆性指数(DI5)仍存在偏差风险。在构建过程中,挑战源于从原始OpenAlex快照中提取并清洗引用边时,需过滤掉超出作品宇宙的“悬空节点”,同时将嵌套的JSON字段(如主题、作者机构信息)高效解构为结构化列,以平衡数据详实度与查询性能。此外,AI领域样本的选取依赖主题元数据的主观界定标准,可能导致学科边界的模糊与代表性偏差。
常用场景
经典使用场景
OpenAlex Snapshot 2026-05 Processed Works and Citation Edges 数据集为大规模学术文献计量学与引文网络分析提供了坚实的数据基础。研究者常利用其轻量化的论文记录子集(light_openalex_works)和引文边表(citation_edges)构建全域学科引文图谱,进而开展引文窗口分析、文献耦合与共被引聚类。该数据集特别适合用于计算基于引文的学科影响力指标,如扰动指数(DI₅),从而探索学术创新模式的演化规律。此外,其以Parquet格式存储的海量结构化数据,配合DuckDB等高效查询工具,使得对超大规模学术元数据的交互式探索变得可行。
实际应用
在实际应用中,该数据集广泛服务于科研政策制定、高校学科评估与学术出版战略规划。政策制定者可基于其引文网络与机构归属数据,评估不同国家或机构的科研产出质量与创新活力。高校与研究机构利用其作者隶属关系与学科主题信息,进行学科布局优化与人才绩效分析。学术出版商则借此追踪特定领域(如人工智能)的出版趋势与高颠覆性研究,以指导审稿与选稿策略。此外,数据集的CC0许可协议极大降低了法律壁垒,使得商业科技公司与初创企业也能合法地将其用于知识图谱构建或科研情报产品的研发。
衍生相关工作
围绕此数据集已涌现一系列具有影响力的衍生工作。在方法论层面,研究者基于其引文边表优化了DI₅指数的计算流程,引入动态窗口与多参照系对比,催生了新的颠覆性度量变体。在实证研究方面,利用AI论文子集(ai_article_preprint_with_institution_sector)与DI₅标注数据,多篇工作探讨了人工智能领域颠覆性研究的制度环境与地缘分布特征。此外,该数据集也被作为基准填充到开源科研知识库中,用于训练和评估文献分类模型,或作为验证材料服务于引文推荐系统的性能测试。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

