
danish-foundation-models/multi-ifeval
收藏官方服务:
资源简介:
一个多语言数据集,包含多种语言的提示和指令,用于文本生成任务。
A multilingual dataset with prompts and instructions for text generation tasks across many languages.
搜集汇总
数据集介绍
构建方式
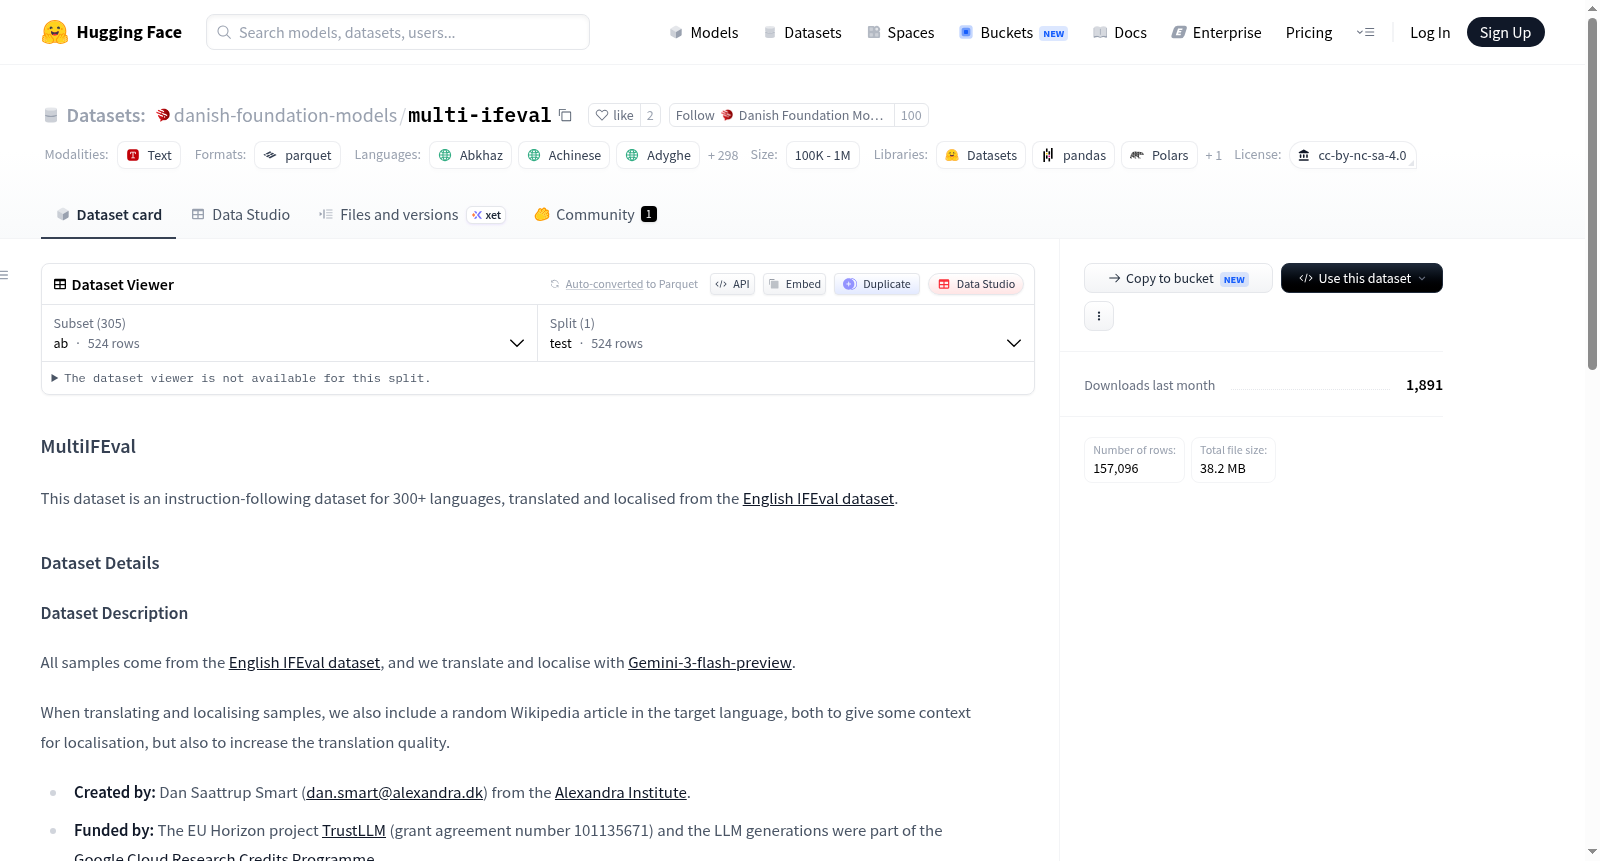
多语言指令遵循评估数据集(multi-ifeval)的构建基于对原始IFEval数据集的深度扩展,旨在系统性地评估大语言模型在多语言场景下的指令遵循能力。该数据集涵盖了超过200种语言,包括主要语言及众多低资源语言,每个语言配置均包含约523至524条测试样本。每条样本由提示(prompt)、指令标识符列表(instruction_id_list)以及一系列可配置的关键字参数(kwargs)构成,这些参数细化了指令的具体要求,例如指定字数、段落数、关键词、语言等。数据集以独立的配置形式组织各语言子集,便于按需加载和分析。
使用方法
使用multi-ifeval数据集时,研究者可通过Hugging Face Datasets库轻松加载特定语言的配置,例如使用`load_dataset('multi-ifeval', 'en')`加载英语子集。每个样本的prompt字段作为输入指令,而instruction_id_list和kwargs字段则提供参考标准,用于自动化评估模型输出是否满足所有约束。建议结合精确匹配或容错指标计算遵循率,以量化模型在不同语言和指令复杂度下的表现。该数据集特别适用于多语言NLP模型的指令微调与鲁棒性测试。
背景与挑战
背景概述
多语言指令遵循数据集(Multi-IFEval)是为评估大语言模型在跨语言场景下遵循复杂指令能力而构建的基准测试。该数据集由开源社区广泛协作创建,包含超过100种语言的指令遵循样本,每个样本由自然语言提示、指令标识列表及结构化参数组成,旨在系统性地检验模型对诸如字数约束、段落划分、禁用词规避等细粒度指令的响应质量。作为对IFEval数据集的扩展,Multi-IFEval极大填补了多语言指令评估领域的空白,为揭示语言模型在不同语言体系下的指令理解与执行差异提供了关键工具,对推动多语言人工智能服务的均衡发展具有重要学术与实践价值。
当前挑战
该数据集主要面临双重挑战。在领域问题层面,多语言指令遵循的评估需要模型具备跨语言的泛化能力,但现有模型在高资源语言与低资源语言间存在显著的性能鸿沟,且不同语言的语法与表达习惯差异对指令解析构成额外困难。在构建层面,数据集的创建者需要为近百种语言逐一设计并验证符合语言特性的指令模板,同时确保不同语言版本在难度与内容上的公平性,这涉及对海量语言资源的标注与人工审查,协调大规模多语言协作与质量控制是巨大工程挑战。
常用场景
经典使用场景
在自然语言处理与大型语言模型评估领域,multi-ifeval数据集被广泛用于检验模型对复杂、细粒度指令的遵从能力。该数据集通过设计涵盖多种约束条件(如字数、段落数、禁用词、特定格式等)的提示,要求模型生成严格匹配要求的文本。其经典使用场景包括对比不同模型在多语言环境下的指令执行一致性,以及分析模型在应对多重要求组合时的鲁棒性。研究者通过评估模型输出的准确率、格式合规性和内容完整性,能够系统性地衡量模型对结构化指令的理解与执行水平。
解决学术问题
multi-ifeval数据集有效解决了学术界在评估大型语言模型时面临的挑战:传统基准测试往往只关注单一维度的能力(如问答或翻译),而忽视了模型能否同时满足多项结构化约束。该数据集的引入,使得研究者能够量化模型在多约束指令遵循任务上的表现,揭示了不同模型在细节操控、逻辑连贯性及规则遵守方面的差异。其意义在于,为构建更可靠、更可控的生成模型提供了标准化评估框架,推动了指令微调、提示工程及多语言能力对齐等研究方向的发展。
实际应用
在实际应用中,multi-ifeval数据集的价值体现在多个领域。对于企业级文本生成系统(如自动化报告撰写、客户服务回复生成),该数据集可用于验证模型能否在遵守字数、禁用词、格式模板等企业规范的前提下输出合格内容。在跨语言内容创作平台中,它帮助评估模型在不同语言下执行指令的稳定性,从而优化多语言服务的质量。此外,教育科技公司可利用该数据集测试AI辅导系统在布置结构化作业(如规定段落数、关键词的作文)时的生成准确性。
数据集最近研究
最新研究方向
多语言指令遵循能力基准测试的前沿探索。在当前大语言模型(LLM)研究中,模型能否精准响应复杂且多样化的指令是衡量其泛化能力与实用性的核心标尺。multi-ifeval数据集通过覆盖数百种语言(包括众多低资源语种和方言)的细粒度指令体系(如字数、段落、关键词、格式等),率先构筑起跨语言指令遵循能力评估的基石。这一方向紧密关联多模态模型与通用人工智能的演进热点,其意义在于为全球化、多语种场景下的模型鲁棒性提供标准化检验,推动AI从单一语言能力向真正意义上的跨文化语义理解迈进。
以上内容由遇见数据集搜集并总结生成


