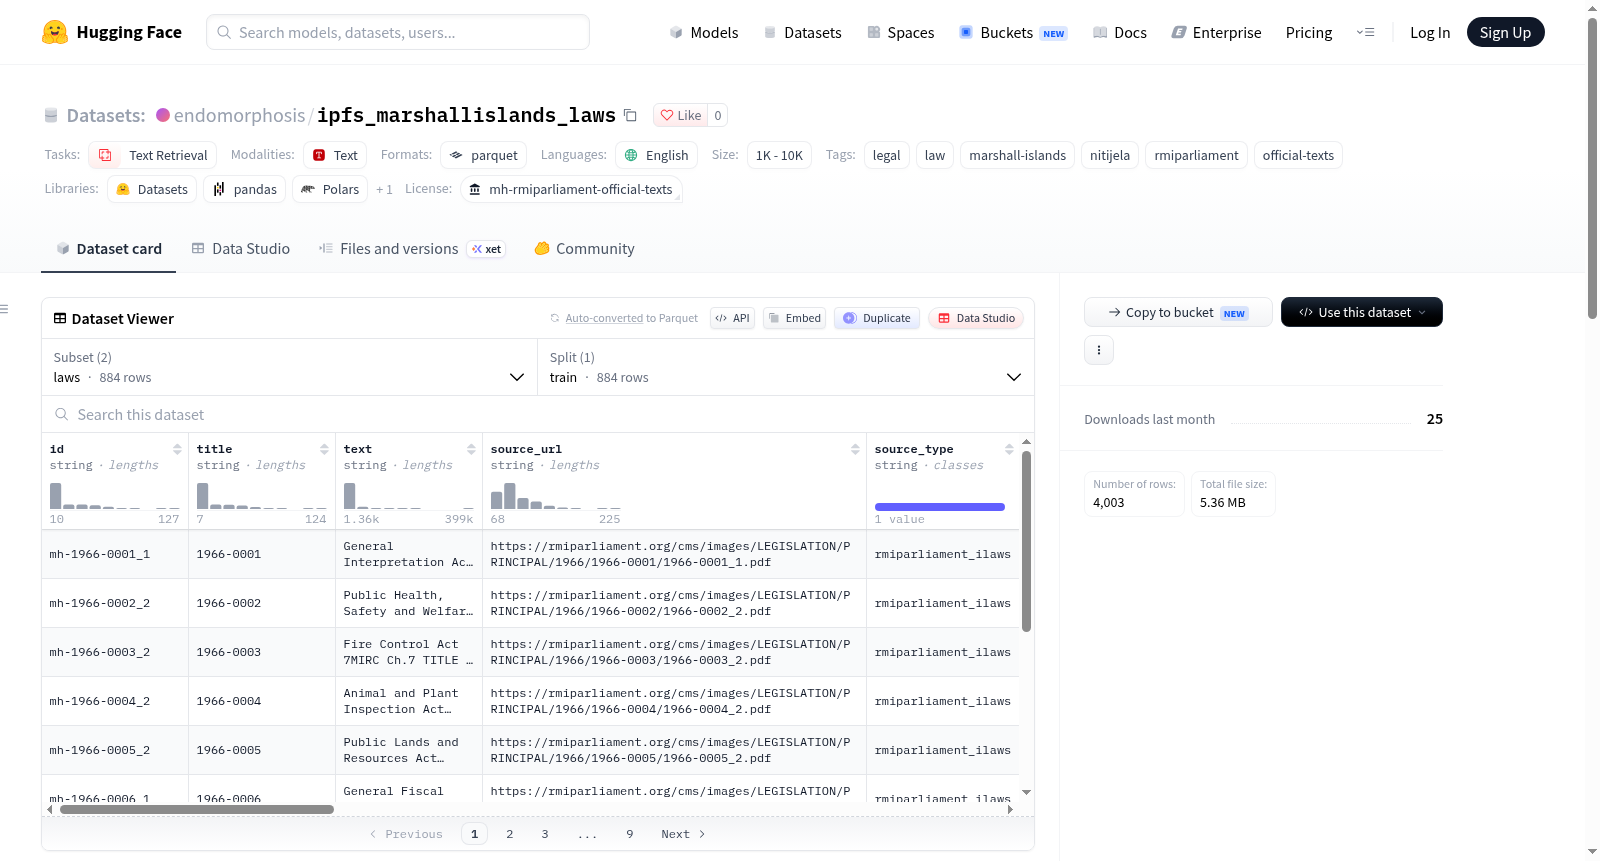
ipfs_marshallislands_laws
收藏资源简介:
这是一个关于马绍尔群岛 Nitijela 法案(来自 rmiparliament.org)的研究快照数据集。数据集包含从官方 Nitijela 法案网站(rmiparliament.org/cms)收集的立法文本,快照日期为 2026-09-10。数据主要分为两部分:`laws.parquet` 文件包含每部法律/文书的一行记录,共 884 部法律/文书;`articles.parquet` 文件包含每个条款/章节的一行记录,共 3,119 个条款。所有文本为英文,法域为马绍尔群岛。许可证为 `mh-rmiparliament-official-texts`,但数据集明确声明不是法律建议,官方来源(官方公报)具有优先效力。此外,数据集存在已知缺口:由于官方站点实施了 SiteGround 的 sgcaptcha 保护,收集时未进行验证码破解,仅使用了官方 URL 的归档回退。本数据集适用于文本检索、法律领域研究等任务。
This is a research snapshot dataset of the Nitijela Acts of the Marshall Islands (from rmiparliament.org). It contains legislative texts collected from the official Nitijela Acts website (rmiparliament.org/cms), snapshot date 2026-09-10. The data is divided into two parts: `laws.parquet` file with one row per act/instrument, totaling 884 acts/instruments; `articles.parquet` file with one row per article/section, totaling 3,119 articles. All text is in English, jurisdiction is the Marshall Islands. License is `mh-rmiparliament-official-texts`, but the dataset explicitly states it is not legal advice and official sources (official gazette) take precedence. Known gaps: due to SiteGrounds sgcaptcha protection on the official site, no CAPTCHA cracking was performed during collection, only archive fallback of official URLs was used. The dataset is suitable for tasks such as text retrieval and legal domain research.
Marshall Islands Nitijela Acts (rmiparliament.org) 数据集总结
基本信息
| 字段 | 内容 |
|---|---|
| 数据集名称 | Marshall Islands Nitijela Acts (rmiparliament.org) |
| 数据集地址 | https://huggingface.co/datasets/endomorphosis/ipfs_marshallislands_laws |
| 语言 | en(英语) |
| 任务类别 | text-retrieval(文本检索) |
| 许可证 | other |
| 许可证名称 | mh-rmiparliament-official-texts |
| 数据规模 | 1K<n<10K |
标签
- legal
- law
- marshall-islands
- nitijela
- rmiparliament
- official-texts
数据快照
| 字段 | 值 |
|---|---|
| 快照日期 | 2026-09-10 |
| 覆盖范围 | rmiparliament-acts-archive-backed |
| 来源 | Nitijela Acts (rmiparliament.org/cms) |
| 采集工具 | scrapers/collect_mh.py |
| 法律/文书数量 | 884 |
| 文章数量 | 3,119 |
| 语言 | en |
| 司法管辖区 | Marshall Islands(马绍尔群岛) |
| 许可证 | mh-rmiparliament-official-texts |
数据配置
| 配置名称 | 数据文件 | 是否默认 |
|---|---|---|
| laws | data/laws.parquet | 是 |
| articles | data/articles.parquet | 否 |
数据集内容
data/laws.parquet— 每行代表一项法律文书。data/articles.parquet— 同一快照下的文章/章节行。scrapers/collect_mh.py— 用于构建此快照的研究采集器。
来源
- https://rmiparliament.org/cms/legislation/acts-of-nitijela/by-alphabetical-order.html
许可证与重用
马绍尔群岛 Nitijela Acts 官方文本;以 rmiparliament.org / 权威文本为准;不构成法律建议。
本数据集不构成法律建议。以官方来源为准。
已知缺口
- 官方 rmiparliament.org Nitijela Acts 位于 /cms/images/LEGISLATION/ 下。
- 存在实时 SiteGround sgcaptcha — 未进行验证码破解;仅使用官方 rmiparliament.org URL 的 archive_fallbacks。
- 不包含 PacLII。
- 不构成法律建议。