
Adeel1percentdotcom/LORU-ED_Roman-Urdu-Event-Detection
收藏数据链接:
官方服务:
资源简介:
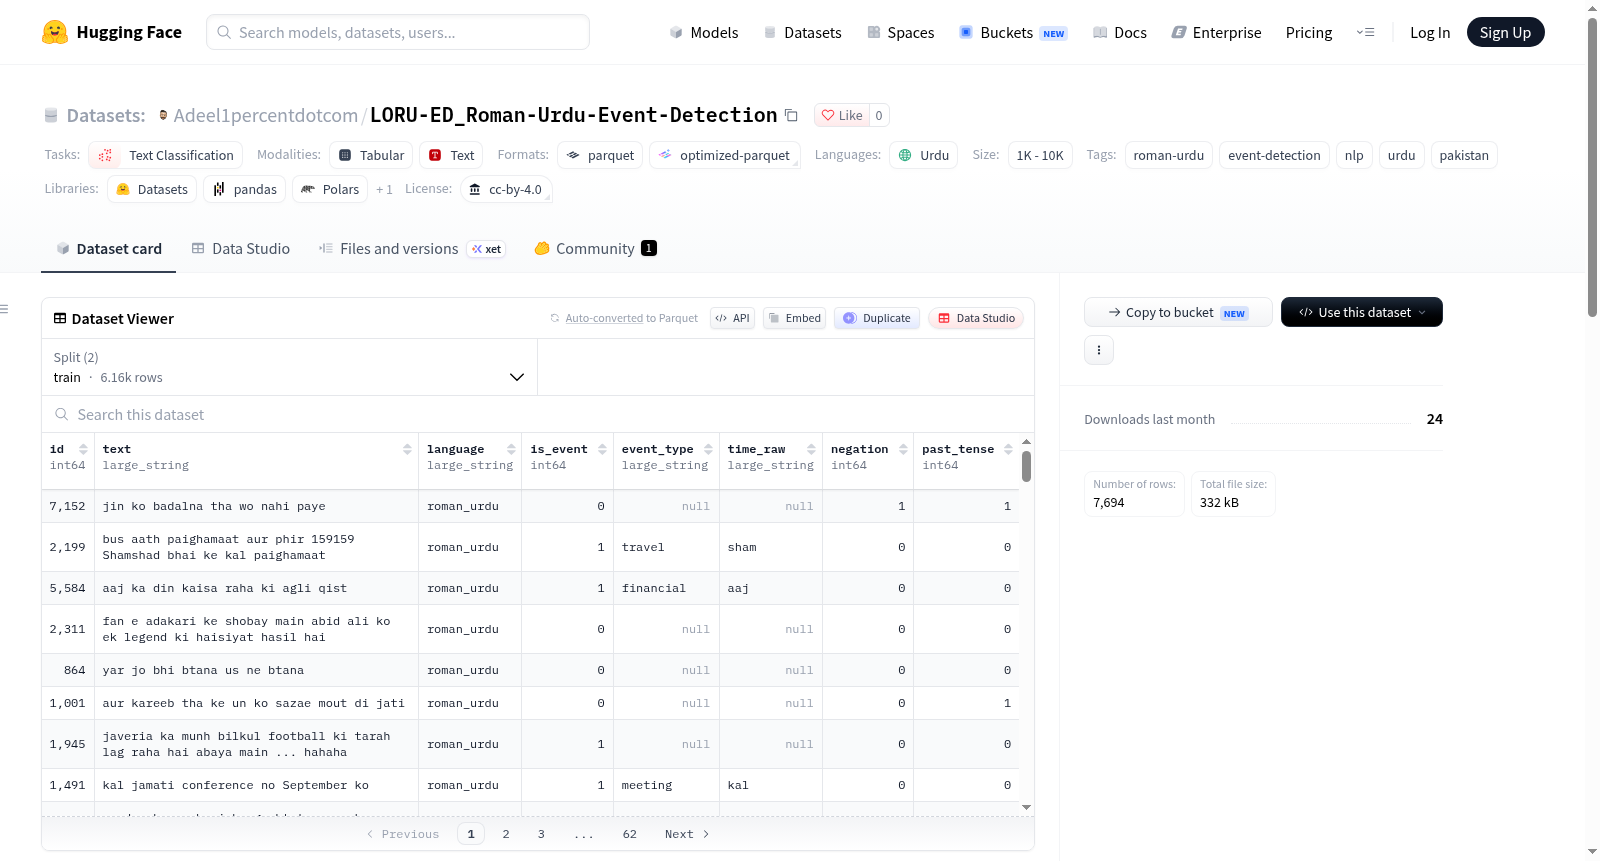
LORU-ED是一个用于事件检测的新型罗马乌尔都语数据集,包含7,694个标注句子,事件和非事件类别平衡相等。
LORU-ED is a novel Roman Urdu dataset for event detection, containing 7,694 annotated sentences balanced equally between event and non-event classes.
提供机构:
Adeel1percentdotcom搜集汇总
数据集介绍
构建方式
事件检测作为自然语言处理领域的核心任务,长期受限于低资源语言标注数据的匮乏,罗马乌尔都语尤为如此。LORU-ED数据集的构建针对这一空白,汇集了7,694条经人工标注的罗马乌尔都语句子,事件类与非事件类样本保持均衡分布,以规避类别偏置对模型训练的干扰。数据划分采用训练集6,155条与测试集1,539条的方案,每条样本均附带唯一标识符、语言标签、二值事件标签、十七类细粒度事件类别以及时间表达、否定标记和时态标记等语言学特征,从而为模型提供多层次的监督信号。
特点
该数据集的核心特征在于其细粒度的事件类型体系,涵盖考试、出行、祈祷、体育、会议、金融、医疗、政府、面试、家庭等十七个类别,能够支撑从粗粒度二分类到细粒度多分类的多层级事件检测研究。语言标签区分纯罗马乌尔都语、混合语和英语样本,保留了南亚多语社会的真实语言生态。否定标记与时态标记的引入使数据集具备语义角色与时间属性的联合分析能力,而均衡的类别分布则为模型评估提供了无偏基准。此外,该数据集采用CC-BY-4.0许可协议,便于学术与商业场景下的广泛复用。
使用方法
研究者可通过Hugging Face平台直接加载LORU-ED数据集,利用训练集进行模型微调或从头训练,测试集则用于评估事件检测性能。使用时可将text字段作为输入,is_event字段作为二分类标签,event_type字段作为细粒度分类目标,negation与past_tense等辅助字段可用于多任务学习或特征增强。该数据集适用于Transformer类预训练模型的迁移学习,也可用于传统机器学习方法的基准测试。引用时需按照README中提供的格式标注作者、标题、年份及数据集URL,以确保学术溯源的规范性。
背景与挑战
背景概述
事件检测作为自然语言处理的基础任务,长期受限于资源匮乏语言的标注语料稀缺,乌尔都语及其罗马化变体尤为突出。罗马乌尔都语广泛流通于巴基斯坦社交媒体与即时通讯场景,却缺乏系统化的公开评测资源。LORU-ED数据集由Adeel Shehbaz于2026年构建并发布于Hugging Face平台,包含7,694条均衡标注语句,覆盖17类细粒度事件类型,并附带时间表达、否定与过去时等语言学特征标注。该数据集填补了罗马乌尔都语事件检测资源的空白,为低资源语言信息抽取研究提供了可复用的基准,推动了南亚语言计算与跨语言迁移研究的发展。
当前挑战
事件检测任务的核心挑战在于从非结构化文本中精准识别事件触发词并判定其语义类别,罗马乌尔都语缺乏统一的拼写规范与形态标注工具,导致文本噪声显著、词汇稀疏问题严峻。构建过程中,标注者需在无标准正字法约束的条件下保持事件类别判定的一致性,同时准确标注时间表达、否定与过去时等语言学属性,这对标注规范设计与质量控制提出了极高要求。此外,事件与非事件类别在口语化表达中界限模糊,17类细粒度事件类型的语义边界存在交叠,进一步加剧了标注歧义与模型判别难度。
常用场景
经典使用场景
在自然语言处理领域的事件检测任务中,罗马乌尔都语作为一种低资源语言,长期缺乏高质量的标注语料,LORU-ED数据集应运而生,成为该语言事件检测研究的基准资源。其经典使用场景聚焦于句子级事件识别,即判定给定罗马乌尔都语句子是否描述了一个具体事件,并进一步将其归类至十七种细粒度事件类型中,如考试、旅行、医疗、体育等。研究者通常将该数据集按训练集与测试集划分,训练集包含六千一百五十五条语句,测试集包含一千五百三十九条语句,用于构建和评估事件检测模型。该数据集平衡了事件与非事件类别的样本数量,为模型训练提供了无偏的监督信号,成为罗马乌尔都语事件检测任务的标准实验平台。
实际应用
在实际应用层面,LORU-ED数据集为社交媒体监控、新闻事件抽取、智能助理与应急响应系统提供了关键支持。基于该数据集训练的事件检测模型能够自动识别罗马乌尔都语文本中描述的事件,例如在推特或脸书等平台上检测用户发布的考试、旅行、医疗预约或家庭事件,从而辅助构建个性化推荐与提醒服务。在公共卫生与安全领域,该数据集可用于监测疫情相关事件或社会动荡的早期信号,帮助决策者及时响应。此外,该数据集支持时间表达与否定标记的联合建模,使得事件检测系统能够区分已发生与未发生的事件,提升信息抽取的准确性。这些应用场景彰显了该数据集在跨语言信息处理中的实用价值。
衍生相关工作
LORU-ED数据集的发布激发了多项后续研究,衍生出一系列经典工作。研究者基于该数据集探索了罗马乌尔都语事件检测的深度学习方法,包括卷积神经网络、双向长短期记忆网络以及基于Transformer的多语言预训练模型微调策略。部分工作将LORU-ED作为跨语言事件检测的评估基准,研究英语与罗马乌尔都语之间的知识迁移。此外,该数据集被用于事件时间关系抽取与否定检测的联合建模,推动了低资源语言信息抽取 pipeline 的发展。一些研究还利用该数据集构建了罗马乌尔都语的事件类型分类体系,并与乌尔都语标准书写系统进行对比分析。这些衍生工作不仅丰富了罗马乌尔都语的自然语言处理资源,也为其他低资源语言的事件检测研究提供了可借鉴的方法论框架。
以上内容由遇见数据集搜集并总结生成


