galaxies-with-hats
收藏资源简介:
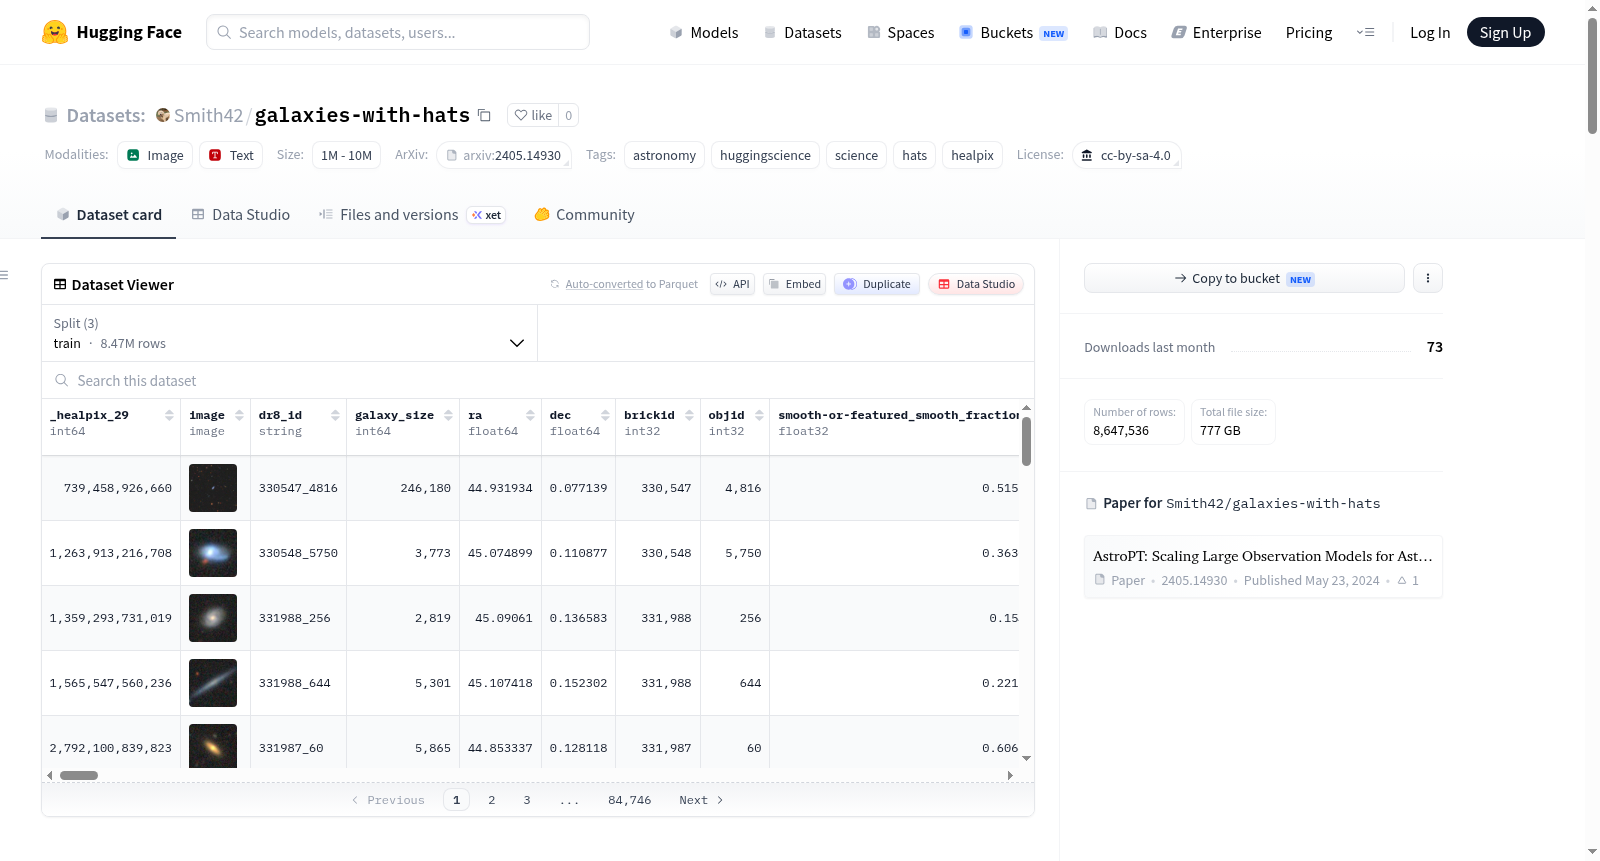
Galaxies with HATS 是一个基于 HEALPix 自适应分块方案 (HATS) 重构的天文星系数据集。它源自 Smith42/galaxies 数据集的 v2.0 版本,核心内容为约 850 万张来自 DESI 遗产巡天第八次数据发布 (DR8) 的 256×256 像素 PNG 格式星系图像。与原始为机器学习优化排序的版本不同,本数据集专为基于天空坐标的空间分析设计:每条数据记录均包含赤经 (`ra`)、赤纬 (`dec`) 和一个 `_healpix_29` 空间索引,数据本身按照 HEALPix 图块进行物理分区存储,使得锥形搜索、盒形搜索或与其他星表的交叉匹配等操作只需访问相关的数据文件,极大提升了空间查询效率。数据集严格保留了原始 98/1/1 的数据划分,形成三个独立的集合:训练集(约 847 万样本,1555 个分区,~709 GB)、验证集(约 8.6 万样本,27 个分区,~7.3 GB)和测试集(约 8.6 万样本,27 个分区,~7.3 GB)。除了核心的图像字段 (`image`) 外,每条数据还附带了丰富的元数据,总计约 170 个字段。这些元数据涵盖了 Galaxy Zoo DESI 项目的众包形态学分类结果(如平滑/有特征/伪影、是否有棒旋结构、旋臂数量与缠绕度等概率分数)、NSA 测光参数(星等、大小、椭圆率等)、红移信息,以及来自 OSSY、ALFALFA、JHU-MPA 等多个外部星表的交叉匹配物理参数(如恒星形成率、黑洞质量、中性氢流量等)。该数据集适用于需要融合多波段星系图像与多维度物理参数的天体物理研究,例如星系形态自动分类、星系演化与环境的关联分析、特定类型天体的空间分布统计,以及作为机器学习模型训练与验证的数据源。数据以 Apache Parquet 格式提供,支持通过 Hugging Face Datasets 库流式加载,也推荐使用 LSDB 库进行高效的空间查询,或直接使用 pandas、PyArrow 等工具处理。
数据集概述:Galaxies with HATS
数据集地址:https://huggingface.co/datasets/Smith42/galaxies-with-hats
许可协议:cc-by-sa-4.0
数据集规模:1M < n < 10M(约850万条记录)
标签:天文学、科学、HEALPix、星系
数据集构成
该数据集是 Smith42/galaxies(v2.0版)的 HATS(HEALPix Adaptive Tiling Scheme)版本。它提供了约850万个256×256像素的PNG格式星系切图,图像源自DESI Legacy Survey DR8巡天数据,以星系源为中心。数据按天空位置进行空间分区,每条记录包含约170个元数据列。
原始数据集按机器学习训练顺序组织,而本版本按天空位置顺序组织,便于基于坐标的天文分析。每条记录都包含赤经(ra)、赤纬(dec)以及一个名为_healpix_29的空间索引,数据被分区到HEALPix tiles中,使得锥形/矩形/交叉匹配查询仅需访问相关文件。
原始数据集的98/1/1训练/验证/测试划分被保留为三个独立的HATS集合:
| 集合 | 行数 | HEALPix分区数 | 大小 |
|---|---|---|---|
| train | 8,474,566 | 1,555 | ~709 GB |
| validation | 86,499 | 27 | ~7.3 GB |
| test | 86,471 | 27 | ~7.3 GB |
数据列
所有三个集合共享相同的170列模式,包括:
- 图像与标识:
image(PIL图像,由Hugging Face的datasets库自动解码)、dr8_id、galaxy_size、ra、dec、file_name、iauname - 空间索引:
_healpix_29(int64) - 形态参数(Galaxy Zoo DESI):包括平滑/特征、盘面、旋臂、棒状结构、核球大小、形状、边缘核球、旋臂缠绕、旋臂数量、合并状态等各类分数(float32)
- 光度测量(NSA):各波段星等(
mag_r_desi,mag_g_desi,mag_z_desi等)、Petrosian半径、椭圆率、Sérsic指数等 - 红移与光谱:
redshift_nsa、spec_z、photo_z等 - 交叉匹配数据:
- OSSY(光谱):
redshift_ossy、log_l_oiii、log_m_bh等 - ALFALFA(中性氢HI):
W50、HIflux、logMH等 - JHU-MPA(恒星形成率):
fibre_sfr_avg、total_sfr_avg、total_ssfr_avg等 - PhotoZ(测光红移):
photo_z、mass_med_photoz、sfr_sup_photoz等
- OSSY(光谱):
Null值情况:部分形态参数列有较高的缺失率(如合并状态相关列缺失率约93%-98%);光度测量相关列缺失率在0%-93%之间。
数据格式:HATS格式本质上是Parquet文件,可直接用pandas、pyarrow、dask、Spark或DuckDB读取。分区文件按Norder={order}/Dir={dir}/Npix={pixel}.parquet规则命名,每个tile约包含10,000行数据(约0.8 GB)。
应用与工具
-
数据流式加载(Hugging Face Datasets):可使用
datasets库流式加载,例如: python from datasets import load_dataset galaxies = load_dataset("Smith42/galaxies_with_hats", split="train", streaming=True)由于流式顺序遵循HEALPix天空分块,连续样本是天空邻居;如需用于机器学习训练的独立同分布批次,可添加
.shuffle(buffer_size=10_000)或使用原始Smith42/galaxies数据集。 -
空间查询(LSDB):推荐使用
lsdb库进行空间分析,例如锥形搜索和交叉匹配: python import lsdb galaxies = lsdb.open_catalog("hf://datasets/Smith42/galaxies_hats/train") cone = lsdb.open_catalog("hf://datasets/Smith42/galaxies_hats/train", search_filter=lsdb.ConeSearch(ra=161.0, dec=48.0, radius_arcsec=3600.0)) df = cone.compute() -
直接读取Parquet文件:可以直接读取单个天空区块,例如: python import pandas as pd tile = pd.read_parquet("hf://datasets/Smith42/galaxies_hats/test/test/dataset/Norder=0/Dir=0/Npix=4.parquet")