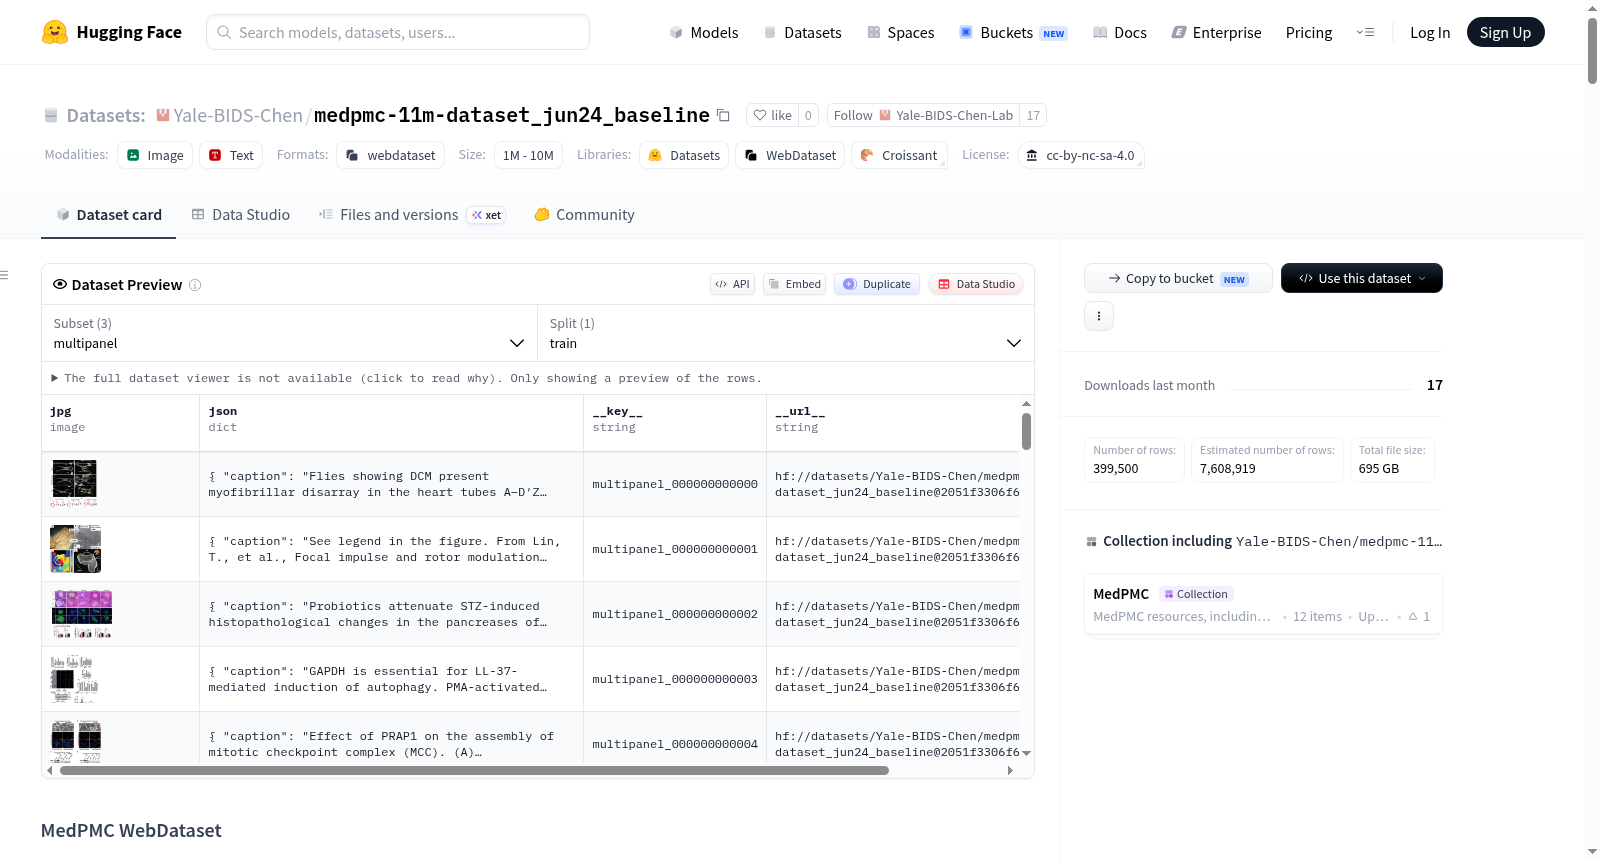
medpmc-11m-dataset_jun24_baseline
收藏资源简介:
MedPMC是一个从PubMed Central (PMC)文章中整理的大规模医学图像-文本数据集,包含约1100万图像-文本对,基于2024年6月的PMC基线。该数据集旨在为医学人工智能研究提供高质量的临床相关视觉内容。与原始PMC资源相比,MedPMC进行了两项主要改进:一是通过过滤非医学图表、绘图、表格、工作流程图等,专注于临床相关的医学图像,涵盖放射学、病理学、眼科学、皮肤病学、内窥镜检查、显微镜检查和临床摄影等多种医学专业和成像模式;二是特别处理了生物医学出版物中常见的多面板图,不仅保留完整的多面板图及其图级标题,还提供从多面板图中提取的单个子图及其对应的子标题。数据集分为三个子集:multipanel(医学多面板图及图级标题)、singlepanel(医学单面板图及图级标题)和subfigure(从多面板图中提取的医学子图与子标题配对)。每个样本包含一个图像文件(如JPG、PNG、WebP格式)和一个对应的JSON元数据文件,存储在.tar分片中。元数据包含来源类型、PubMed Central文章标识符(pmcid)、唯一图像标识符(image_id)、原始图标签(figure_label)、标题(caption)、文章中的引用文本(references)等字段,对于子图还包含父图像标识符(parent_image_id)和父标题(parent_caption)。该数据集适用于医学多模态学习、图像标注、视觉问答等任务,采用CC BY-NC-SA 4.0许可证,供非商业研究使用。
MedPMC is a large-scale medical image-text dataset curated from PubMed Central (PMC) articles, containing approximately 11 million image-text pairs based on the PMC baseline from June 2024. The dataset aims to provide high-quality clinically relevant visual content for medical AI research. Compared to the original PMC resources, MedPMC introduces two main improvements: first, it focuses on clinically relevant medical images by filtering out non-medical charts, drawings, tables, workflow diagrams, etc., covering various medical specialties and imaging modalities such as radiology, pathology, ophthalmology, dermatology, endoscopy, microscopy, and clinical photography; second, it specially handles multi-panel figures common in biomedical publications, not only retaining complete multi-panel figures with their figure-level captions but also providing individual subfigures extracted from multi-panel figures paired with their corresponding subcaptions. The dataset is divided into three subsets: multipanel (medical multi-panel figures with figure-level captions), singlepanel (medical single-panel figures with figure-level captions), and subfigure (medical subfigures extracted from multi-panel figures paired with subcaptions). Each sample includes an image file (e.g., in JPG, PNG, WebP formats) and a corresponding JSON metadata file, stored in .tar shards. The metadata includes fields such as source type, PubMed Central article identifier (pmcid), unique image identifier (image_id), original figure label (figure_label), caption, references in the article, and for subfigures, parent image identifier (parent_image_id) and parent caption (parent_caption). The dataset is suitable for tasks like medical multimodal learning, image captioning, and visual question answering, and is licensed under CC BY-NC-SA 4.0 for non-commercial research use.
数据集概述
MedPMC 是一个大规模医学图像-文本数据集,从 PubMed Central (PMC) 文章库中整理而成。本版本(June 2024 baseline)包含约 1100 万 对图像-文本对。
两大核心改进
- 医学图像筛选:过滤掉图表、流程图、表格等非医学图像,聚焦于放射学、病理学、眼科、皮肤科、内窥镜、显微镜、临床摄影等临床相关的视觉内容。
- 多面板图像处理:保留原始的多面板完整图像,同时提取单个子面板及其对应的子标题,支持在完整图像和子面板级别使用。
数据集子集
数据集分为三个子集,所有子集均以 .tar 分片形式存储。
| 子集名称 | 描述 |
|---|---|
multipanel |
医学多面板图像,包含图像级别的标题。 |
singlepanel |
医学单面板图像,包含图像级别的标题。 |
subfigure |
从多面板图像中提取的子图像,配有子标题。 |
数据格式
每个样本包含一个图像文件和一个对应的 JSON 元数据文件。
JSON 元数据字段:
source_type: 数据来源类型(multipanel,singlepanel,subfigure)。pmcid: PubMed Central 文章标识符。image_id: 基于PMCID和图像图形标识符构成的唯一图像级别标识符。figure_label: 文章中的原始图像标签(例如"Figure 2")。caption: 当前图像样本配对的标题。references: 文章中引用该图像的文本段落。parent_image_id(仅subfigure子集): 源多面板图像的image_id。subfigure_index(仅subfigure子集): 子图像在源图像中的索引。parent_caption(仅subfigure子集): 源多面板图像的完整标题。
许可协议
采用 CC BY-NC-SA 4.0 许可,仅限非商业研究用途。
联系方式
如有问题,可联系 Hyunjae Kim (hyunjae.kim@yale.edu)。