
victoria-emotion-de-synthetic
收藏官方服务:
资源简介:
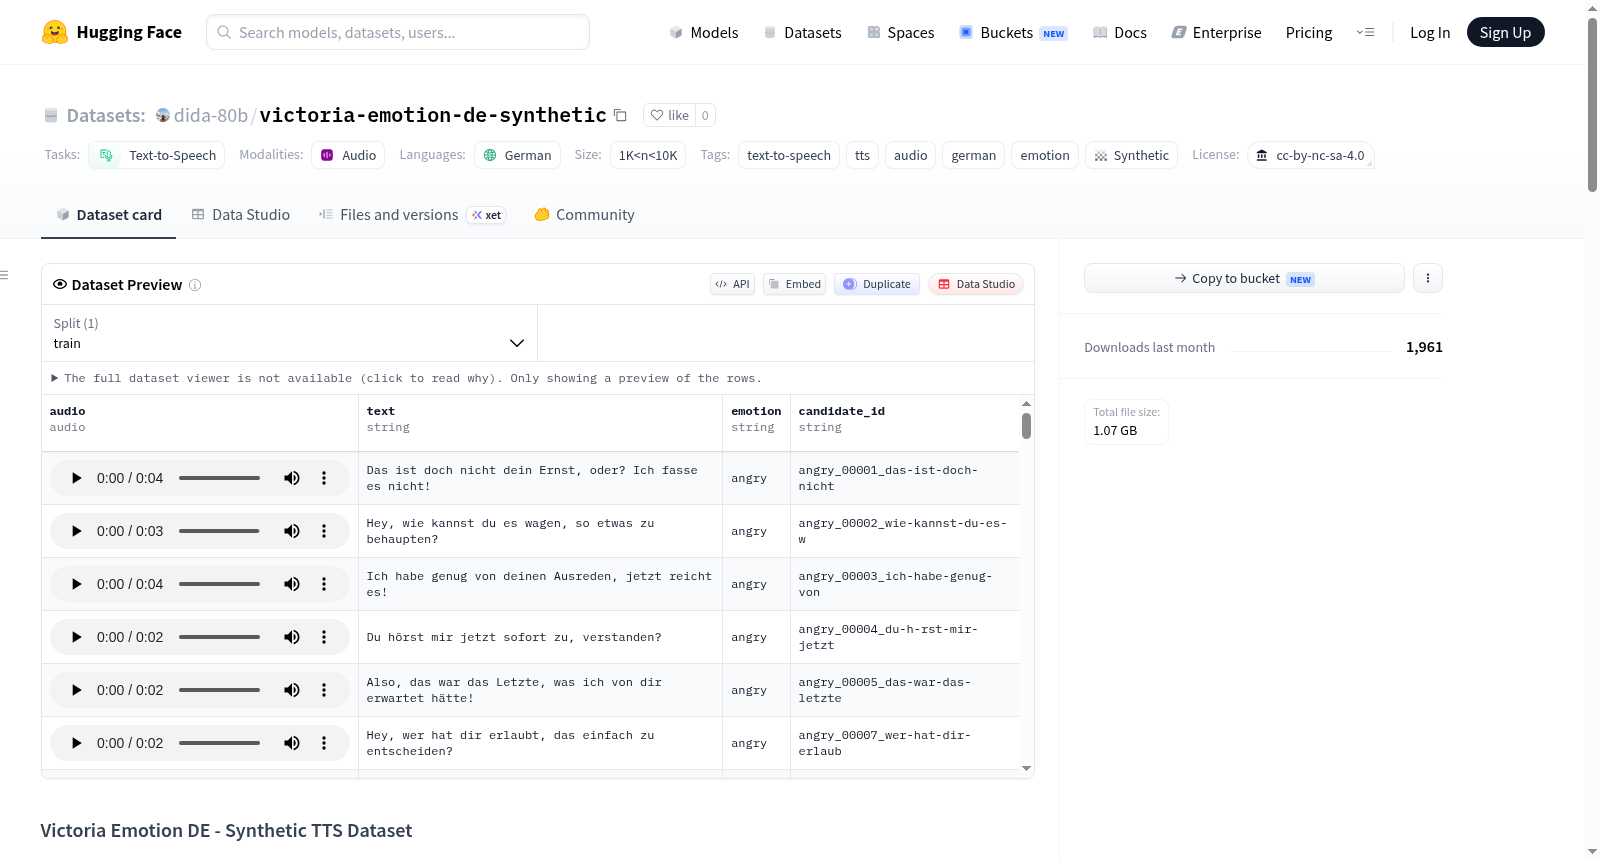
Victoria Emotion DE是一个德语合成文本转语音(TTS)数据集,专门用于情感语音合成研究。它包含6,758个音频片段,覆盖28种情感类别,如愤怒、中性、悲伤、快乐、惊讶等。所有音频均通过基于Qwen3-TTS-12Hz-1.7B模型和自定义Victoria说话人嵌入的合成管道生成,格式为24 kHz单声道WAV文件。数据集经过手动筛选和信号/质量控制辅助的伪影过滤,以确保质量。每个音频文件按照“{情感}_{ID}_{文本简写}.wav”的格式命名,并配有包含文件名、文本内容和情感标签的元数据文件。该数据集适用于情感条件化TTS模型训练、合成语音情感实验、数据增强以及德语语音合成微调等任务。需要注意的是,情感标签来源于生成提示类别,并非独立验证的人类情感标注,且音频为合成生成,可能包含细微伪影。数据集基于CC-BY-NC-SA 4.0许可发布,要求注明出处并禁止商业使用,其Victoria说话人嵌入源自HUI-Audio-Corpus-German语料库。
创建时间:
2026-05-21
原始信息汇总
数据集总览
- 名称:Victoria Emotion DE - Synthetic TTS Dataset
- 语言:德语(de)
- 音频数量:6,758 条
- 情感类别:28 种
- 格式:WAV,24 kHz,单声道
- 语音:Victoria(自定义说话人嵌入)
- 许可证:CC-BY-NC-SA 4.0(非商业性使用)
- 许可证说明:商业使用需获得作者书面许可
情感分布
| 情感 | 数量 | 情感 | 数量 |
|---|---|---|---|
| angry | 236 | menacing | 245 |
| annoyed | 240 | mocking | 241 |
| apologetic | 244 | mysterious | 245 |
| bitter | 248 | neutral | 238 |
| condescending | 242 | pleading | 238 |
| confident | 241 | proud | 246 |
| desperate | 239 | relieved | 239 |
| disgusted | 243 | sad | 244 |
| enraged | 240 | sarcastic | 239 |
| excited | 238 | surprised | 238 |
| fearful | 236 | sympathetic | 241 |
| flirtatious | 239 | guilty | 244 |
| frustrated | 241 | happy | 243 |
| hopeless | 244 | lethargic | 246 |
数据格式
- 音频文件命名:
{emotion}_{id}_{text-slug}.wav - 元数据文件:
metadata.jsonl,每行一个 JSON 条目,包含file_name、text、emotion、candidate_id字段
预期用途
- 情感条件文本转语音(TTS)模型训练
- 合成语音情感实验与数据增强
- 德语语音合成微调
生成方式
- 使用 Qwen3-TTS-12Hz-1.7B 模型及自定义 Victoria 说话人嵌入生成音频
- 文本提示通过情感特定的指令提示生成,并经过去重处理(含 4 词前缀去重)
已知局限
- 音频为合成数据,仅使用一种 Victoria 风格说话人嵌入
- 情感标签对应生成提示/类别,未经独立人工验证
- 虽经人工筛选与信号质量检查,仍可能存在细微伪影
致谢与引用
- 说话人嵌入衍生自 HUI-Audio-Corpus-German
- 引用论文:Lux et al., 2021, HUI-Audio-Corpus-German: A High Quality TTS Dataset, KI 2021
联系方式
- 作者 HuggingFace 主页:https://huggingface.co/dida-80b
搜集汇总
数据集介绍
构建方式
在文本到语音(TTS)与情感语音合成领域,高质量、多情感标注的数据集是驱动模型表现提升的关键资源。本数据集采用定制化的Qwen3-TTS-12Hz-1.7B架构,并嵌入自定义的Victoria说话人特征,以情感特定的指令提示生成文本,通过自动化流水线合成6,758条德语语音片段。生成过程中实现了4词前缀级别的去重,以避免文本重复。随后,数据集作者对所有样本进行了人工审查,并辅以信号质量与截止伪影的自动检测过滤,最终构建出涵盖28种情感类别的合成语音集合。每条音频以WAV格式存储,采样率为24 kHz单声道,文件名按“{情感}_{ID}_{文本片段}.wav”结构命名,元数据则以JSON Lines格式记录,包含文件名、文本及情感标签。
特点
该数据集的核心特色在于其广泛而细腻的情感覆盖,囊括从愤怒、嫉妒到神秘、无助等28种情感状态,且各类别下的音频数量均衡,介于236至248条之间,为情感条件TTS模型训练提供了丰富的样本基础。数据集的构建严格基于合成生成与人工精校的结合,既保证了情感标签的明确指向性——源于指令提示而非主观标注,又通过人工筛选降低了合成伪影,提升了整体质量。此外,统一的Victoria说话人风格确保了语音音色的一致性,使得情感变化成为模型学习的纯变量,适合用于研究单一说话人下的情感表达差异。数据集许可采用CC-BY-NC-SA 4.0,明确禁止商业用途,强调了其学术研究导向。
使用方法
本数据集专为情感条件文本到语音模型的训练设计,尤其适用于德语语音合成微调与合成语音情感实验。用户可通过读取metadata.jsonl文件,使用文件名定位WAV音频并将其与对应的情感标签、文本配对,构建可用于模型输入的训练管线。例如,在Hugging Face Transformer或Coqui TTS等框架中,可将“text”与“emotion”字段嵌入编码器,以音频文件为监督信号进行多任务学习。研究者亦可利用该数据集进行数据增强,在已有的德语TTS模型上附加情感控制模块。需注意,数据集的标签为生成条件标签,并非人类情感识别基准,因此不推荐直接用于语音情感识别(SER)任务的评估,但可用于相关领域的探索性实验。
背景与挑战
背景概述
在文本到语音(TTS)合成领域,情感表达能力的建模始终是提升合成语音自然度与表现力的核心挑战。近年来,随着深度生成模型与大规模语音语料库的蓬勃发展,研究者们日益关注如何在可控条件下生成具有丰富情感色彩的语音。victoria-emotion-de-synthetic数据集由研究者Dieter Dannerbeck于2026年创建,旨在提供一份面向德语的情感条件TTS合成资源。该数据集基于HUI-Audio-Corpus-German中的Victoria音色嵌入,利用Qwen3-TTS-12Hz-1.7B模型合成6,758条音频片段,覆盖愤怒、悲伤、兴奋等28种细粒度情感类别。其精巧的类别划分与明确的生成流程,为德语情感语音合成、数据增强及多情感TTS微调研究提供了重要支撑,同时推动了合成语音在情感表达可控性方面的探索。
当前挑战
该数据集所应对的核心领域挑战在于,当前多数TTS系统难以在单一说话人条件下控制系统生成语音的情感类型与强度,且缺乏高质量、多标签的情感语音资源。传统的语音情感数据集多依赖人工标注,成本高昂且情感类别稀疏。victoria-emotion-de-synthetic通过合成方式解决了类别覆盖不足的问题,但其构建过程面临显著挑战:一方面,合成语音中的情感标签源于提示词控制,并非经过人工验证的人类情感标注,这可能导致生成语音与标注情绪之间出现偏差;另一方面,尽管经过人工与信号辅助筛选,合成音频仍可能残留微妙的伪影,影响模型训练的稳定性。此外,单一说话人嵌入限制了说话者多样性的泛化能力,在使用该数据进行情感识别或泛化任务时需谨慎评估其适用性。
常用场景
经典使用场景
在语音合成与情感计算交叉领域,精确可控的情感表达生成始终是一项核心挑战。该数据集作为首个德语情感合成语音资源,提供了由单一说话人嵌入(Victoria)生成的6,758条高质量音频片段,覆盖28种细粒度情感类别,包括愤怒、恐惧、讽刺、悔恨、愉悦等。其经典使用场景在于作为情感条件文本到语音(TTS)模型的训练语料,研究人员可利用该数据集中情感标签与语音信号间的映射关系,驱动生成模型学习不同情感状态下的韵律、音色与语调变化模式,从而实现对合成语音情感的精细调控与多元化输出。
衍生相关工作
该数据集衍生出了一系列相关研究工作,其生成与标注流程为后续构建多语言合成情感语料提供了技术路线示范。围绕该数据,研究人员可能开展情感语音表征学习、基于提示的情感调控机制探究、以及合成语音中的情感自然度评测标准制定等工作。此外,Victoria语音嵌入源自HUI-Audio-Corpus-German,这一公开质量TTS数据集,二者的结合催生了从原始录音到合成情感数据的知识迁移路径,进而启发诸如跨说话人情感传递、少样本情感语音克隆等前沿课题,推动了情感计算与语音人工智能领域的方法演进。
数据集最近研究
最新研究方向
聚焦于情感条件语音合成的前沿探索,该数据集通过定制化的 Qwen3-TTS 流水线生成 28 种情感类别的德语合成语音,突破了传统情感语音数据在种类丰富度与标注一致性上的瓶颈。在跨模态生成与情感计算深度融合的背景下,基于单一说话人嵌入的精细情感调控技术正成为研究热点,尤其适用于低资源语言的情感表达增强与合成数据增强任务。该数据集的出现,为德语语音合成在细腻情感维度上的建模提供了系统化的基准资源,同时引发了关于合成标签可信度与生态效度的学术讨论,推动了合成语音情感标注方法论向更严谨的验证体系演进。
以上内容由遇见数据集搜集并总结生成


