IDA-TRAIN-V2-mlperf-squad-gb10-results
收藏资源简介:
本数据集为SQuAD v1.1(Stanford Question Answering Dataset)的一个子集,包含87,599个训练问答对,用于机器阅读理解任务。数据集中的每个样本包含一个问题和一段上下文文本,模型需要从上下文中抽取答案片段。该数据集在MLPerf基准测试中用于训练和评估模型。
This dataset is a subset of SQuAD v1.1 (Stanford Question Answering Dataset), containing 87,599 training question-answer pairs for the machine reading comprehension task. Each sample in the dataset consists of a question and a context passage, from which the model is required to extract the answer span. The dataset is used for training and evaluating models in the MLPerf benchmark.
数据集概述
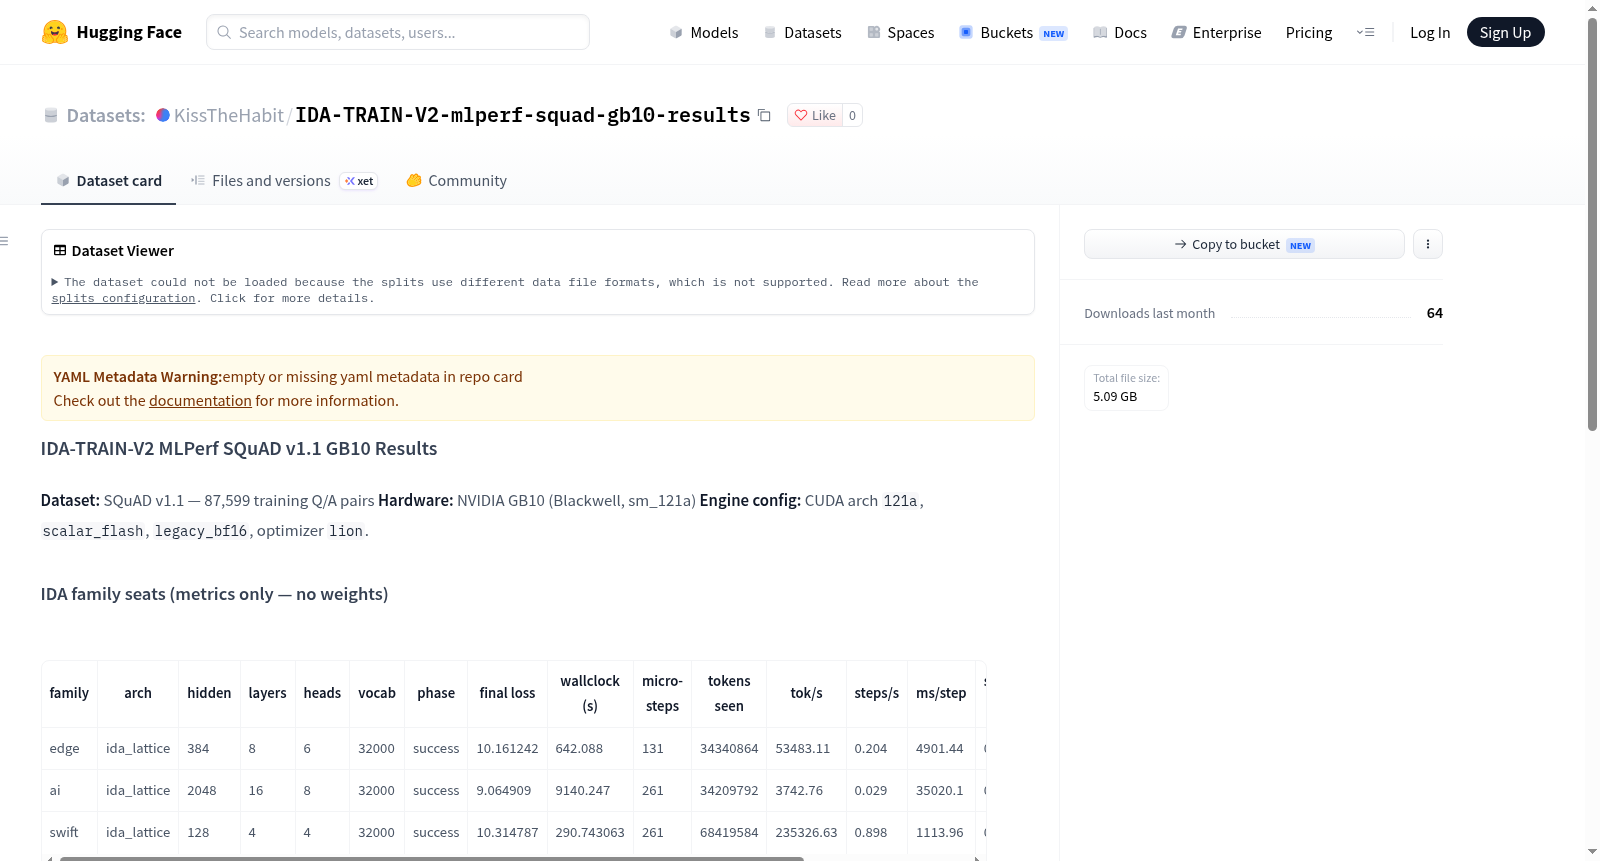
该数据集为 IDA-TRAIN-V2 MLPerf SQuAD v1.1 GB10 Results,基于 SQuAD v1.1 问答数据集,包含 87,599 个训练问答对。硬件平台为 NVIDIA GB10(Blackwell 架构,sm_121a),引擎配置采用 CUDA 架构 121a、scalar_flash、legacy_bf16,优化器为 lion。
1. IDA 家族训练结果(仅含指标,不含权重)
| 系列 | 架构 | 隐藏层尺寸 | 层数 | 头数 | 词表大小 | 阶段 | 最终损失 | 墙钟时间(秒) | 微步数 | 已见 tokens | tokens/秒 | 步/秒 | 毫秒/步 | 跳过的优化步 | 梯度范数 | 计算量(PFLOPS) |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| edge | ida_lattice | 384 | 8 | 6 | 32000 | 成功 | 10.161242 | 642.088 | 131 | 34,340,864 | 53,483.11 | 0.204 | 4901.44 | 0 | 23.44128 | 12.1 |
| ai | ida_lattice | 2048 | 16 | 8 | 32000 | 成功 | 9.064909 | 9140.247 | 261 | 34,209,792 | 3,742.76 | 0.029 | 35020.1 | 0 | 17.526943 | 12.1 |
| swift | ida_lattice | 128 | 4 | 4 | 32000 | 成功 | 10.314787 | 290.743 | 261 | 68,419,584 | 235,326.63 | 0.898 | 1113.96 | 0 | 8.867636 | 12.1 |
2. 外部开源模型(完整权重与指标另存于各模型仓库)
| 模型 | 仓库 | 架构 | 隐藏层尺寸 | 层数 | 头数 | 词表大小 | 阶段 | 最终损失 | 墙钟时间(秒) | 微步数 | 优化步数 | 已见 tokens | tokens/秒 | 步/秒 | 毫秒/步 | 跳过的优化步 | 梯度范数 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| gpt2 | KissTheHabit/IDA-TRAIN-V2-mlperf-squad-gpt2 |
ida_lattice | 768 | 12 | 12 | 50257 | 成功 | 0.6002 | 1707.868 | 2156 | 539 | 17,661,952 | 10,341.52 | 1.262 | 792.15 | None | None |
| qwen2.5-0.5b | KissTheHabit/IDA-TRAIN-V2-mlperf-squad-qwen2.5-0.5b |
ida_lattice | 896 | 24 | 14 | 151936 | 原生冒烟完成 | 8.685278 | 2226.2875 | 2113 | 529 | 17,309,696 | 7,775.14 | 0.949 | 1053.61 | 415 | 112,485,984.0 |
| smollm2-135m | KissTheHabit/IDA-TRAIN-V2-mlperf-squad-smollm2-135m |
ida_lattice | 576 | 30 | 9 | 49152 | 原生冒烟完成 | 7.449804 | 1295.808 | 2149 | 538 | 17,604,608 | 13,585.82 | 1.658 | 602.98 | 342 | 235,793,360.0 |
3. 各模型附带仓库
每个模型仓库均包含原始 Hugging Face 检查点、原生转换后的检查点、打包的原生输入以及完整的训练输出文件。
- GPT-2:
KissTheHabit/IDA-TRAIN-V2-mlperf-squad-gpt2 - Qwen2.5-0.5B:
KissTheHabit/IDA-TRAIN-V2-mlperf-squad-qwen2.5-0.5b - SmolLM2-135M:
KissTheHabit/IDA-TRAIN-V2-mlperf-squad-smollm2-135m
4. MLPerf 日志
每个运行目录均包含由原生引擎的 MLPerf 风格遥测写入器生成的 mlperf_log.txt 和 training_metrics.jsonl 文件。