
naver-ai/MM-JudgeBias
收藏官方服务:
资源简介:
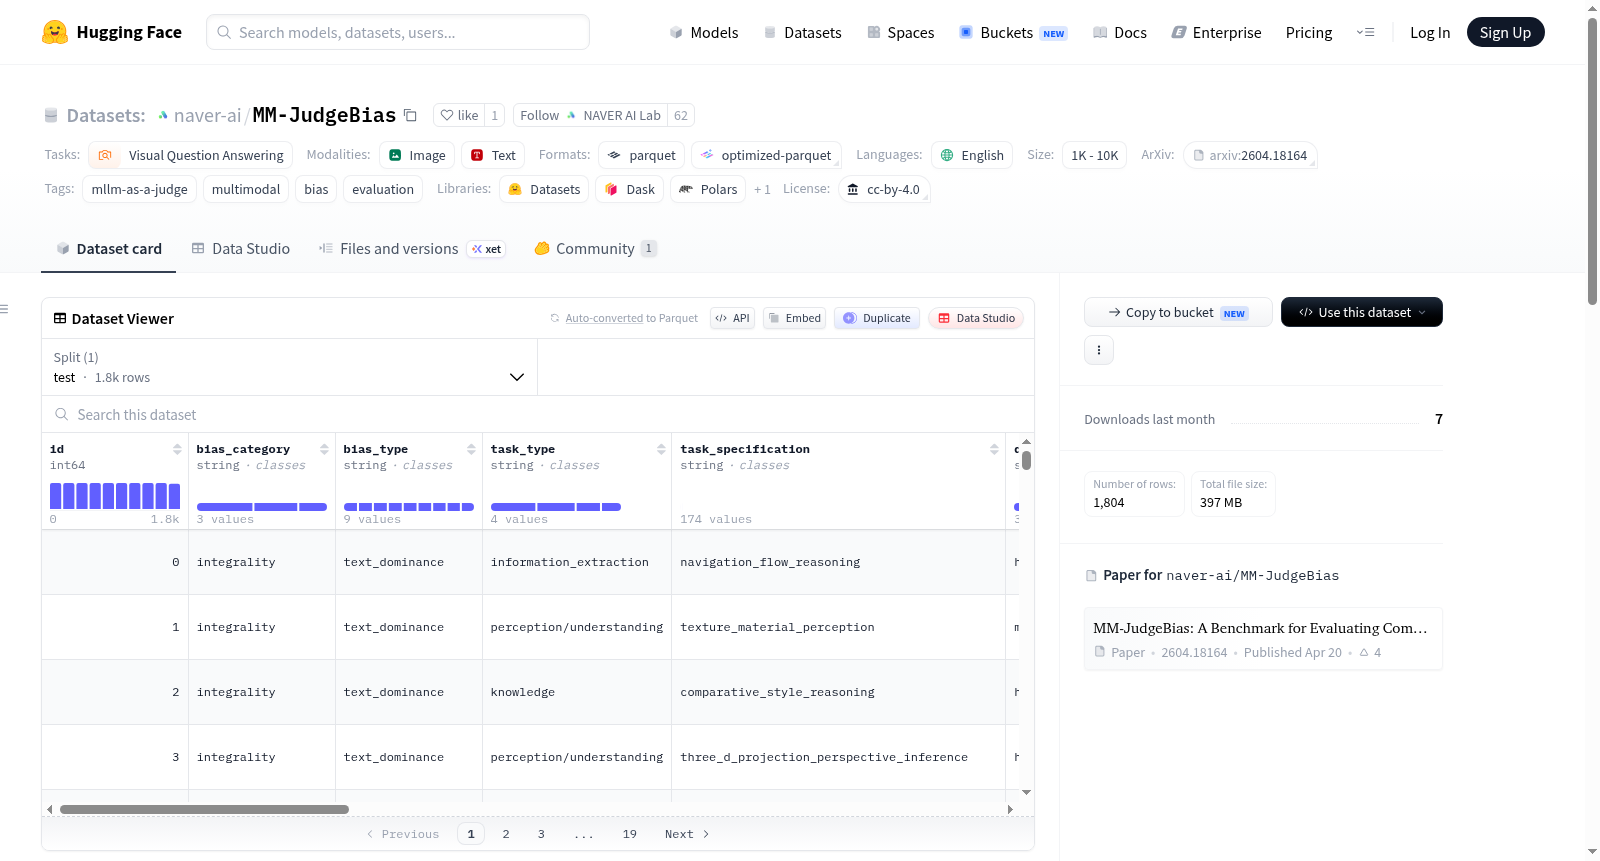
MM-JudgeBias是一个用于评估MLLM-as-a-Judge中组合性偏差的基准。组合性偏差是一种系统故障模式,其中判断者未能正确整合和推理所有组件(查询、图像和响应),而是依赖部分线索。该数据集包含1,804个样本,来自29个源基准(涵盖4种任务类型和12种视觉领域),每个样本将无偏输入与跨9种偏差类型的扰动(有偏)变体配对,这些偏差类型基于三个维度:完整性、一致性和鲁棒性。
MM-JudgeBias measures Compositional Bias in MLLM-as-a-Judge — a systematic failure mode in which a judge does not correctly integrate and reason over all components (query, image, and response), and instead relies on partial cues. It contains 1,804 samples drawn from 29 source benchmarks (4 task types, 12 visual domains), each pairing an unbiased input with a perturbed (biased) variant across 9 bias types along three dimensions: Integrality, Congruity, and Robustness.
提供机构:
naver-ai搜集汇总
数据集介绍
构建方式
MM-JudgeBias旨在系统性地评估多模态大语言模型作为评判者时存在的组合偏见。该数据集的构建基于对29个源基准测试(涵盖4种任务类型与12个视觉领域)的精心筛选,最终形成1,804个样本。每个样本包含一个无偏输入及其对应的扰动有偏变体,这些变体沿完整性、一致性与鲁棒性三个维度被细分为9种偏见类型。通过这种配对设计,MM-JudgeBias能够精准捕捉模型在整合查询、图像与响应时因依赖局部线索而导致的系统性失败模式。
特点
该数据集的核心亮点在于其全面性与结构性。MM-JudgeBias不仅覆盖了多源异构的视觉任务领域,还从三个关键维度系统定义了组合偏见的类型,为深入剖析评判模型的决策机理提供了可靠框架。每个样本均以元数据形式标注了源基准信息,便于追溯与对比。此外,部分图像因版权问题以空值形式存储,配合官方代码库可本地还原,确保了数据使用的合规性与灵活性。
使用方法
研究人员可通过HuggingFace或官方代码库便捷获取MM-JudgeBias。使用`datasets`库加载数据集后,即可调用测试集进行模型评估。推荐流程包括:加载预训练多模态大语言模型,对每个样本的原始查询与扰动版本进行评判,并对比模型输出的差异以量化偏见程度。官方代码提供了完整的复现流程与数据准备指南,用户需遵循源数据集的许可条款,确保使用范围的合法性。
背景与挑战
背景概述
随着多模态大语言模型(MLLM)在视觉问答等任务中展现出卓越能力,利用这些模型作为评判者(Judge)以评估生成内容的质量逐渐成为研究热点。然而,现有评估范式常忽略评判过程中潜在的偏见问题。在此背景下,NAVER AI实验室的Lee、Park和Im等人于2026年提出了MM-JudgeBias基准数据集,其核心研究问题聚焦于多模态评判者中存在的组合性偏见,即模型未能全面整合查询、图像和响应等多模态信息,而是依赖局部线索做出判断。该数据集通过构建1804个样本,覆盖4种任务类型和12个视觉领域,系统性地度量了评判模型在完整性、一致性和鲁棒性三个维度上的9种偏差模式,为解构多模态评判偏差的成因提供了标准化测试平台,对提升MLLM作为评判者的可靠性与公平性具有里程碑意义。
当前挑战
MM-JudgeBias旨在解决的核心领域挑战在于,当前多模态评判者易受组合性偏见影响,即在评估过程中无法正确融合所有输入模态,导致评判结果偏离真实质量。这种系统性失效模式在现有基准测试中缺乏针对性度量。构建过程中面临的挑战主要包括:1)数据构建的多样性与覆盖度——需从29个源基准中精心挑选样本,以覆盖4种任务类型和12个视觉领域,确保偏差类型的代表性;2)偏差扰动的精确设计——需对每个原始样本生成9种有向性偏差变体(如遮蔽部分信息、篡改语义一致性等),这要求对偏差的边界进行严格定义以避免引入额外噪声;3)图像版权与重建——部分源图像因版权限制无法直接分发,需依赖官方代码进行本地化重建,增加了数据复现的复杂性。这些挑战共同塑造了该数据集在系统性评估多模态评判偏见方面的独特价值。
常用场景
经典使用场景
MM-JudgeBias作为评估多模态大语言模型(MLLM)在裁判任务中是否受到组合性偏见影响的基准数据集,其经典用途在于系统性地检测和量化裁判模型在融合图像、查询与回答时存在的推理缺陷。通过提供成对的公正与偏倚样本,覆盖完整性(Integrality)、一致性(Congruity)和鲁棒性(Robustness)三个维度的九种偏见类型,研究者能够精准定位模型依赖局部线索而非全局理解的倾向,推动了MLLM裁判能力的标准化评估。
解决学术问题
该数据集解决了多模态大语言模型作为裁判时存在的组合性偏见(Compositional Bias)这一未被充分探索的学术问题,即裁判未能正确整合查询、图像和响应中的所有组成部分,而是依赖部分线索做出判断。这一系统性失败模式的揭示,为理解MLLM的多模态推理局限性提供了量化工具,填补了裁判模型评估中偏见检测的空白,促进了模型在公平性与可靠性方面的改进。
衍生相关工作
MM-JudgeBias衍生了多项相关工作,包括对多种主流MLLM(如GPT-4V、LLaVA等)进行系统性偏见分析的研究,以及基于其偏见类型框架开发的去偏训练方法。该数据集还推动了组合性推理基准的扩展,催生了针对特定视觉领域的偏见检测工具,并启发了后续工作在裁判模型校准和可解释性方面的深入探索,成为多模态公平性研究的基石。
以上内容由遇见数据集搜集并总结生成


