
LMArena-SFT-Winners-Rextro
收藏官方服务:
资源简介:
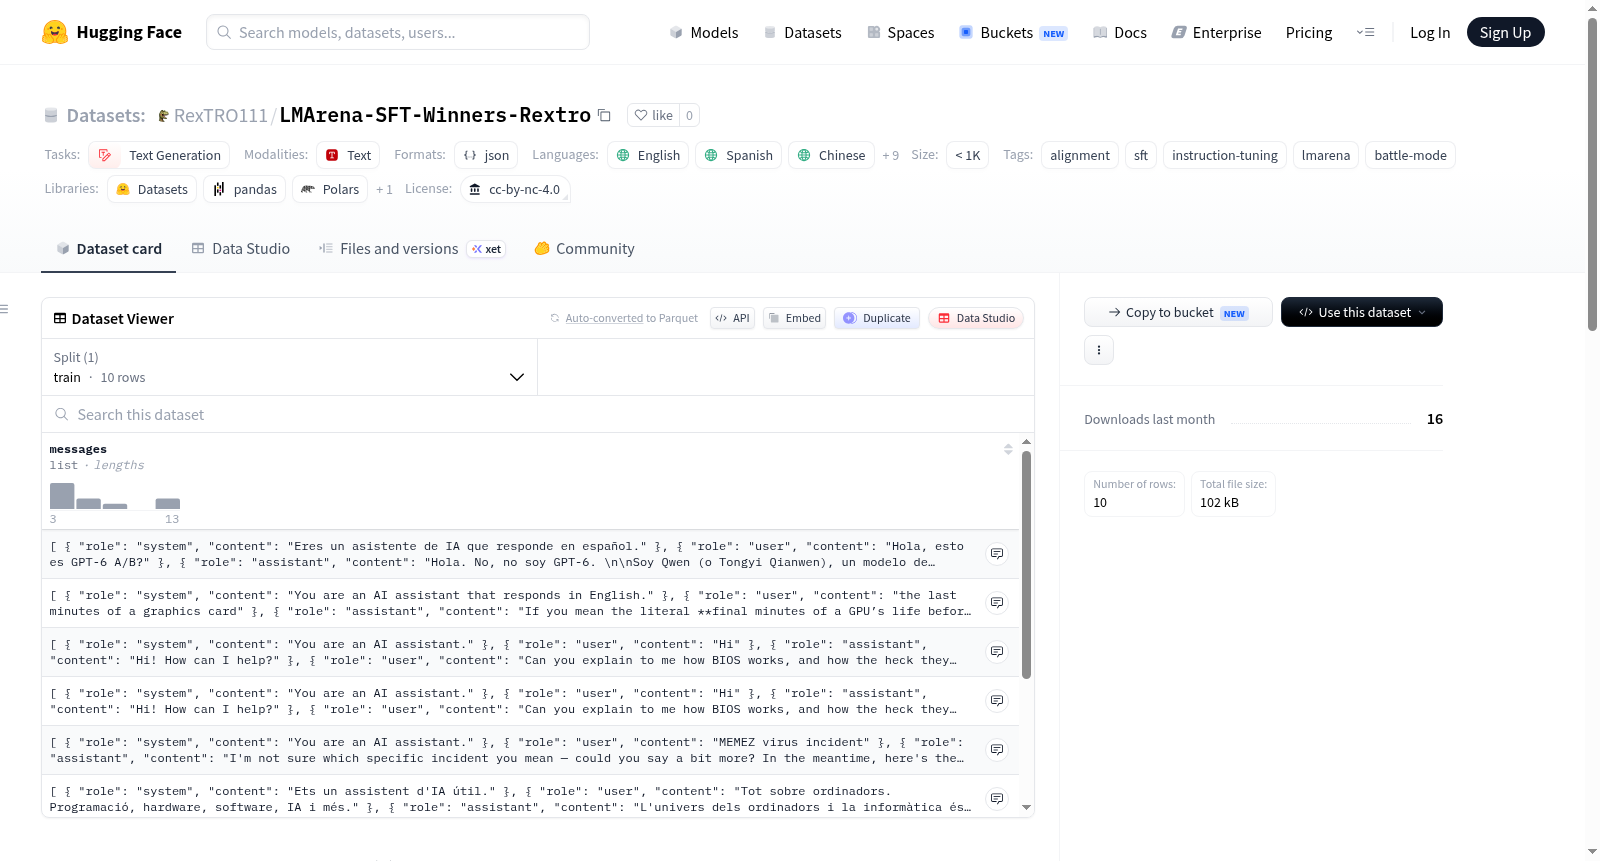
LMArena-SFT-Winners是一个精心筛选的监督微调数据集,专门用于语言模型的对齐和指令调优。其所有模型响应均严格来自LMArena平台Battle Mode中头对头战斗的获胜输出,通过过滤失败的补全,确保数据集中包含经过人类偏好筛选的高质量目标响应。数据集采用标准的Hugging Face聊天/消息格式,包含多轮对话和单轮提示,每个样本由messages字段组成,该字段是一个消息对象列表,每个对象包含role(用户或助手)和content(文本内容)两个子字段,其中最后一个助手消息的内容即为竞技场比赛中胜出的模型输出。数据集支持包括英语、中文、西班牙语、日语等在内的12种语言,主要适用于监督微调任务,用于训练或指令调优开源大语言模型以生成更符合人类偏好的响应,同时也适用于学术研究,用于分析不同模型架构下获胜输出的结构和风格特征。数据集采用CC BY-NC 4.0许可证,需要注意的是,其中包含的文本补全由第三方专有AI模型(如OpenAI、Anthropic、Google等)以及开源模型生成,使用本数据集必须遵守相应模型提供者的服务条款,且仅限于非商业研究、评估和学术目的。
创建时间:
2026-07-26
原始信息汇总
数据集概述
- 数据集名称: LMArena SFT Winners (LMArena-SFT-Winners)
- 数据集类型: 监督微调(SFT)数据集
- 语言: 包括英语、西班牙语、中文、日语、俄语、葡萄牙语、韩语、波兰语、罗马尼亚语、法语、意大利语、印尼语等12种语言。
- 许可协议: Creative Commons Attribution-NonCommercial 4.0 International (CC BY-NC 4.0)
- 任务类别: 文本生成
数据集结构
- 格式: 采用Hugging Face标准聊天/消息格式,每个样本包含一个
messages列表,列表中的每个元素是一个包含role(角色)和content(内容)的对象。 - 数据字段:
messages: 表示会话轮次的消息对象列表。role: 说话者的角色(user或assistant)。content: 消息的文本内容,其中最后一条助手指令的回复代表竞技场对战中的获胜输出。
数据来源与构建
- 该数据集从Battle Mode的头对头对战中筛选出获胜输出,剔除了失败的回复,从而提供经过人类偏好过滤的高质量目标回复,用于直接指令微调和对齐。
预期用途
- 监督微调(SFT): 用于在人类偏好的回复上训练或指令微调开源大语言模型。
- 学术研究: 分析不同模型架构下竞技场获胜输出的结构和风格特征。
许可与使用注意事项
- 数据集包含由第三方专有AI模型(包括但不限于OpenAI、Anthropic、Google等公司模型)以及开源模型生成的文本回复。
- 使用本数据集必须遵守相应模型提供者的服务条款,且仅用于非商业研究、评估和学术目的。
搜集汇总
数据集介绍
构建方式
LMArena-SFT-Winners-Rextro 数据集基于对抗竞技场(Battle Mode)中的模型对战结果构建而成。在每一场对决中,多个大型语言模型针对同一提示生成回复,并通过人类偏好评估筛选出获胜输出。该数据集仅保留被判定为优胜者的回复,剔除失败方的内容,从而形成由人类偏好驱动的高质量监督微调样本。数据集采用 Hugging Face Chat / Messages 标准格式组织,每条样本包含多轮或单轮对话,其中 messages 字段以 role 和 content 键值对的形式记录用户输入与获胜助手的回复。
特点
该数据集的核心特色在于其数据源来源于真实的人类偏好投票,而非自动化的对抗生成或评分模型,因而具备较高的对齐质量与反馈真实性。数据集覆盖英语、西班牙语、中文、日语、俄语等十余种语言,适用于多语言场景下的指令微调与对齐研究。每个样本中的助手回复均为来自包括 OpenAI、Anthropic、Google 及开源模型在内的多种架构的获胜输出,兼具多样性与代表性,为学术研究提供了丰富的分析素材。
使用方法
该数据集主要面向基于监督微调(SFT)的对齐训练任务,可直接与 Hugging Face 生态中的 trl、SFTTrainer 及 apply_chat_template 管道集成使用。用户通过加载 messages 字段并应用合适的聊天模板,即可构建出用于微调模型的输入-目标对。同时,该数据集也适用于对获胜回复的结构与风格进行对比分析,以揭示不同模型在人类偏好视角下的表现差异。数据使用须遵守 CC BY-NC 4.0 许可协议及第三方模型服务条款,仅限非商业研究与学术目的。
背景与挑战
背景概述
在大语言模型快速迭代的当下,如何高效获取符合人类偏好的高质量指令微调数据成为提升模型对齐能力的关键瓶颈。LMArena-SFT-Winners-Rextro数据集应运而生,由LMSYS组织于2024年基于其Battle Mode平台构建,汇集了多轮对话与单轮提示中经人机对抗筛选出的优胜模型回复。该数据集以标准化Chat格式封装,兼容Hugging Face生态下的SFT训练流程,为研究者提供了直接基于人类偏好过滤后的目标完成序列,显著推进了监督微调与对齐领域的研究进程,在学术界与工业界引发了广泛关注。
当前挑战
该数据集所应对的核心领域挑战在于:传统指令微调数据集常依赖人工标注或单一模型生成,难以客观反映多元人类偏好,导致模型对齐效果受限。LMArena-SFT-Winners通过竞技场模式引入多模型对抗,虽有效甄别了优胜输出,但构建过程仍面临多重困难:首先,从海量对抗数据中精确提取胜者样本需克服众包标注的不一致性;其次,需严格确保多语言、多轮对话场景下回复质量的跨文化稳健性;此外,遵守第三方专有模型的使用条款与知识共享许可的非商业限制,也为数据集的规模化扩展与分发增添了法律与伦理复杂性。
常用场景
经典使用场景
LMArena-SFT-Winners-Rextro 数据集的核心设计理念在于从激烈的模型竞技对决中筛选出优胜者的输出,从而构建一个高质量、符合人类偏好的指令微调语料库。在经典使用场景中,研究人员将其直接馈送至诸如 SFTTrainer 或 TRL 等标准框架中,利用 Hugging Face 的 apply_chat_template 管道对开源大语言模型进行监督微调。由于数据严格保留了多轮或单轮对话中获胜方的完整回复,该数据集能够有效引导模型学习更优的对话生成策略,从而显著提升模型在推理、生成及指令遵循方面的性能表现。
衍生相关工作
该数据集的发布催生了一系列旨在探索偏好学习机制的后续工作。研究者利用其清晰的胜负标签,深入分析了不同层级的模型在生成质量上的系统差异,从而催生了基于竞技数据的奖励模型训练新范式。此外,部分工作聚焦于研究“获胜输出”的句法复杂性与互动流畅性之间的内在关联,进而开发出更精细化的自动评估指标。这些衍生工作不仅巩固了竞技数据在模型对齐领域的基础地位,也启发了诸如混合奖励信号设计、偏好融合等前沿方向,共同构建了一个不断演进的研究生态。
数据集最近研究
最新研究方向
LMArena-SFT-Winners-Rextro数据集聚焦于从大规模语言模型竞技场(Battle Mode)中筛选人类偏好的优胜输出,为监督微调(SFT)与对齐研究提供高质量训练语料。当前前沿方向包括:利用该数据集分析不同架构模型在对抗性对话中的策略差异,探索优胜响应的语义特征与风格模式;结合指令微调技术,优化开源模型在复杂场景下的应答质量与安全性;以及通过跨语言多轮对话数据(覆盖中、英、日、法等语言),推动多语言对齐研究。该数据集紧扣大模型对齐领域的热点——从人类反馈中学习(RLHF)与偏好优化,其基于真实竞技数据的筛选机制显著降低了人工标注成本,为研究模型合作与竞争行为、提升模型实用性与可控性提供了关键基准。
以上内容由遇见数据集搜集并总结生成


