
profiles_dataset_20000_uniform_r17
收藏官方服务:
资源简介:
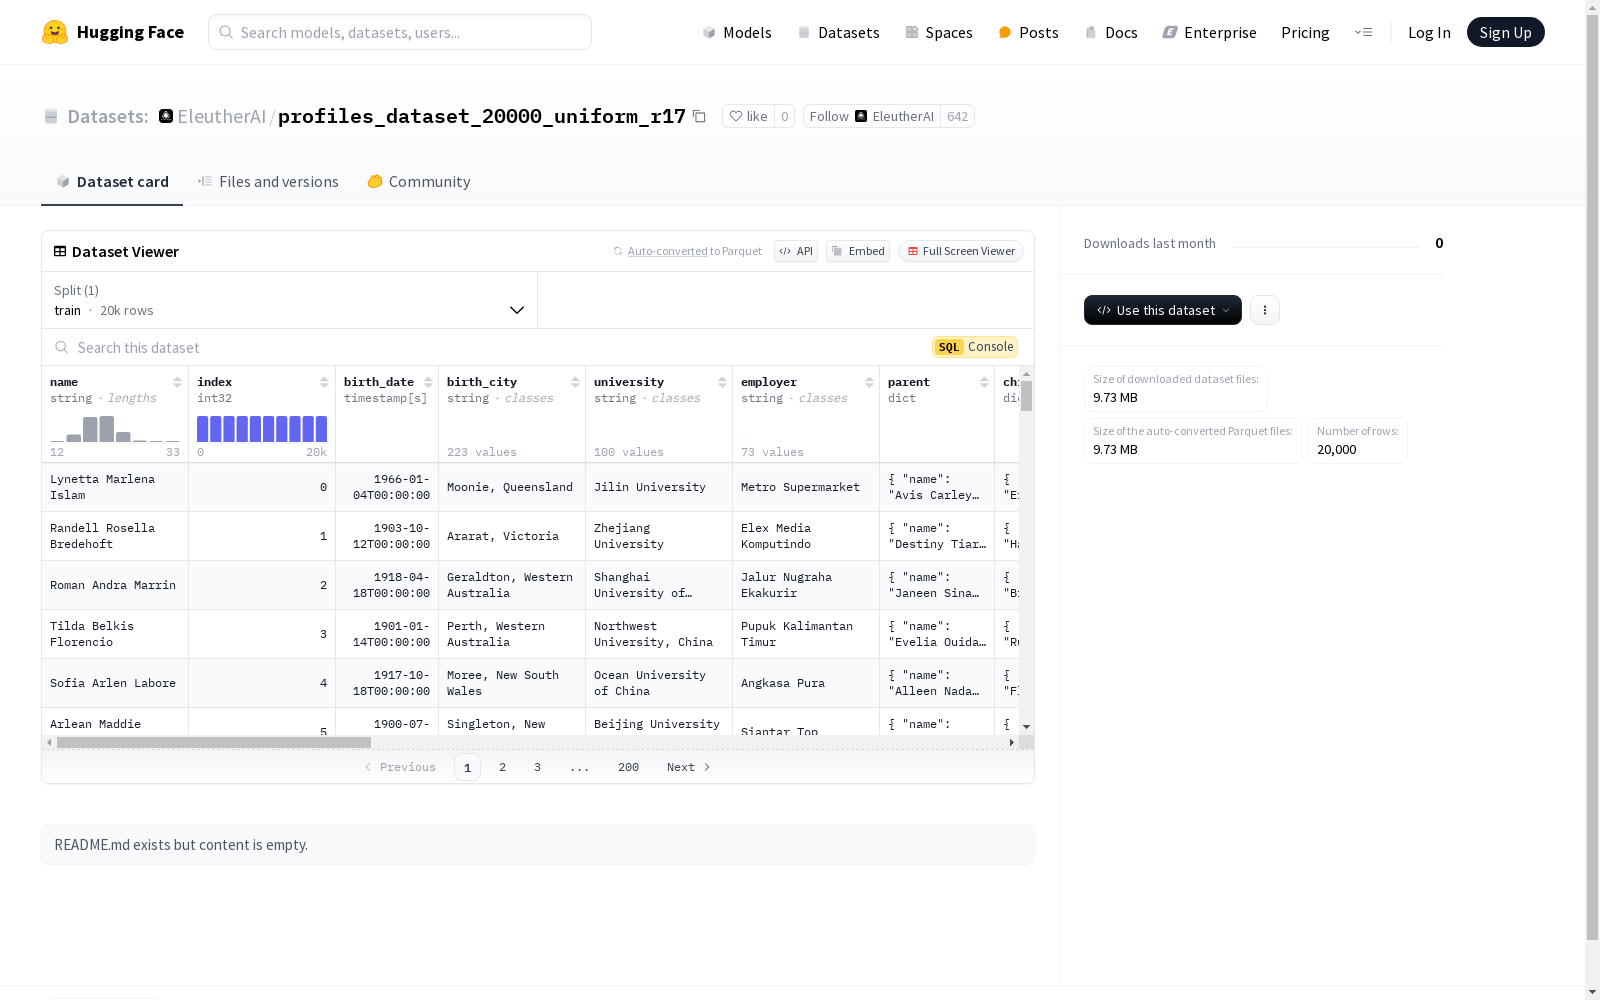
该数据集包含多个特征字段,如姓名、索引、出生日期、出生城市、大学、雇主等。此外,数据集还包含多个结构化字段,如父母、孩子、最好的朋友、最坏的敌人等,这些结构化字段进一步包含姓名和索引两个子字段。数据集还包含一个名为'bio'的字符串字段。数据集的分割信息显示,训练集包含20,000个样本,文件大小为12,177,639字节。
This dataset contains multiple feature fields, such as name, index, date of birth, birth city, university, employer, etc. Additionally, it includes several structured fields including parents, children, best friends, worst enemies, etc. Each of these structured fields further contains two sub-fields: name and index. The dataset also includes a string field named "bio". The dataset split information shows that the training set has 20,000 samples with a file size of 12,177,639 bytes.
提供机构:
EleutherAI创建时间:
2025-01-10
原始信息汇总
数据集概述
数据集基本信息
- 数据集名称: profiles_dataset_20000_uniform_r17
- 数据集地址: https://huggingface.co/datasets/EleutherAI/profiles_dataset_20000_uniform_r17
- 数据集大小: 12,177,639 字节
- 下载大小: 9,725,701 字节
- 样本数量: 20,000 个
数据集特征
数据集包含以下特征:
- name: 字符串类型,表示姓名。
- index: 整数类型,表示索引。
- birth_date: 时间戳类型,表示出生日期。
- birth_city: 字符串类型,表示出生城市。
- university: 字符串类型,表示大学。
- employer: 字符串类型,表示雇主。
- parent: 结构体类型,包含以下子特征:
- name: 字符串类型,表示父母姓名。
- index: 整数类型,表示父母索引。
- child: 结构体类型,包含以下子特征:
- name: 字符串类型,表示子女姓名。
- index: 整数类型,表示子女索引。
- best_friend: 结构体类型,包含以下子特征:
- name: 字符串类型,表示最好的朋友姓名。
- index: 整数类型,表示最好的朋友索引。
- worst_enemy: 结构体类型,包含以下子特征:
- name: 字符串类型,表示最坏的敌人姓名。
- index: 整数类型,表示最坏的敌人索引。
- sibling: 结构体类型,包含以下子特征:
- name: 字符串类型,表示兄弟姐妹姓名。
- index: 整数类型,表示兄弟姐妹索引。
- spouse: 结构体类型,包含以下子特征:
- name: 字符串类型,表示配偶姓名。
- index: 整数类型,表示配偶索引。
- cousin: 结构体类型,包含以下子特征:
- name: 字符串类型,表示表亲姓名。
- index: 整数类型,表示表亲索引。
- grandparent: 结构体类型,包含以下子特征:
- name: 字符串类型,表示祖父母姓名。
- index: 整数类型,表示祖父母索引。
- grandchild: 结构体类型,包含以下子特征:
- name: 字符串类型,表示孙子女姓名。
- index: 整数类型,表示孙子女索引。
- business_partner: 结构体类型,包含以下子特征:
- name: 字符串类型,表示商业伙伴姓名。
- index: 整数类型,表示商业伙伴索引。
- protege: 结构体类型,包含以下子特征:
- name: 字符串类型,表示门徒姓名。
- index: 整数类型,表示门徒索引。
- mentor: 结构体类型,包含以下子特征:
- name: 字符串类型,表示导师姓名。
- index: 整数类型,表示导师索引。
- betrayer: 结构体类型,包含以下子特征:
- name: 字符串类型,表示背叛者姓名。
- index: 整数类型,表示背叛者索引。
- debtor: 结构体类型,包含以下子特征:
- name: 字符串类型,表示债务人姓名。
- index: 整数类型,表示债务人索引。
- blackmailer: 结构体类型,包含以下子特征:
- name: 字符串类型,表示敲诈者姓名。
- index: 整数类型,表示敲诈者索引。
- hero: 结构体类型,包含以下子特征:
- name: 字符串类型,表示英雄姓名。
- index: 整数类型,表示英雄索引。
- evil_twin: 结构体类型,包含以下子特征:
- name: 字符串类型,表示邪恶双胞胎姓名。
- index: 整数类型,表示邪恶双胞胎索引。
- bio: 字符串类型,表示个人简介。
数据集划分
- 训练集: 包含 20,000 个样本,大小为 12,177,639 字节。
配置文件
- 默认配置: 包含训练集数据文件,路径为
data/train-*。
搜集汇总
数据集介绍
构建方式
该数据集通过系统化的数据收集与结构化处理,构建了一个包含20,000条个人档案的丰富数据集。每条记录均包含姓名、出生日期、出生城市、教育背景、工作单位等基本信息,同时涵盖了复杂的社交关系网络,如家庭成员、朋友、敌人等。数据以时间戳和结构化字段的形式存储,确保了信息的完整性与可追溯性。
特点
该数据集的特点在于其多维度的信息覆盖与高度结构化的数据组织。每条记录不仅包含个人的基本信息,还详细记录了其社交关系网络,涵盖了从家庭成员到商业伙伴的多种关系类型。这种多层次的数据结构为研究社交网络、人际关系分析等领域提供了丰富的素材。此外,数据集的规模适中,既保证了数据的多样性,又便于处理与分析。
使用方法
该数据集适用于社交网络分析、人际关系研究以及基于个人档案的机器学习任务。研究人员可以通过解析结构化字段,提取个人基本信息与社交关系,构建复杂的关系图谱。在机器学习领域,该数据集可用于训练模型以预测社交关系或生成个人档案。使用前需确保数据格式的兼容性,并注意数据隐私与伦理问题。
背景与挑战
背景概述
profiles_dataset_20000_uniform_r17数据集是一个包含20,000条个人档案信息的数据集,涵盖了从出生日期、出生城市到教育背景、职业经历以及复杂的社会关系网络等多维度信息。该数据集的创建旨在为社会科学、人际关系网络分析以及人工智能领域的相关研究提供丰富的数据支持。通过详细记录个体的家庭关系、朋友关系、敌对关系以及职业关系等,该数据集为研究社会结构、人际关系动态以及个体行为模式提供了重要的数据基础。其核心研究问题聚焦于如何通过大规模数据揭示社会网络中的复杂关系及其对个体行为的影响。
当前挑战
该数据集在解决社会网络分析和个体行为模式研究中的挑战时,面临多重困难。首先,社会关系的多样性和复杂性使得数据标注和关系建模变得极为复杂,尤其是在处理诸如敌对关系、背叛者等负面关系时,数据的准确性和一致性难以保证。其次,数据集的构建过程中,如何确保数据的隐私保护和伦理合规性是一个重要挑战,尤其是在涉及敏感信息如家庭关系和个人背景时。此外,数据的时间跨度较大,如何有效处理时间序列数据并确保其时效性也是一个技术难点。这些挑战不仅影响了数据集的构建质量,也对后续的研究应用提出了更高的要求。
常用场景
经典使用场景
在社交网络分析和人物关系研究中,profiles_dataset_20000_uniform_r17数据集被广泛应用于构建复杂的人际关系网络。通过分析个体的出生日期、出生城市、教育背景、职业信息以及各种社会关系(如父母、子女、朋友、敌人等),研究者能够深入探讨社会结构中的动态变化和个体行为模式。
实际应用
在实际应用中,profiles_dataset_20000_uniform_r17数据集被用于开发智能推荐系统、社交网络分析工具以及人物关系管理系统。例如,企业可以利用该数据集分析员工之间的关系网络,优化团队协作和沟通效率;社交媒体平台则可以通过分析用户之间的关系,提供更加个性化的内容推荐和社交互动建议。
衍生相关工作
基于profiles_dataset_20000_uniform_r17数据集,研究者们已经开发了多种经典的社会网络分析算法和模型。例如,一些研究利用该数据集构建了基于图神经网络的社会关系预测模型,能够准确预测个体之间的潜在关系。此外,该数据集还被用于开发基于时间序列的社会网络演化模型,揭示了社会关系随时间变化的规律。
以上内容由遇见数据集搜集并总结生成


