
qfzcxdl/StockData
收藏官方服务:
资源简介:
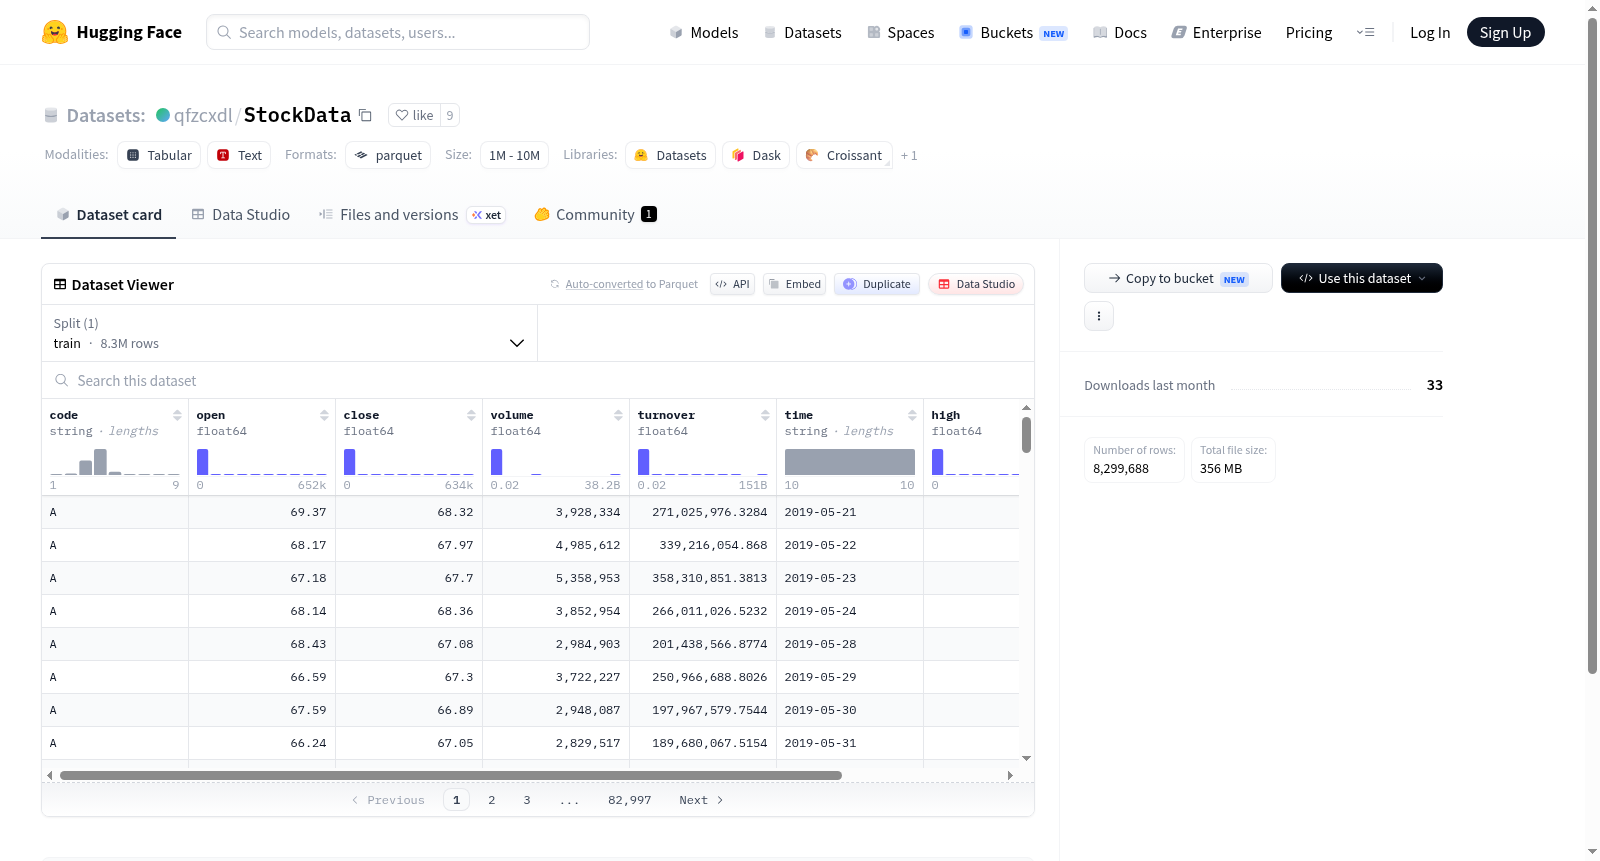
该数据集可能包含股票交易数据,特征字段包括股票代码、开盘价、收盘价、交易量、成交额、时间、最高价和最低价。数据集分为训练集,包含8,299,688个样本,总大小为578,619,716字节。
This dataset may include stock trading data, with its feature fields covering stock code, opening price, closing price, trading volume, trading turnover, timestamp, highest price, and lowest price. The dataset is split into a training set that contains 8,299,688 samples, with a total size of 578,619,716 bytes.
提供机构:
qfzcxdl原始信息汇总
数据集信息
特征
- code: 类型为字符串
- open: 类型为浮点数 (float64)
- close: 类型为浮点数 (float64)
- volume: 类型为浮点数 (float64)
- turnover: 类型为浮点数 (float64)
- time: 类型为字符串
- high: 类型为浮点数 (float64)
- low: 类型为浮点数 (float64)
数据分割
- train: 包含 8299688 个样本,总大小为 578619716 字节
数据集大小
- 下载大小: 355599177 字节
- 数据集大小: 578619716 字节
配置
- default:
- 数据文件:
- split: train
- path: data/train-*
- 数据文件:
搜集汇总
数据集介绍
构建方式
在金融数据科学领域,高质量的历史行情数据集是量化分析与模型训练的基石。qfzcxdl/StockData数据集通过系统采集股票市场的交易记录构建而成,每条样本包含股票代码、开盘价、收盘价、最高价、最低价、成交量、成交额及时间戳等核心字段。数据以浮点数和字符串类型精确存储,确保数值精度与时间序列的完整性。该数据集整合了超过829万条训练样本,总数据量达578MB,经过压缩处理后便于分发与存储。其构建过程注重数据的标准化与结构化,为金融时间序列分析提供了可靠的原始素材。
使用方法
使用该数据集时,可通过HuggingFace的datasets库直接加载,指定配置名称为'default'即可获取训练集数据。数据以Parquet格式分片存储,支持流式读取与高效内存管理。用户可依据股票代码字段进行分组操作,或利用时间戳字段构建时序特征。对于深度学习框架,数据集可无缝转换为PyTorch或TensorFlow的数据迭代器。建议在加载后对价格数据进行归一化处理,并将时间字段解析为datetime对象以增强时间序列分析能力。该数据集特别适合用于股票价格预测、交易量分析及市场微观结构研究等任务。
背景与挑战
背景概述
在金融科技蓬勃发展的当下,量化投资与智能投顾对高质量时序数据的需求日益迫切。qfzcxdl/StockData数据集由研究团队于近年创建,旨在为股票市场分析提供标准化的训练资源。该数据集涵盖了从开盘价、收盘价、最高价、最低价到成交量与成交额等核心交易指标,并附带时间戳与股票代码,为多维度市场行为建模奠定了坚实基础。其核心研究问题聚焦于如何利用大规模历史交易数据训练深度学习模型,以捕捉股价波动中的非线性规律与市场微观结构特征。该数据集的发布显著推动了金融时间序列预测、异常检测及高频交易策略研究,成为相关领域学者验证算法有效性的重要基准之一。
当前挑战
该数据集所解决的领域问题在于金融时间序列预测中的非平稳性与噪声干扰,传统统计模型难以有效处理市场突发事件导致的分布偏移与高频波动。构建过程中面临的首要挑战是数据清洗与对齐,不同交易所的原始数据在时间戳精度、复权因子及停牌处理上存在差异,需设计统一规则以保证序列连续性。其次,大规模数据存储与高效加载成为瓶颈,近830万样本需优化内存占用与I/O效率,避免训练时出现瓶颈。此外,特征工程中需平衡信息完备性与过拟合风险,仅包含价格与成交量指标可能无法充分反映市场微观结构,而引入额外因子又会增加模型复杂度与计算成本。
常用场景
经典使用场景
在金融时序分析领域,qfzcxdl/StockData数据集凭借其涵盖开盘价、收盘价、最高价、最低价、成交量及成交额等核心指标的结构化特征,成为构建股票价格预测与市场波动建模的经典基准。研究者常利用其高频率的时间序列数据,训练长短期记忆网络(LSTM)或Transformer架构,以捕捉价格动态中的非线性依赖与趋势模式。该数据集的大规模样本容量(逾八百万条记录)为深度学习模型提供了充足的训练素材,使得从历史行情中挖掘统计规律成为可能,进而支撑起量化投资策略的实证检验与回测框架的搭建。
解决学术问题
该数据集有效回应了金融计量经济学中的核心难题——如何在高噪声环境下实现资产价格的可靠预测。它助力学者突破传统自回归模型(如ARIMA)在捕捉市场微观结构突变方面的局限,通过提供标准化、可复现的行情数据,推动了基于机器学习的收益率方向预测、波动率聚类分析以及风险价值(VaR)估计等研究议题的深化。其意义在于为跨市场比较与模型泛化能力评估提供了统一的数据基石,从而促进了金融时间序列分析方法的严谨性演进与学术共识的形成。
实际应用
在实际产业应用中,qfzcxdl/StockData数据集为量化交易系统的研发提供了关键支撑。金融机构可借此训练日内高频交易信号识别模型,优化买卖时点决策;资产管理部门则能利用其历史波动特征,构建动态风险敞口调整策略。此外,该数据还赋能智能投顾平台,通过分析量价关系生成个性化的投资建议,并在合规框架下辅助监管机构进行市场异常交易行为的模式识别,从而提升金融市场的运行效率与稳定性。
数据集最近研究
最新研究方向
在金融科技与量化投资深度融合的浪潮中,StockData数据集凭借其涵盖开盘价、收盘价、成交量、成交额及最高最低价等关键交易指标的精细结构,成为推动高频交易策略与市场微观结构研究的重要基石。当前前沿研究方向聚焦于利用该数据集的时序特征,结合深度学习模型如Transformer和LSTM,构建能够捕捉市场非线性动态的预测系统,尤其在中美股市波动率预测与算法交易优化领域引发广泛关注。该数据集的大规模样本量(超820万条记录)为训练稳健的金融时间序列模型提供了充足素材,助力研究者探索市场异常事件如闪崩或财报季的价量关联模式。其意义在于弥合传统金融理论与数据驱动方法间的鸿沟,为风险管理和智能投顾系统的迭代提供实证基础,进而推动金融数据标准化在学术与工业界的应用边界。
以上内容由遇见数据集搜集并总结生成


