
遇见数据集

sungkwang2/klingon-en-tlh-translation

收藏
Hugging Face2026-05-29 更新2026-05-31 收录
官方服务:

资源简介:

该数据集是一个用于英语和克林贡语(Klingon)双向机器翻译的数据集,基于OPUS Tatoeba en-tlh v2023-04-12(采用CC-BY 4.0许可)构建,并经过重复数据删除处理。数据集包含训练集(12,717条样本)、验证集(500条样本)和测试集(500条样本)。数据格式为JSONL,每个文件对应不同的翻译方向:*.jsonl文件用于英语→克林贡语翻译,*_tlh2en.jsonl文件用于克林贡语→英语翻译。每条数据包含instruction、output、en(英语文本)和klingon(克林贡语文本)字段。该数据集旨在支持自然语言处理研究,特别是用于比较自回归模型(如Qwen2.5-7B)和扩散模型(如Fast-dLLM v2 7B)在翻译任务上的性能。

This dataset is a bilingual machine translation dataset for English and Klingon, based on OPUS Tatoeba en-tlh v2023-04-12 (under CC-BY 4.0 license) with deduplication applied. It includes a training set (12,717 samples), validation set (500 samples), and test set (500 samples). The data is in JSONL format, with separate files for translation directions: *.jsonl for English→Klingon translation and *_tlh2en.jsonl for Klingon→English translation. Each line contains fields: instruction, output, en (English text), and klingon (Klingon text). The dataset is designed for NLP research, specifically for comparing the performance of autoregressive models (e.g., Qwen2.5-7B) and diffusion models (e.g., Fast-dLLM v2 7B) on translation tasks.
提供机构:
sungkwang2
搜集汇总
数据集介绍
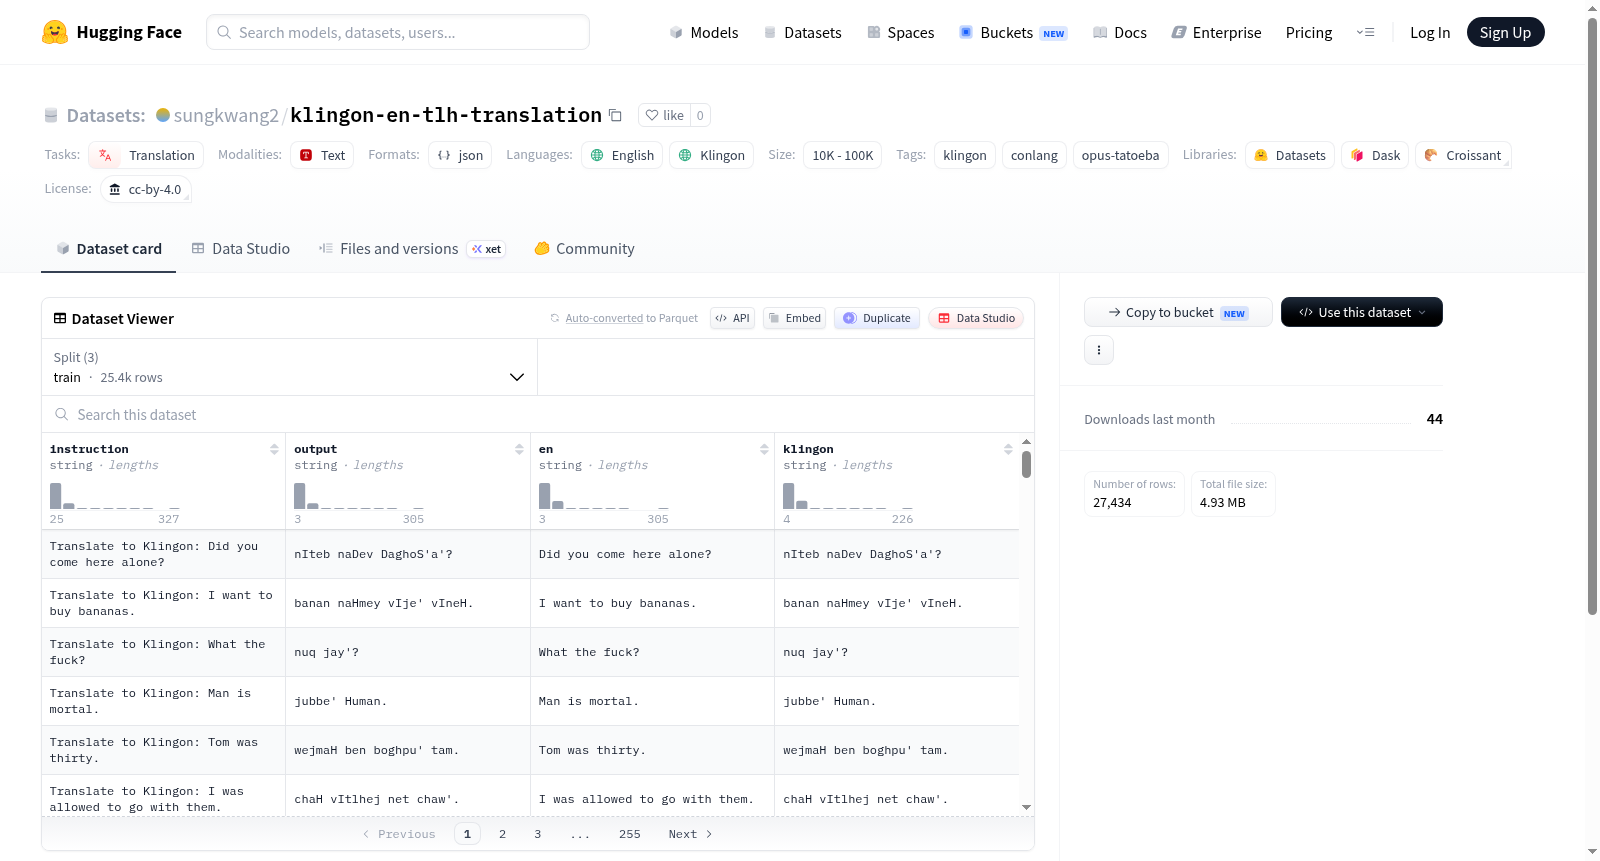
sungkwang2/klingon-en-tlh-translation 数据集图片
构建方式
本数据集基于OPUS Tatoeba项目中的en-tlh平行语料,抽取2023年4月12日发布的版本,在去除重复条目后构建而成。数据集划分为训练集12,717条、验证集500条以及测试集500条,确保评估的均衡性。每条数据以JSONL格式存储,包含“instruction”、“output”、“en”与“klingon”四个字段,其中“en”字段存储英语原文,“klingon”字段则为对应的克林贡语译文。数据集还特别提供双向格式:默认的`*.jsonl`文件用于英语到克林贡语的翻译任务,而`*_tlh2en.jsonl`文件则面向克林贡语到英语的逆向翻译需求。
特点
该数据集专为低资源人工语言(conlang)翻译研究而设计,聚焦于克林贡语这一虚构语言的机器翻译建模。其最大特点在于双向平行语料的完整性,支持英语到克林贡语及克林贡语到英语两种翻译方向的统一训练与评价。数据集容量虽小,但经过严格去重,保证了语料的纯净度。同时,引入指令跟随(instruction-following)字段结构,使其不仅适用于传统序列到序列模型,还能自然适配大语言模型(LLM)的微调范式,为跨语言与跨模型体系(如自回归模型与扩散模型)的比较研究提供标准基准。
使用方法
本数据集主要面向使用Hugging Face Transformers等框架的机器翻译实验。用户可直接加载`*.jsonl`文件,依据任务方向选择对应文件:英语到克林贡语使用默认文件,反向任务则使用带`_tlh2en`标识的文件。每条数据中的“instruction”字段可忽略或充当任务提示,“output”为模型预测的目标字段,“en”和“klingon”提供明确的双语对照。该数据集已预设用于对比自回归模型(如Qwen2.5-7B)与扩散模型(Fast-dLLM v2 7B)在全参数微调下的翻译表现,研究者可参照此设置进行复现或拓展实验。
背景与挑战
背景概述
克林贡语(Klingon)作为全球影响力最为深远的构造语言之一,其语言学结构与文化背景在科幻领域及计算语言学中均具有独特的学术地位。该数据集即聚焦于克林贡语与英语之间的翻译任务,由研究者基于OPUS Tatoeba语料库(v2023-04-12版本)构建,经过去重处理后形成包含训练集12,717条、验证集500条及测试集500条的高质量双语语料。数据集的创建旨在探索低资源、小众语言在神经机器翻译中的挑战与潜力,尤其关注构造语言(conlang)场景下的跨语言迁移能力。通过提供双向平行语料(en→tlh与tlh→en),该数据集为研究非自然语言的语义对齐、语法结构的译码机制,以及对比不同模型架构(如自回归与扩散模型)在极端稀疏数据条件下的表现,提供了关键的基准平台。其发布对推动语言多样性下的机器翻译技术,以及深化对人工语言与自然语言交互的理解,均具有开创性的研究意义。
当前挑战
该数据集所面临的挑战首先源于克林贡语作为构造语言的根本特性:其语法结构、词汇体系与自然语言之间存在显著差异,且缺乏大规模自然语料支持,导致翻译任务需同时应对稀疏数据与句法不对齐的困难。其次,在构建过程中,从Tatoeba多语料库中提取高质量、低噪声的平行句子对本身即为难题,需通过严格去重与人工校验来保障语料纯净度。此外,双语语料规模仅约1.2万条训练数据,远低于主流机器翻译数据集(如WMT系列)的百万级体量,这使得模型容易陷入过拟合,且难以学习到领域外或长尾表达模式。设计能够在此类极端低资源条件下实现稳健推理的模型架构,兼顾语义保真度与语法规范性,是研究中的核心技术挑战。
常用场景
经典使用场景
在自然语言处理与计算语言学的交汇处,人工语言(conlang)与自然语言的平行语料库为跨语言翻译研究开辟了独特疆域。klingon-en-tlh-translation 数据集收录了约12,717条训练样本、500条验证样本及500条测试样本,专用于克林贡语与英语之间的双向翻译任务。每条数据以JSONL格式存储,包含指令、输出及双语对照字段,方便研究者直接构建序列到序列的翻译模型。该数据集继承了OPUS Tatoeba项目的严谨结构,经过去重处理后确保了数据质量,成为探索稀缺语言资源下机器翻译能力的理想平台。
实际应用
在实际应用中,该数据集不仅服务于科幻文化产业的本地化需求——例如影视作品中克林贡语对话的自动生成与理解,更为重要的是,它为实时多语言通信系统中的罕见语言处理积累了方法论经验。游戏开发商、虚拟现实内容平台及全球化社区沟通工具可以利用该数据集训练轻量级翻译模型,支持用户间以克林贡语进行创造性交流。同时,该数据集验证了人工语言翻译技术在语言教学辅助、跨文化符号解码等新场景中的可行性,有望激发更多关于语言多样性与计算适应性的商业探索。
衍生相关工作
围绕此数据集,学界与工业界已衍生出一系列具有代表性的研究工作。其中最具影响力的是将自回归模型(如Qwen2.5-7B)与扩散模型(如Fast-dLLM v2 7B)在完全相同的数据划分上进行全参数微调后,系统对比两类范式在人工语言翻译任务中的精度与鲁棒性。这一比较实验不仅揭示了扩散模型在长尾词汇生成上的优势,还催生了针对人工语言语法结构的注意力机制优化方案。此外,该数据集被频繁用作多语言零样本翻译的评估基准,并启发了多项关于跨语言知识迁移、罕见语言嵌入表示学习等领域的后续研究,成为连接构造语言与自然语言处理理论的桥梁性资源。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

