
DCAgent3/gaia_127_a3_rl_SankalpKJ_nemotron_code_oracle_filtered_60_8B_20260526_201849-traces
收藏数据链接:
官方服务:
资源简介:
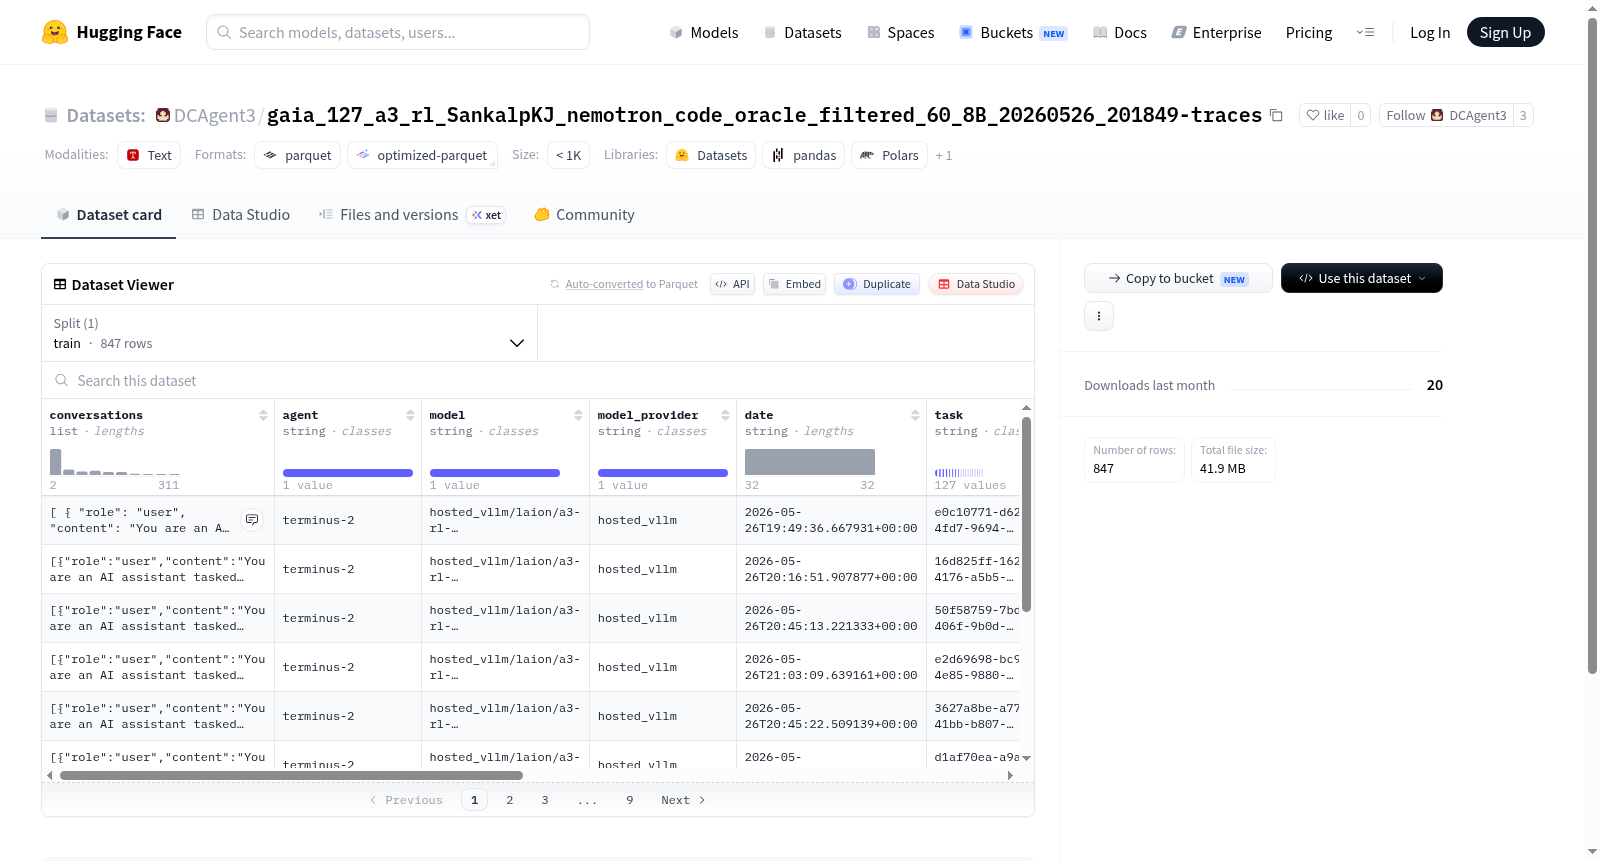
该数据集包含多智能体对话和任务执行记录,特征包括对话内容(角色和消息)、智能体标识、模型信息、任务类型、执行结果和验证输出等,适用于自然语言处理和人工智能交互研究。
This dataset contains multi-agent conversation and task execution records, with features such as dialogue content (role and messages), agent identifiers, model information, task types, execution results, and verifier outputs, suitable for natural language processing and AI interaction research.
提供机构:
DCAgent3搜集汇总
数据集介绍
构建方式
该数据集源自GAIA基准测试环境,通过强化学习(RL)对SankalpKJ的nemotron-code-oracle模型进行微调,并基于60%的过滤阈值与8B参数规模,筛选出高质量的交互轨迹。构建过程中,模型在复杂推理任务中生成agent行为记录,经verifier验证后,仅保留符合正确性与可靠性的样本,最终形成847条训练实例。
特点
数据集以对话形式(conversations)存储多轮交互,记录角色(role)与内容(content),同时附带agent模型、模型提供商(model_provider)及日期(date)等元信息。每项数据均包含任务描述(task)、运行标识(run_id)与验证输出(verifier_output),确保轨迹的完整可追溯性。结构紧凑,适用于训练和评估基于agent的推理系统。
使用方法
用户可通过HuggingFace Datasets库加载该数据集,指定split为'train'即可获取847条训练样本。每条数据包含的多轮对话可用于序列建模,而agent与task字段可用于上下文条件生成。推荐将其作为RL微调或偏好对齐任务的训练源,同时可结合verifier_output进行质量筛选与对比分析。
背景与挑战
背景概述
该数据集名为gaia_127_a3_rl_SankalpKJ_nemotron_code_oracle_filtered_60_8B_20260526_201849-traces,创建于2026年,由研究机构或研究者SankalpKJ主导,主要围绕强化学习与代码生成领域的交互轨迹构建。核心研究问题聚焦于利用多轮对话数据,结合代码oracle验证与模型过滤机制,提升大语言模型在复杂任务中的推理与执行能力。作为GAIA系列数据集的衍生版本,它通过筛选8B参数级模型的强化学习轨迹,为代码生成与智能体研究提供了精细化的训练样本,对推动代码智能体的自我改进与长链推理研究具有重要参考价值。
当前挑战
该数据集面临的挑战包括:在领域问题上,需解决多轮代码任务中智能体决策轨迹的稀疏性与噪声问题,确保从强化学习反馈中提取有效策略;构建过程中,需应对大规模轨迹数据清洗与过滤的困难,例如通过oracle验证剔除无效或错误生成,并平衡模型容量与数据多样性,同时处理不同任务(如编程、问答)间的范式差异,以避免过拟合单一任务模式,保持数据集对通用代码智能体训练的适应性。
常用场景
经典使用场景
GAIA_127_A3_RL数据集专为强化学习与代码生成领域的协同研究而设计,其核心应用在于训练和评估具备自主编程能力的智能体。该数据集收录了来自特定训练流程(如Nemotron模型)的847条交互轨迹,每条轨迹均详细记录了智能体在代码生成任务中的对话历史、执行结果及验证器输出。研究者可借助这些结构化数据,探索强化学习策略如何优化代码生成的准确性与鲁棒性,尤其适用于多轮交互场景下的智能体行为建模。
解决学术问题
在学术研究中,该数据集破解了如何系统性评估强化学习对代码生成任务影响的难题。传统方法通常依赖静态基准,难以捕捉智能体在动态环境中的学习过程。GAIA_127_A3_RL通过提供包含完整状态-动作-奖励链的轨迹数据,使学术工作能够深入分析策略梯度、奖励塑造等机制对代码质量的影响。这为理解强化学习在编程智能体中的泛化边界提供了关键实证,推动了从单次生成到迭代优化范式的理论跃迁。
衍生相关工作
围绕此数据集,衍生出多项前沿研究。一方面,它催生了针对强化学习代码生成算法的基准测试框架,如借鉴其多轮交互结构设计新的验证指标;另一方面,该数据集的验证器输出字段被用于训练更高效的代码质量评估模型,形成“生成-验证”的闭环增强系统。此外,其轨迹数据还启发了基于离线强化学习的策略预训练方法,显著降低了在线采样成本,推动了代码智能体从实验室研究向工业化部署的跨越。
以上内容由遇见数据集搜集并总结生成


