
leafspark/tracktext
收藏官方服务:
资源简介:
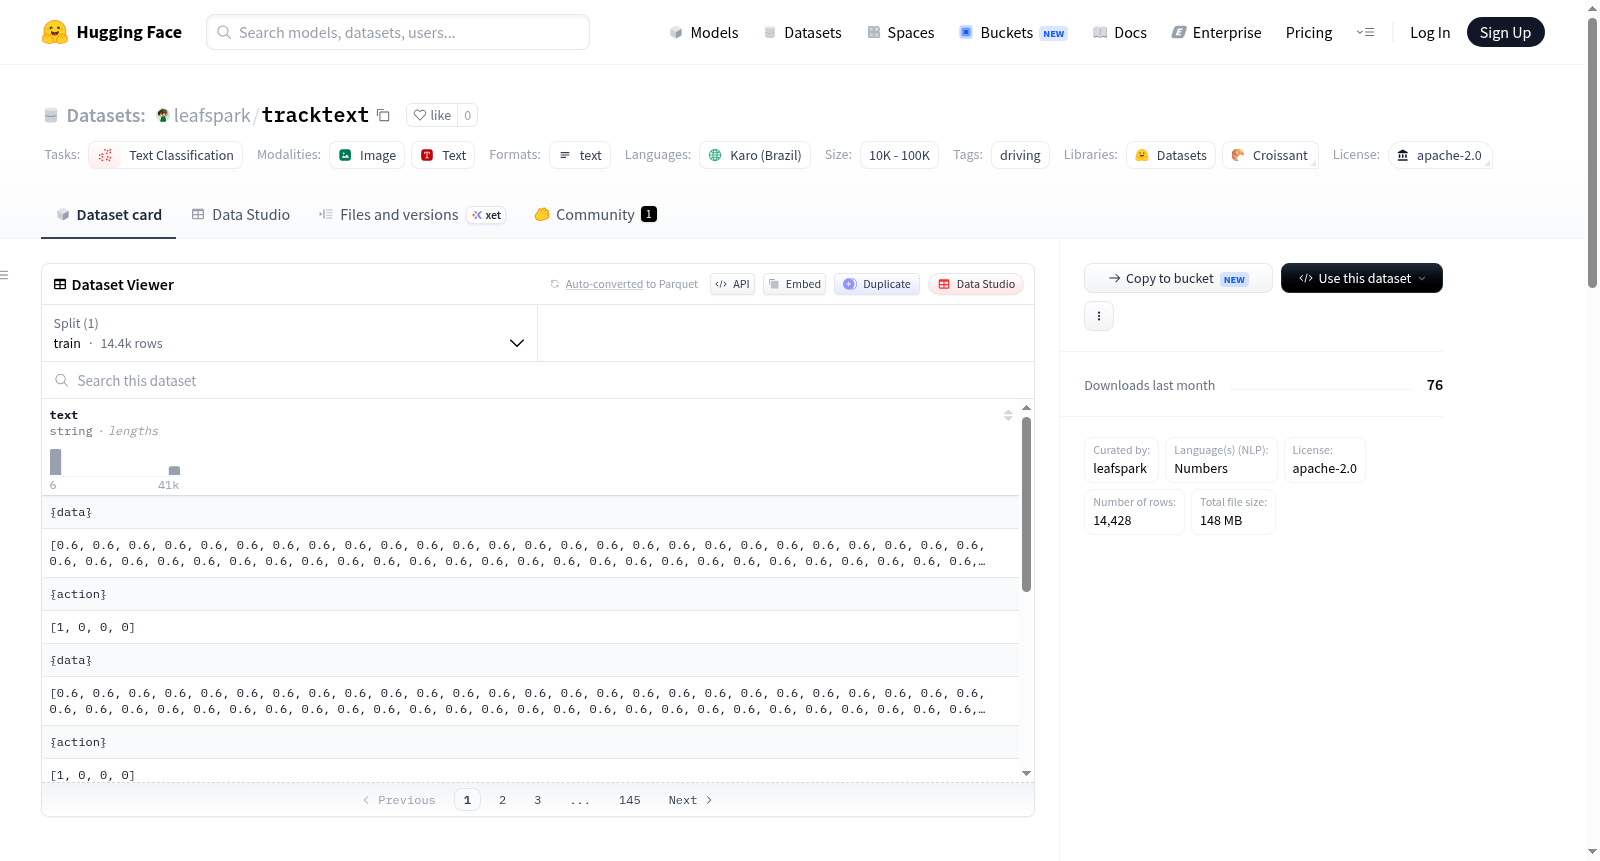
tracktext是一个实验性数据集,包含TrackMania游戏的128x64灰度图像和按键操作,专为具有16k上下文或以上的LLM设计。数据集格式为文本文件,包含灰度图像数据和按键操作数据。灰度精度为1位小数,捕获速率为每秒6帧。数据集由leafspark策划,使用Apache-2.0许可证,主要用于训练LLM如何玩TrackMania游戏。数据集创建通过Python脚本完成,源数据来自TrackMania 2020的屏幕截图。数据集中不包含个人和敏感信息,但存在分辨率不高可能导致结果不理想的风险。
tracktext是一个实验性数据集,包含TrackMania游戏的128x64灰度图像和按键操作,专为具有16k上下文或以上的LLM设计。数据集格式为文本文件,包含灰度图像数据和按键操作数据。灰度精度为1位小数,捕获速率为每秒6帧。数据集由leafspark策划,使用Apache-2.0许可证,主要用于训练LLM如何玩TrackMania游戏。数据集创建通过Python脚本完成,源数据来自TrackMania 2020的屏幕截图。数据集中不包含个人和敏感信息,但存在分辨率不高可能导致结果不理想的风险。
提供机构:
leafspark原始信息汇总
数据集概述
基本信息
- 名称: tracktext
- 许可证: apache-2.0
- 语言: Numbers
- 大小: 1M<n<10M
- 标签: driving
- 任务类别: text-classification
数据集描述
-
格式: 包含灰度图像和按键数据,格式如下:
{data} [0.0, 0.0, 0.0, 0.0], [0.0, 0.0, 0.0, 0.0], ... {action} [0, 0, 0, 0]
-
灰度精度: 1位小数
-
捕获率: 6帧每秒
-
创建者: leafspark
-
源数据: TrackMania 2020屏幕截图
数据集用途
- 直接用途: 训练LLM玩TrackMania
- 不适用的用途: 常规LLM
数据集结构
- 结构: 文本文件
数据集创建
- 创建工具: Python脚本
- 筛选理由: 使用LLM进行自动驾驶,出于娱乐目的
偏差、风险和限制
- 限制: 分辨率不高,可能导致结果不理想
- 建议: 不期望有好的结果
搜集汇总
数据集介绍
构建方式
在自动驾驶与游戏人工智能交叉研究的前沿领域,leafspark/tracktext数据集应运而生,旨在探索大语言模型在复杂动态环境中的决策能力。该数据集的构建基于对竞速游戏《TrackMania 2020》的屏幕画面进行实时捕获,以每秒6帧的频率采集128x64像素的灰度图像,并同步记录对应的键盘操作序列。每个样本以文本格式呈现,数据部分包含精确到一位小数的灰度矩阵,动作部分则为四维按键向量,整体结构设计适配具有16k及以上上下文窗口的大语言模型。这种将视觉状态与离散动作映射为序列化文本的方式,为模型学习驾驶策略提供了结构化训练材料。
特点
该数据集的核心特色在于其创新的多模态文本化表征策略,将连续视觉信息与离散操控指令统一编码为可被语言模型直接处理的数值序列。灰度图像被转化为高精度浮点矩阵,保留了原始画面的关键视觉特征,而按键记录则构成简洁的动作标签空间。数据规模介于100万至1000万样本之间,在保证训练充分性的同时兼顾了计算资源效率。特别值得注意的是,其设计灵感源自DOOM-Mistral-7b项目,体现了将经典游戏环境作为语言模型训练场的前沿思路,为自动驾驶研究提供了低门槛、高可控的仿真验证平台。
使用方法
研究人员可通过HuggingFace平台直接加载该数据集,将其作为训练专用型大语言模型的输入数据。典型使用流程包括:首先解析文本文件中的灰度矩阵与动作向量,随后利用语言模型的自回归特性学习状态到动作的映射关系。建议采用具有16k以上上下文窗口的模型架构,以充分捕捉连续帧之间的时序依赖。该数据集特别适合用于验证语言模型在序列决策任务上的泛化能力,但需注意其128x64的低分辨率可能限制在真实自动驾驶场景中的直接迁移效果,更适合作为概念验证与算法探索的基准测试集。
背景与挑战
背景概述
在自动驾驶与游戏人工智能的交叉领域,利用语言模型直接操控虚拟环境正成为前沿探索方向。leafspark/tracktext数据集由研究人员leafspark于近期创建,灵感源自DOOM-Mistral-7b项目,旨在训练具备16k以上上下文窗口的大型语言模型学习《赛道狂飙》(TrackMania 2020)的驾驶行为。该数据集以每秒6帧的速率采集128x64像素的灰度游戏截图,并同步记录键盘操作,以文本序列形式呈现,开创性地将视觉驾驶任务转化为语言建模问题。其核心研究问题在于验证语言模型能否通过结构化文本输入直接习得连续控制策略,为端到端自动驾驶的符号化表征提供了新思路。尽管尚处实验阶段,该数据集已引发对多模态语言模型在动态环境决策中潜力的讨论。
当前挑战
该数据集面临的核心挑战首先在于领域问题层面:将高维连续控制任务简化为离散文本序列,导致空间和时间分辨率严重不足——128x64的灰度图像丢失了大量纹理和色彩细节,6帧的采样率难以捕捉高速驾驶中的瞬时决策,这限制了模型对复杂路况的泛化能力。构建过程中,数据采集仅依赖单一游戏场景和固定脚本,缺乏光照、天气或赛道结构的多样性,可能引入严重过拟合风险。此外,文本化表征将像素值保留至一位小数,虽利于语言模型处理,却牺牲了视觉信息的连续性,如何平衡符号抽象与感知保真度成为关键瓶颈。最终,模型输出的离散按键序列与真实物理引擎的连续控制需求之间存在根本性鸿沟。
常用场景
经典使用场景
在自动驾驶与游戏智能体的交叉研究领域,tracktext数据集以其独特的128×64灰度图像与按键动作序列配对形式,开创性地将驾驶博弈的视觉感知与决策控制任务转化为文本分类问题。该数据集以每帧6次的频率捕获TrackMania 2020游戏画面,并将连续驾驶行为编码为四维动作向量,为探索大语言模型在实时控制场景中的泛化能力提供了标准化训练基准。研究者可借助该数据集训练具备16k以上上下文窗口的专用语言模型,使其在理解驾驶环境动态变化的同时,学习从视觉特征到操控指令的端到端映射关系,从而验证语言模型超越传统自然语言处理边界、向具身智能领域延伸的可行性。
实际应用
在实际应用层面,tracktext数据集主要服务于自主驾驶仿真系统的轻量化开发需求。基于该数据集训练的语言模型可直接部署于TrackMania游戏环境,实现基于自然语言处理框架的实时路径规划与转向控制,降低传统自动驾驶系统对高精度传感器和复杂感知模块的依赖。此外,该数据集所验证的视觉-动作编码方案可迁移至其他赛车游戏或简易模拟驾驶平台,为低成本游戏AI开发、自动驾驶算法教学演示以及人机交互原型设计提供可复现的技术路径,尤其适用于资源受限场景下快速验证语言模型控制能力的原型系统构建。
衍生相关工作
tracktext数据集直接承袭了DOOM-Mistral-7b项目将语言模型应用于第一人称射击游戏控制的研究思路,但其创新之处在于将应用场景从射击对抗迁移至赛车驾驶,并设计了更适配连续控制任务的数据编码格式。该数据集的出现促进了针对语言模型时序动作预测能力的专项研究,衍生出诸如基于注意力机制的驾驶状态压缩编码方法、面向低分辨率视觉输入的文本表示优化策略,以及结合强化学习微调的语言模型驾驶策略等后续工作。这些研究共同构建了从经典游戏AI向通用具身智能语言模型过渡的技术脉络,为最终实现语言模型在真实物理世界中的自主导航控制积累了关键经验。
以上内容由遇见数据集搜集并总结生成


