
luisrui/ModelLens-corpus-v2
收藏官方服务:
资源简介:
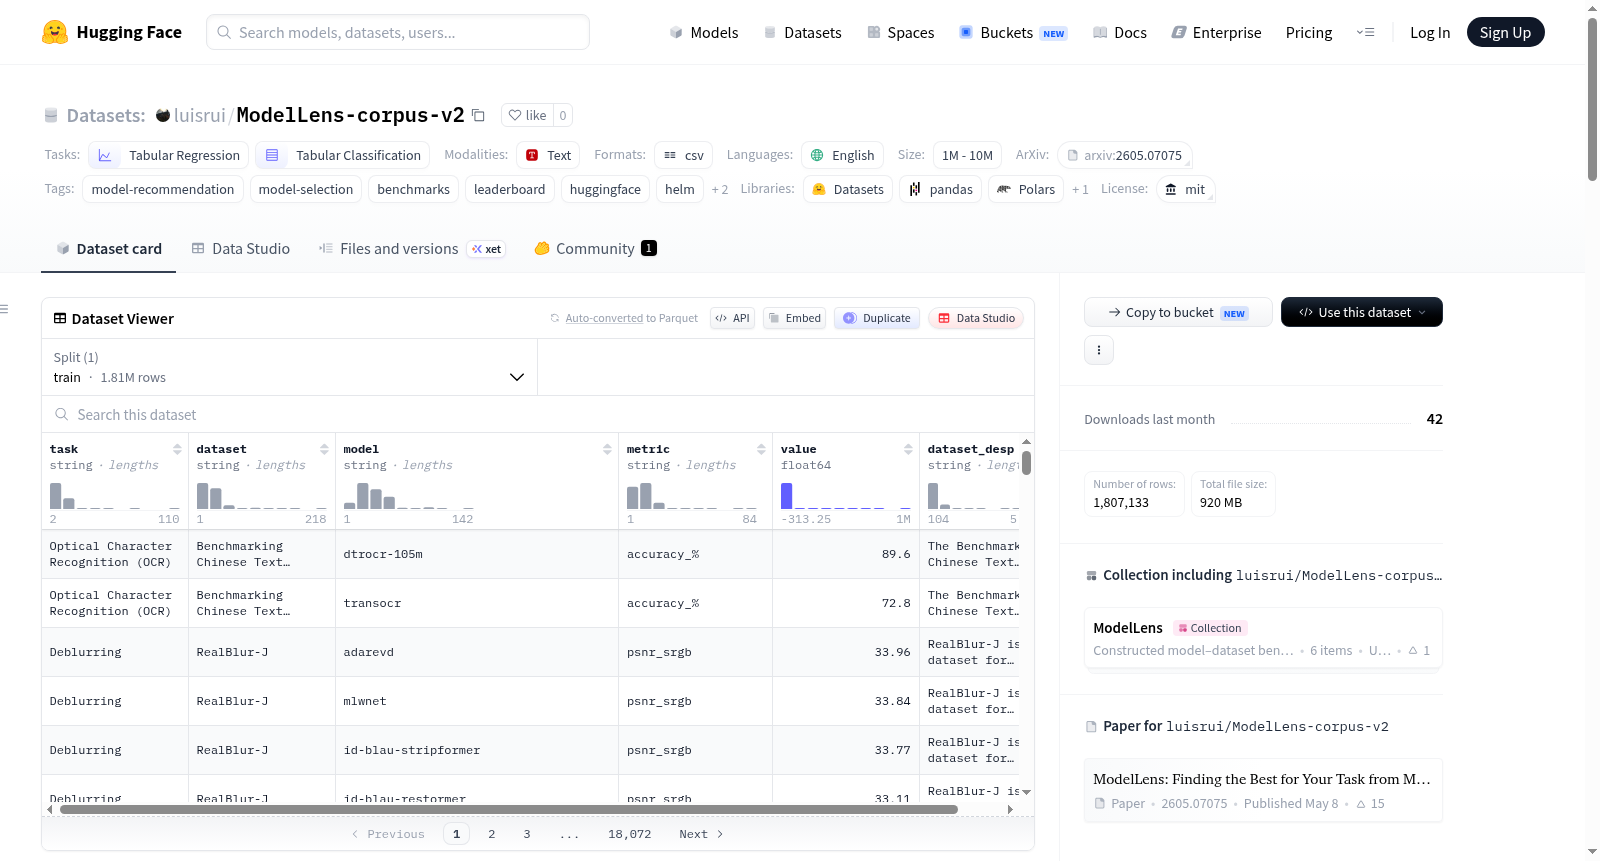
ModelLens Corpus v2 是一个扩展的数据集,包含 1,807,133 条(任务、数据集、模型、指标、值)记录,覆盖 47,242 个 HuggingFace 模型、10,479 个数据集、9,152 个指标和 2,581 个任务。该版本通过整合三个额外的排行榜数据源扩展了 v1 版本:HELM(Stanford CRFM)— 294,315 行、LiveBench — 6,136 行和 OpenCompass — 581 行。数据集用于模型推荐和选择,支持表格回归和分类任务,并提供详细的文件结构和清理注意事项。
ModelLens Corpus v2 is an expanded corpus of 1,807,133 (task, dataset, model, metric, value) records covering 47,242 HuggingFace models, 10,479 datasets, 9,152 metrics, and 2,581 tasks. v2 extends v1 by folding in three additional leaderboard sources: HELM (Stanford CRFM) — 294,315 rows, LiveBench — 6,136 rows, and OpenCompass — 581 rows.
提供机构:
luisrui搜集汇总
数据集介绍
构建方式
ModelLens-corpus-v2是在第一版基础上扩展构建的大规模模型性能语料库。研究团队在原有1,542,867条记录的基础上,整合了斯坦福CRFM的HELM基准、LiveBench和OpenCompass三大权威排行榜数据,分别贡献了294,315条、6,136条和581条新记录。经过跨源去重处理(采用中位数选取解决冲突组、保留较小值的百倍缩放误差校正以及精确重复行折叠),最终形成包含1,807,133条观测记录的清洁语料。每条记录按(任务、数据集、模型、指标、数值、数据集描述)六元组结构组织,覆盖47,242个HuggingFace模型、10,479个数据集、9,152个评估指标和2,581个任务类型。
特点
该数据集兼具广度与深度,在规模上较第一版扩充了约17%,纳入了多个主流排行榜的异构数据源。值得注意的是,所有47,242个模型均补充了模型族和参数量信息(族覆盖率达89.6%,参数量覆盖率达45.4%),其中约94%的新增模型名称已无法解析为活跃的HuggingFace仓库,研究团队通过基于名称令牌的正则表达式(如识别bert、swin等关键词)完成了模型族和参数规模的逆向恢复。每条模型档案记录均携带来源溯源字段(family_source、size_source及reason),允许下游代码根据数据来源的可靠性进行过滤。此外,数据集的指标列已去除任务类型前缀,使得同一指标名在不同任务间可被区分使用。
使用方法
用户可通过HuggingFace Datasets库一键加载:`load_dataset('luisrui/ModelLens-corpus-v2', split='train')`。对于偏好传统数据分析流程的研究者,也可通过`huggingface_hub`下载原始CSV文件(约880MB)后使用Pandas读取。辅助资源包括任务词汇表(task2id.json)、简化指标词汇表(metric2id.json)、模型族映射(family2id.json)及模型名称与整数ID的对照表(model2id.json)等。数据集采用MIT许可证发布,但需要注意的是,原始排行榜数据各自保留其原始许可证条款。如果使用者需要更为严格的清洁版本,可以复用第一版的完整清洗流程(R1至R6规则),或在当前数据集上重新运行清洁脚本。
背景与挑战
背景概述
ModelLens-corpus-v2 是由 Rui Cai、Weijie Jacky Mo 等研究者于 2026 年创建的综合性模型表现数据集,旨在解决多源基准评测中模型选择与推荐的核心问题。该数据集扩展自 v1,整合了来自 HuggingFace、HELM(Stanford CRFM)、LiveBench 和 OpenCompass 的 1,807,133 条记录,覆盖 47,242 个模型、10,479 个数据集、9,152 个指标及 2,581 个任务。凭借其大规模异构数据融合特性,ModelLens-corpus-v2 为自动化模型推荐系统提供了坚实的数据基础,显著推动了机器学习模型评估与选择领域的发展。
当前挑战
ModelLens-corpus-v2 所解决的领域挑战在于跨来源基准评测的异构性与可比较性不足,传统模型选择依赖单一榜单或人工经验,缺乏系统性的跨任务、跨指标推荐机制。构建过程中面临多重挑战:首先是数据清洗与去重,需处理来自四个独立源的 1.84M 条原始记录,通过六轮规则(R6)消除冲突(如尺度错误与重复项);其次,约 94% 的新增模型名称已无法解析为活跃的 HuggingFace 仓库,需依赖正则表达式推断模型族与参数量;此外,异构指标命名(如任务前缀剥离后同名指标歧义)与不同来源的评分尺度差异(如 0–1000 与 0–1 归一化)进一步增加了数据整合的复杂性。
常用场景
经典使用场景
ModelLens-corpus-v2作为横跨海量模型、数据集与评估指标的综合性语料库,最经典的使用场景在于构建模型推荐系统。研究人员和从业者可通过该语料库中蕴含的庞大性能记录,精准匹配特定任务下的最优模型。它如同一座桥梁,连接了上游的预训练模型库与下游的实际应用需求,使得非专家用户也能高效地从数以万计的候选模型中遴选出最契合的解决方案。这一过程极大地降低了模型选择的试错成本,并加速了模型部署的决策流程。
实际应用
在实际工业应用中,ModelLens-corpus-v2直接服务于自动化机器学习管道与模型运维平台。例如,企业级的AI开发平台可基于该语料库构建自动化的模型推荐引擎,为不同业务场景(如文本分类、图像识别、代码生成)提前过滤掉不合适的模型,并推荐性能优异且资源消耗合理的候选。此外,该数据集还为云服务提供商优化模型部署策略提供了数据支撑,使其能够根据模型的历史表现动态调配计算资源,以实现成本与效率的最佳平衡。
衍生相关工作
ModelLens-corpus-v2的发布催生了一系列重要的衍生研究。最直接的成果是同步发布的MLPMetricFull.pt模型检查点,这一基于神经网络的推荐器直接利用该语料库进行训练,实现了对未见任务性能的精准预测。此外,该数据集为模型性能预测、元学习、多任务学习以及模型卡自动生成等领域提供了坚实的数据基础,激发了许多围绕模型选择推理与性能溯源的工作,例如基于模型家族与参数规模的性能回归分析,以及对评测偏差的系统性剖析。
以上内容由遇见数据集搜集并总结生成


