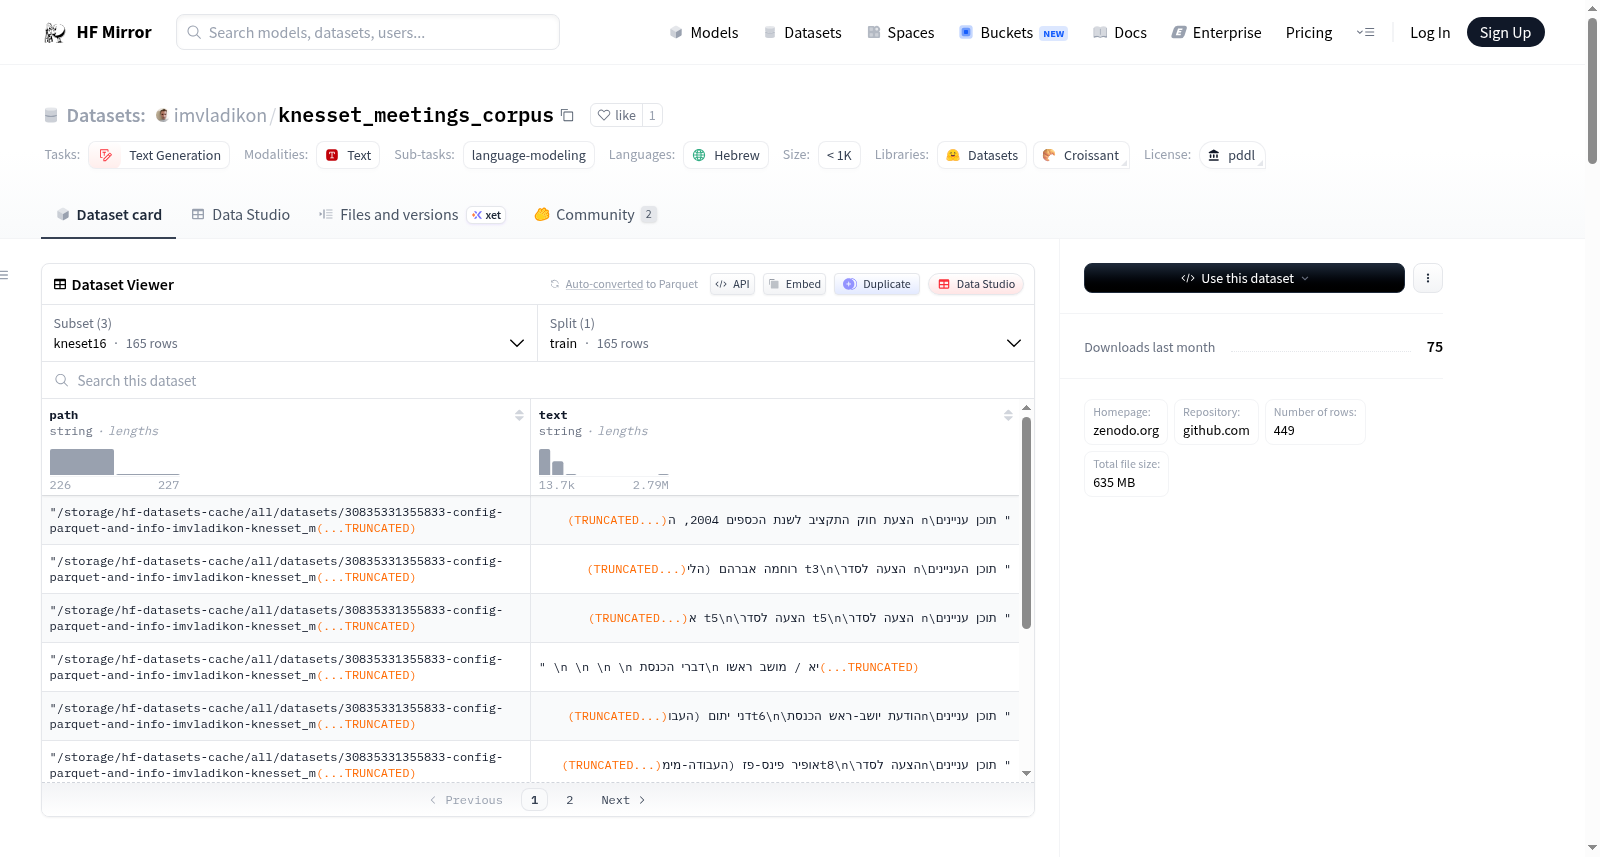
imvladikon/knesset_meetings_corpus
收藏资源简介:
Knesset Meetings Corpus 2004-2005 数据集由两个主要部分组成:原始文本和经过分词及形态标注的文本。原始文本以两种格式(doc 和 txt)提供,并分为两个集合(kneset16 和 kneset17)。标注文本仅适用于 kneset16 集合。该数据集是单语言的,使用希伯来语,数据来源于原始数据。它适用于文本生成任务,特别是语言建模。该数据集属于公共领域,不需要任何许可证。
The Knesset Meetings Corpus 2004-2005 dataset comprises two core components: raw text and tokenized, morphologically annotated text. The raw text is provided in two formats (doc and txt) and split into two collections: kneset16 and kneset17. The annotated text is only available for the kneset16 collection. This is a monolingual Hebrew dataset, with data sourced from original sources. It is suitable for text generation tasks, particularly language modeling. This dataset is in the public domain and requires no license.
数据集概述
数据集名称: Knesset Meetings Corpus
语言: 希伯来语 (he)
许可证: PDDL (Open Data Commons Public Domain Dedication & License 1.0)
多语言性: 单语种
大小类别: 小于1千条记录
源数据集: 原始数据
任务类别: 文本生成
任务ID: 语言建模
数据集结构
数据实例:
- 包含282个文件,总计867,725行。
- 分为两种格式:
doc和txt。doc格式:使用windows-1255编码。kneset16.zip:包含164个文件,总计543,228行。kneset17.zip:包含118个文件,总计324,497行。
txt格式:使用utf8编码。kneset.tar.gz:包含所有原始文本文件,分为两个文件夹。16:包含164个文件,总计543,228行。17:包含118个文件,总计324,497行。
knesset_txt_16.tar.gz和knesset_txt_17.zip:分别包含164和118个文件,总计543,228和324,497行。
标记化和形态学标记文本:
- 仅存在于
16文件夹中。 - 使用MILA的XML架构编码。
- 可通过
knesset_tagged_16.tar.gz下载。
数据集创建
语言创建者: 众包
注释: 无注释
个人和敏感信息: 未提及具体信息
使用数据集的考虑
许可证信息: 数据集根据Open Data Commons Public Domain Dedication & License 1.0提供。
其他信息:
- 数据集的详细信息和下载链接可在其GitHub仓库和Zenodo页面找到。
- 数据集的原始文本和标记化文本均可下载,适用于不同的研究和开发需求。