
遇见数据集

tudor-iustin22/myriad-1s

收藏
Hugging Face2026-05-29 更新2026-05-31 收录
官方服务:

资源简介:

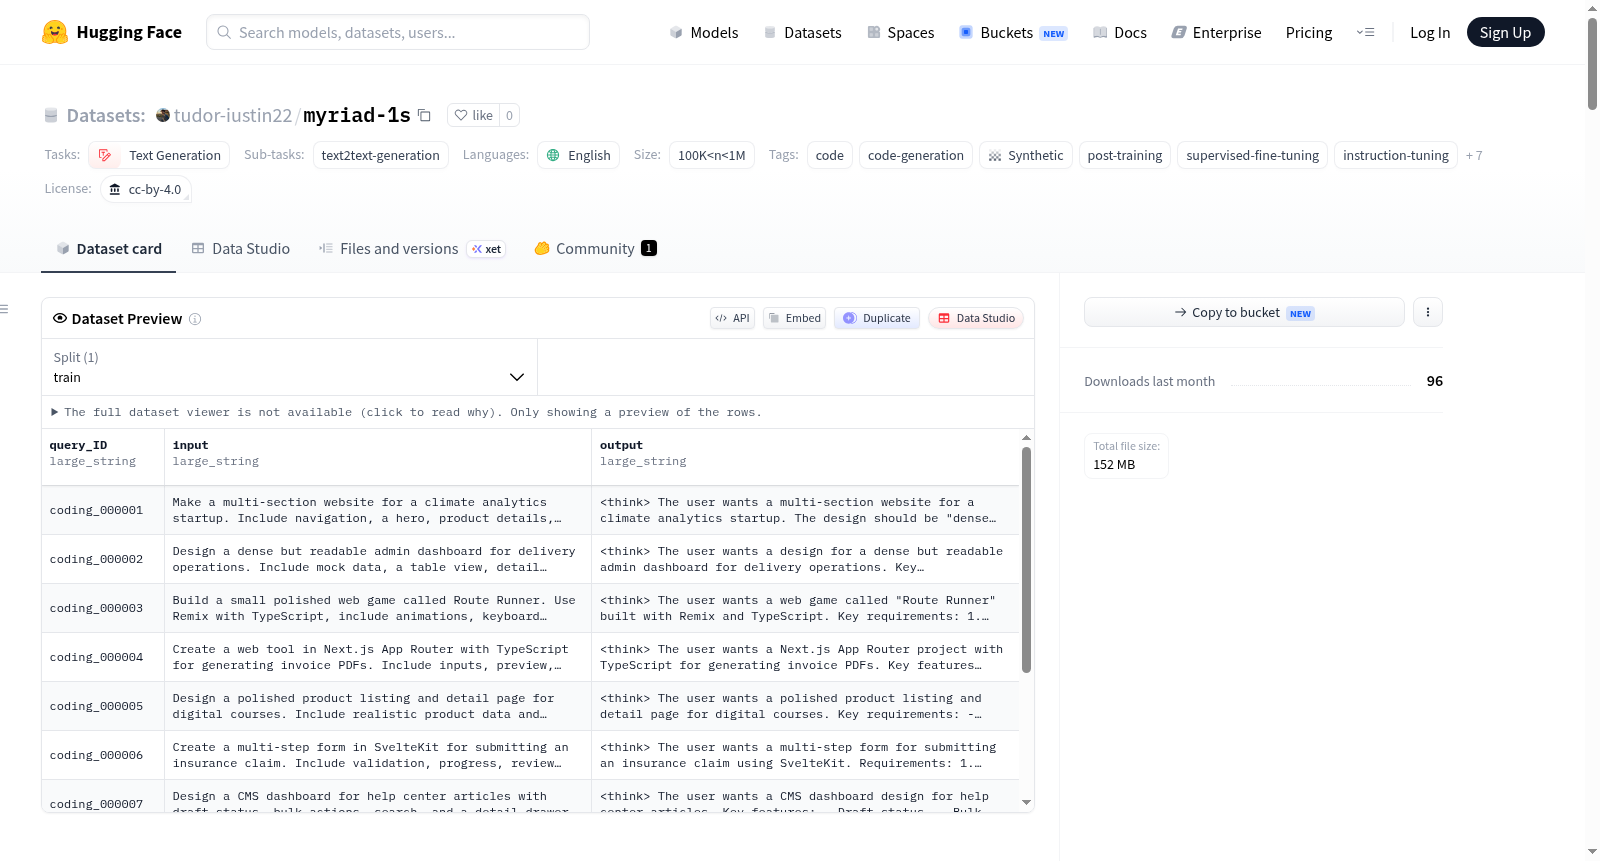
MYRIAD-1S是一个开源的全栈代码数据集,由Tudor Iustin发布。它旨在支持代码生成、Web开发、监督微调、指令调优、数据集研究和评估工作流,适用于具备代码能力的AI系统。该数据集包含16,000个全栈代码样本,总计约102M个令牌,专注于现实软件构建任务,包括Web应用程序、产品界面、仪表板、浏览器游戏、开发工具和响应式全栈体验。数据集以Parquet格式发布,包含三列:query_ID(唯一标识符)、input(用户指令或任务提示)和output(生成的响应,包括实现、解释和代码内容)。它强调完整的实现模式,而非短代码片段,覆盖现代前端和Web应用框架(如Next.js、React、TypeScript、Tailwind CSS等),并注重高质量UI/UX、边缘案例和验证行为。数据集使用Creative Commons Attribution 4.0 International许可证,要求在使用时进行署名。

MYRIAD-1S is an open source full-stack code dataset released by Tudor Iustin. It is designed to support code generation, web development, supervised fine-tuning, instruction tuning, dataset research, and evaluation workflows for code-capable AI systems. The dataset contains 16,000 full-stack code samples totaling approximately 102M tokens. It focuses on realistic software-building tasks, including web applications, product interfaces, dashboards, browser games, developer tools, and responsive full-stack experiences. The dataset is released in Parquet format with three columns: query_ID (unique sample identifier), input (user-facing coding instruction or task prompt), and output (generated response containing the implementation, explanation, and code content). It emphasizes complete implementation patterns rather than short code snippets, covering modern frontend and web application frameworks (e.g., Next.js, React, TypeScript, Tailwind CSS), and prioritizes high-quality UI/UX, practical edge cases, and validation behavior. The dataset is licensed under Creative Commons Attribution 4.0 International, requiring attribution when used.

提供机构:
tudor-iustin22
搜集汇总
数据集介绍
tudor-iustin22/myriad-1s 数据集图片
构建方式
在软件工程与全栈开发领域,高质量指令数据的稀缺性始终制约着代码生成模型的能力提升。MYRIAD-1S正是为弥合这一鸿沟而诞生的全栈代码数据集,由Tudor Iustin独立开发并发布。该数据集采用DeepSeek V4 Flash模型,在NVIDIA DGX Spark双节点集群(配备CX-7 200GbE GPU RDMA高速互连)上合成生成,共计16,000个样本,涵盖约1.02亿词元。构建过程以真实开发任务为导向,针对Next.js、React、TypeScript、Tailwind CSS等现代框架生成包含详细任务描述与完整实现代码的指令-响应对,确保每条样本均具备充分的工程深度与实用性。
特点
MYRIAD-1S的核心特色在于其对全栈开发场景的全面覆盖与高保真度。数据集不仅包含典型的网页应用与产品界面,还拓展至仪表盘、管理面板、浏览器游戏及开发者工具等多类型任务,强调完整实现模式而非零散代码片段。每条样本均细致处理加载态、空态、验证、错误与边界情况等生产级场景,融入可复用组件设计、模拟API、服务端操作及响应式布局等要素。这种对UI/UX质量、可访问性与边缘案例的系统性关注,使数据集成为训练具备工程思维代码助手的理想资源。
使用方法
研究人员可通过Hugging Face Datasets库便捷加载该数据集,使用`load_dataset("tudor-iustin22/myriad-1s")`即可获取默认训练分片。数据以Parquet格式存储,包含query_ID、input、output三列字符串字段,分别对应唯一标识、编程指令与完整代码响应。用户可基于自身需求进行下游过滤与格式转换,尤其建议在用于指令微调或对话式微调前检查并调整响应格式。数据集采用CC BY 4.0许可协议,允许商业使用与改编,但必须标注Tudor Iustin为数据集创作者。
背景与挑战
背景概述
随着大型语言模型在代码生成领域的迅猛发展,构建能够处理复杂、多层级软件工程任务的数据集成为关键瓶颈。MYRIAD-1S数据集由Tudor Iustin于2026年5月发布,旨在填补全栈代码生成领域高质量合成数据的空白。该数据集包含16,000个指令-响应对,总计约1.02亿个令牌,覆盖Next.js、React、TypeScript等现代框架,专注于完整的应用程序实现而非代码片段。其通过DeepSeek V4 Flash模型在NVIDIA DGX Spark集群上生成,强调真实开发任务、边缘情况处理与生产导向的UI设计。作为独立开源资源,MYRIAD-1S为指令微调、监督微调及代码生成评估提供了重要基准,推动了全栈开发能力在AI系统中的实用化进程。
当前挑战
MYRIAD-1S所应对的核心领域挑战在于,现有代码数据集多偏重短小代码片段或单一任务,难以支撑模型对完整全栈应用的理解与生成能力。该数据集通过构建包含路由、状态管理、响应式设计及错误处理的综合性样本,迫使模型掌握多模块协同的工程化思维。在构建过程中,合成数据生成面临真实性保真度不足的风险,需精细调控指令复杂度以避免模型过拟合至模板化输出;同时,确保16,000个样本覆盖广泛的边缘案例与生产场景,对数据筛选与质量控制提出了极高要求。此外,来自DeepSeek V4 Flash生成的响应需经严格去重与空缺过滤,以维持数据纯净性,而后续用户还需根据部署环境进行额外的安全与合规性审查。
常用场景
经典使用场景
在代码智能与全栈开发研究的交汇处,MYRIAD-1S数据集为语言模型的能力培养提供了珍贵的养料。其最经典的使用场景聚焦于监督微调(Supervised Fine-Tuning)与指令微调(Instruction Tuning),尤其适用于那些致力于提升代码生成能力的自然语言处理模型。研究者常常利用该数据集中的16,000条全栈代码样本,涵盖从React、Next.js到Tailwind CSS等现代框架的真实软件构建任务,对基础模型进行针对性的后训练,使其在理解复杂的编程指令、生成结构完整且风格一致的全栈应用代码方面展现出卓越的泛化能力。该数据集以其对完整实现模式的强调,区别于仅包含简短代码片段的传统语料,成为训练专业级编程助手的理想基石。
实际应用
在现实世界的技术浪潮中,MYRIAD-1S数据集的应用图景广阔而具体。对于致力于构建下一代智能开发助手的企业而言,它可直接用于微调大型语言模型,使其能够依据自然语言描述自动生成企业级仪表盘、交互式产品界面乃至完整的浏览器游戏原型。前端开发者社区可借助该数据集,训练出精通React、Vue或SvelteKit等框架的代码补全插件,显著提升开发效率。同时,在在线教育平台领域,基于此数据集微调的模型能够为学生提供即时、准确且风格统一的编程示例和项目模板,从而降低全栈开发的学习门槛,让复杂的技术构思得以快速转化为可运行的软件产物。
衍生相关工作
自MYRIAD-1S数据集问世以来,它已然成为一系列创新工作的源头活水。在学术界,研究者基于该数据集衍生了多项经典工作,例如针对全栈生成代码的自动化质量评估基准,通过对比模型输出与数据集中的参考实现,量化代码在结构完整性、组件复用度及响应式适配上的表现。此外,有工作利用该数据集的指令-响应对,探索了面向代码的偏好对齐策略(如DPO),训练出更符合开发者直觉的指令遵循模型。更有团队将其作为合成数据生成的种子,通过自蒸馏或数据增强技术,进一步扩充至更广泛的软件开发领域,如移动端应用或微服务架构,形成了一个不断演进的代码数据生态。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

