
SalonbusAI/ultrachat_2k
收藏官方服务:
资源简介:
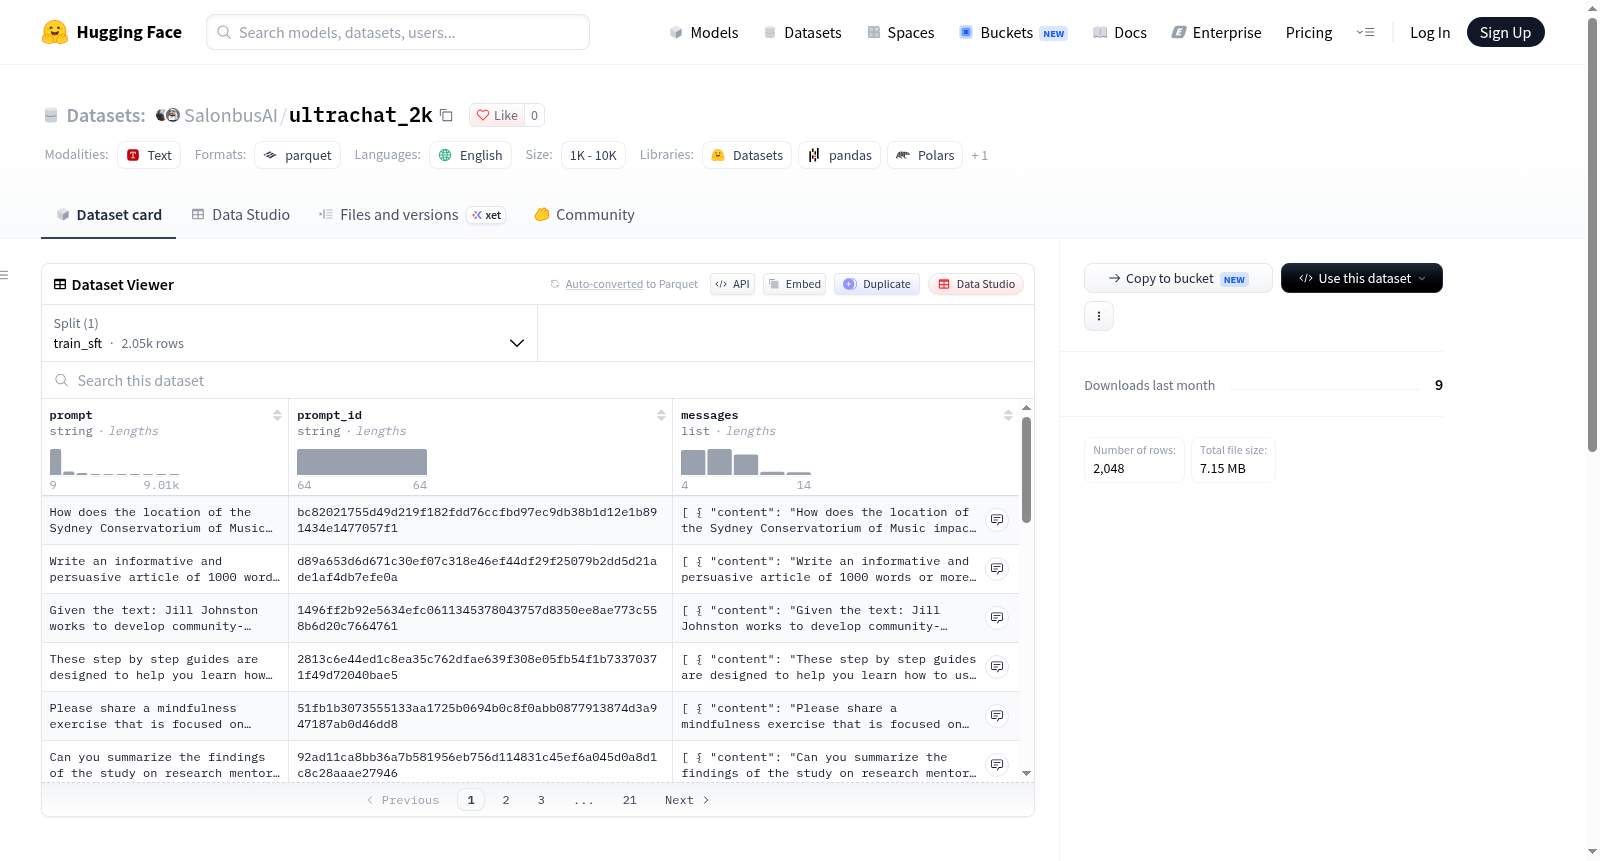
一个来自HuggingFaceH4/ultrachat_200k的2048个样本的小型集合,用于轻松校准。
A small set of 2048 samples from HuggingFaceH4/ultrachat_200k for easy calibration.
提供机构:
SalonbusAI搜集汇总
数据集介绍
构建方式
在指令微调数据规模日益膨胀的背景下,轻量级校准基准的构建成为模型评测实践中一项务实需求。ultrachat_2k的构建采用分层抽样策略,从HuggingFaceH4/ultrachat_200k数据集的train_sft分割中,借助固定随机种子42进行混洗后选取前2048条样本,以此保证抽样过程的可复现性与分布一致性。整个构建流程由公开的Python脚本予以固化,涵盖数据加载、随机采样、本地保存及推送至Hugging Face Hub等环节,使数据集得以透明且可追溯地生成,为后续同类子集数据集的构建提供了可参照的范式。
特点
该数据集的核心特点在于其精巧的规模与结构化字段设计。其仅包含2048条训练样本,总大小约13.6 MB,便于在有限计算资源下快速加载与迭代实验。字段层面涵盖prompt、prompt_id与messages三列,其中messages以列表形式承载多轮对话内容,每轮对话均标注content与role,构成完整的对话历史结构。这种字段安排忠实保留了原始多轮对话的语义层次,使数据可直接用于监督微调训练格式,同时因其来源明确、采样固定,适合充当不同训练配置之间的校准参照,降低评测成本。
使用方法
在使用层面,研究者和开发者可依托Hugging Face datasets库直接加载该数据集,通过load_dataset接口指定数据集标识与train_sft分割即可获取全部样本,无需额外预处理步骤。加载后的数据可直接接入监督微调训练流程,亦可作为小规模验证集用于模型性能的快速诊断与超参数校准。由于其字段与ultrachat_200k保持一致,任何面向原始数据集的训练脚本或评估管线均可无缝迁移至该子集,从而在资源受限场景下实现高效实验,兼顾复现性与实用性。
背景与挑战
背景概述
近年来,大语言模型的对齐训练日益依赖高质量指令微调数据,超大规模对话语料成为推动模型遵循人类意图的关键资源。HuggingFaceH4团队发布的ultrachat_200k凭借其丰富多样的多轮对话内容,在开源社区获得广泛采用。为便于研究者快速进行校准实验与资源受限场景下的模型评测,mgoin于2024年从中随机采样2048条训练样本,构建了轻量级子集ultrachat_2k。该数据集延续了母体在指令遵循与对话生成方面的核心价值,以极低的数据量维持了语义多样性与任务覆盖度,为快速迭代和消融研究提供了高效基准。
当前挑战
从领域问题来看,指令微调数据的核心挑战在于如何在有限样本中保留真实对话场景的复杂性与多样性,避免采样偏差导致模型泛化能力下降。ultrachat_2k虽以轻量化为目标,却需在2048条样本中尽可能覆盖多轮交互、知识问答与开放式生成等任务类型,这对采样策略的均匀性提出了严格要求。在构建过程中,随机打乱与固定种子选择虽保证了可复现性,却难以完全规避原始数据中潜在的领域分布不均与长尾话题缺失问题。此外,子集规模的急剧缩减可能放大标注噪声与低质量对话的影响,进而对校准结果的可靠性构成挑战。
常用场景
经典使用场景
在大规模语言模型的对齐与微调研究中,指令微调数据的规模与质量往往构成一对核心矛盾。ultrachat_2k作为从HuggingFaceH4/ultrachat_200k中经随机采样而得的轻量子集,其经典使用场景在于为研究人员提供低算力开销的快速校准与消融实验平台。具体而言,研究者可借助这一包含2048条多轮对话样本的数据集,在有限的计算预算下执行监督微调流程的原型验证、超参数敏感性分析以及训练稳定性评估,从而在正式投入大规模数据训练之前获得可靠的先导性结论。该数据集所承载的多轮对话结构与角色标注信息,使其尤为适用于对话生成能力与指令遵循能力的初步评测。
实际应用
在工业实践与开发部署环节,ultrachat_2k展现出显著的工程实用价值。模型开发者在正式启动耗时的全量微调任务之前,可依托该数据集完成训练脚本的正确性验证、数据加载管线的端到端测试以及分布式训练配置的调试工作。其较小的存储占用与下载体积,亦使其适于在持续集成与持续交付流程中充当快速回归测试的基准数据。此外,在边缘设备或消费级硬件上进行轻量化对话模型的可行性验证时,该数据集能够以极低的资源代价提供贴近真实分布的微调样本,从而加速从实验原型到产品部署的转化周期。
衍生相关工作
ultrachat_2k虽为衍生子集,却在开源社区中催生了一系列与之相关的研究实践。其母数据集HuggingFaceH4/ultrachat_200k本身即为Zephyr系列模型训练流程的核心组成部分,而ultrachat_2k则常被用作复现Zephyr训练范式的轻量替代方案,见于诸多模型卡片与训练日志之中。围绕该子集,研究者进一步探索了采样偏差对微调效果的影响、小规模数据下的正则化策略以及多轮对话格式的模板敏感性等议题。这些工作共同构成了以轻量子集驱动方法学验证的研究脉络,为后续更大规模对齐数据集的构建与评估提供了方法借鉴。
以上内容由遇见数据集搜集并总结生成


