egyptian-names
收藏资源简介:
该数据集是埃及名字与专名学智能数据集,旨在提供一个全面、多阶段的统计与语言学数据集,用于支撑当代埃及命名传统的生产级专名学引擎。埃及名字遵循连续的父系命名链结构(个人名+父亲名+祖父名+祖先名+家族/部落名)。数据集完整呈现了从超过1587万条原始国家考试记录(约30M+行)到最终规范词典的完整转换管道,包括:阶段0(1587万+原始全名链,含154万+唯一全名字符串)、阶段1(6350万+分割后的父系标记及位置)、阶段2(43,333个唯一原始词频)、阶段3(23,457条拼写与正字法纠正规则)以及阶段4(44,626个带注释的规范名字主词典)。每个规范名字包含14维丰富标注:阿拉伯语规范形式、英语转写、经验性别(男/女/中性)、宗教文化标记(穆斯林/基督教/中性)、专名角色(名/姓/尊称/部落)、标准阿拉伯语元音标注、埃及口语元音标注、标准阿拉伯语IPA转写、埃及口语IPA转写、阿拉伯语词源释义、英语释义、埃及昵称(含元音标注和IPA转写)、三辅音词根、历史词源层次、埃及公众人物示例、代际流行趋势分类、8个世代位置分布百分比(slot1-8)及整体语料占比。数据集提供多个Hugging Face配置(default/final_canonical, phase0_raw, phase1_segmented, phase2_frequencies, phase3_corrections, slot_distributions),适用于文本分类、命名实体识别、特征提取、表格到文本、文本评分、语言学分析等任务。采用MIT许可,可自由用于学术、商业和研究用途。
This dataset is an Egyptian names and onomastics intelligent dataset, designed to provide a comprehensive, multi-stage statistical and linguistic dataset for a production-grade onomastics engine supporting contemporary Egyptian naming traditions. Egyptian names follow a continuous patronymic chain structure (given name + fathers name + grandfathers name + ancestors name + family/tribe name). The dataset presents the complete transformation pipeline from over 15.87 million original national exam records (approximately 30 million+ rows) to the final canonical dictionary, including: Phase 0 (15.87 million+ raw full name chains, with 1.54 million+ unique full name strings), Phase 1 (63.5 million+ segmented patronymic tokens and positions), Phase 2 (43,333 unique raw word frequencies), Phase 3 (23,457 spelling and orthographic correction rules), and Phase 4 (44,626 annotated canonical name master dictionary). Each canonical name includes 14-dimensional rich annotations: Arabic canonical form, English transliteration, empirical gender (male/female/neuter), religious-cultural marker (Muslim/Christian/neutral), onomastic role (given name/surname/honorific/tribe), Standard Arabic vowelization, Egyptian Arabic vowelization, Standard Arabic IPA transcription, Egyptian Arabic IPA transcription, Arabic etymological gloss, English gloss, Egyptian nicknames (with vowelization and IPA transcription), triliteral root, historical etymological stratum, Egyptian public figure examples, generational popularity trend classification, 8 generation slot distribution percentages (slot1-8), and overall corpus proportion. The dataset provides multiple Hugging Face configurations (default/final_canonical, phase0_raw, phase1_segmented, phase2_frequencies, phase3_corrections, slot_distributions), suitable for tasks such as text classification, named entity recognition, feature extraction, table-to-text, text scoring, and linguistic analysis. Licensed under MIT, freely usable for academic, commercial, and research purposes.
Egyptian Names & Onomastic Intelligence Dataset 数据集详情
数据集概览
该数据集是一个关于埃及姓名(人名)的多阶段统计与语言学数据集,旨在构建现代埃及命名传统的专名智能引擎。数据集基于超过1587万条原始国家记录,经过多阶段处理,最终形成包含44,626个规范姓名词条的完整词典。
数据规模与统计
| 指标 | 数量 | 说明 |
|---|---|---|
| 原始考试记录总数 | ~15,875,535 | 覆盖494个数据文件的个人记录 |
| 全名链出现次数 | ~1,588万 | 完整的父系姓名链(如"محمد أحمد علي حسن الشرقاوي") |
| 唯一全名字符串 | 1,545,970+ | 不同的3至5部分姓名组合 |
| 单个名字出现次数 | ~6,350万 | 所有槽位中的单个名字出现次数 |
| 原始独立标记 | 43,333 | 清理前的原始词元 |
| 拼写与错别字修正 | 23,457 | 错拼及未空格复合名的映射 |
| 最终规范主词典 | 44,626 | 完整的埃及唯一姓名清洁词典 |
数据集处理流程
[ 阶段0: 1587万+ 原始全名链(3000万+条记录) ] │ ▼ [ 阶段1: 6350万+ 分段父系标记及位置 ] │ ▼ [ 阶段2: 43,333 唯一原始词元频率 ] │ ▼ [ 阶段3: 23,457+ 正字法与拼写修正 ] │ ▼ [ 阶段4: 44,626 主标注规范姓名 ] (性别 + 宗教 + 世代槽位概率 + 音标 + 含义 + 转写)
数据配置与访问
数据集提供以下配置,可通过Hugging Face datasets库加载:
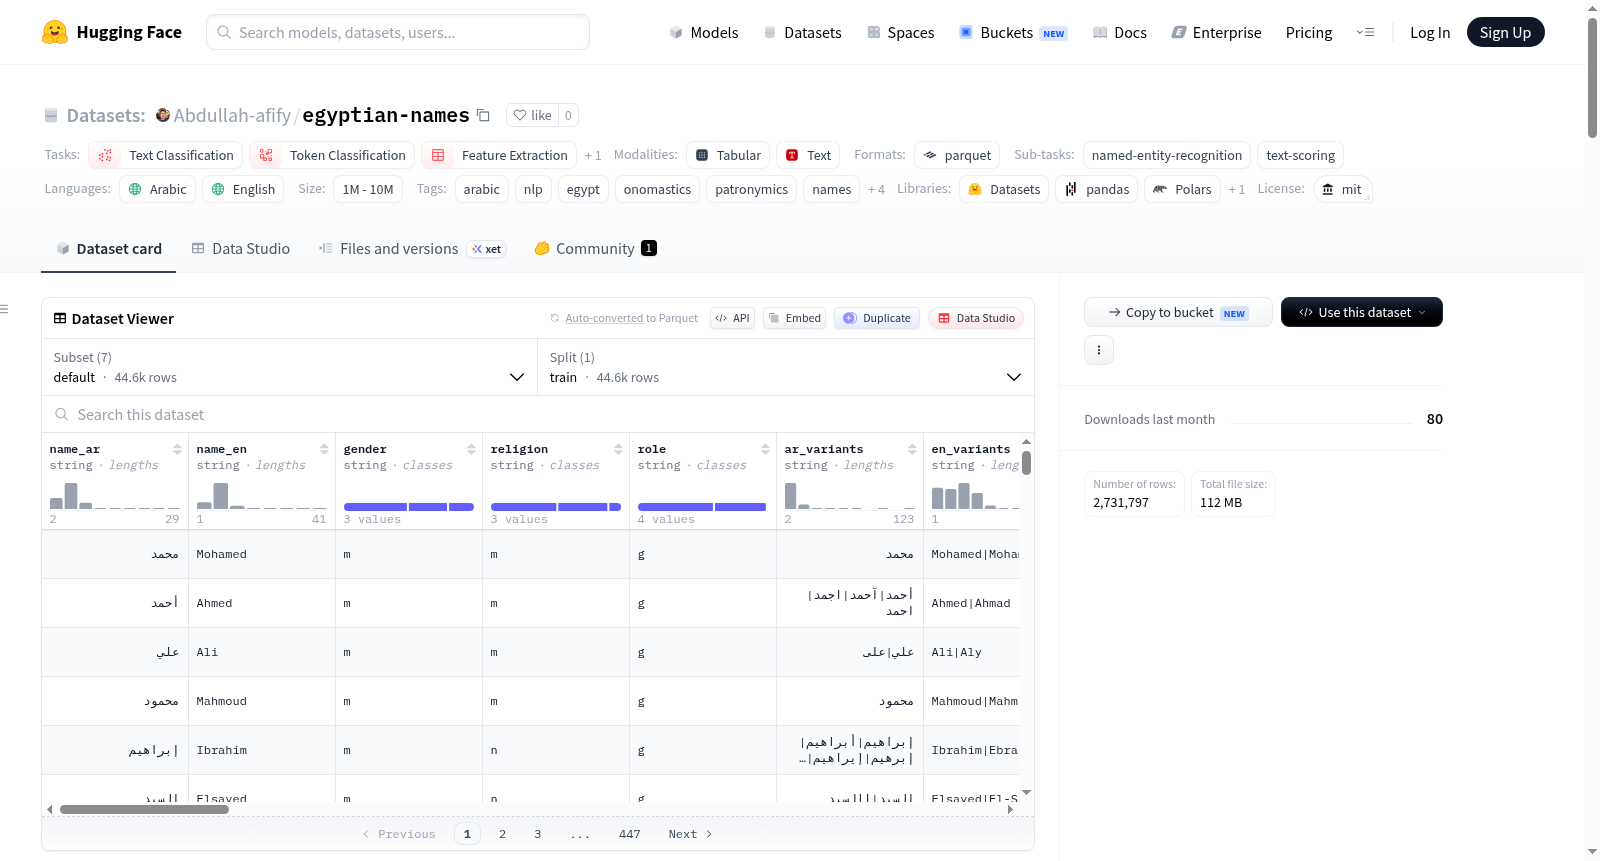
final_canonical(默认):包含44,626条注释规范姓名,每条记录包含14个维度字段,涵盖阿拉伯语/英语名称、性别、宗教、角色、标准/埃及方言音标(Tashkeel)、IPA音标、含义、埃及昵称、词根、来源类型、著名人物、趋势类别及世代槽位分布百分比等。phase0_raw:包含约154万条未处理的原始全名样本(完整语料库为1587万条)。phase1_segmented:分段父系链,可按词元检查系谱位置。phase2_frequencies:唯一词元频率分析,可查看全国语料库中的高频姓名。phase3_corrections:23,457条拼写与错别字修正规则,将错误拼写映射到规范形式。
主要字段说明
以final_canonical配置为例,核心字段包括:
name_ar/name_en:阿拉伯语规范形式与英语转写gender:经验性别标记(男性/女性/中性)religion:文化/宗教标记(穆斯林/基督徒/中性)role:专名角色(名字/家族名/称号/部落名)tashkeel_standard/tashkeel_eg:标准阿拉伯语与埃及方言的音标ipa_standard/ipa_eg:标准与埃及方言的IPA音标meaning_ar/meaning_en:阿拉伯语与英语的词根与词源释义dallaa_*:埃及昵称及其音标和转写root:闪米特/科普特形态词根origin_type:历史词源层famous_figures_ar/famous_figures_en:相关埃及公众人物及简介slot1_pct~slot8_pct:世代槽位分布百分比corpus_share_pct:在埃及全部词元中的总体占比
许可与引用
该数据集基于 MIT License 发布,可自由用于学术、商业和研究用途。