PairedGTA
收藏资源简介:
PairedGTA是由圣安娜高级研究学院和比萨大学联合创建的一个用于自动驾驶视觉感知研究的合成数据集生成框架。该数据集基于GTA V游戏引擎构建,通过高保真渲染生成像素级对齐的驾驶场景图像,涵盖晴天、日落、夜间、雨天和雾天等多种光照与天气条件,每个场景在不同条件下保持完全一致的几何结构、相机姿态及动态物体身份与位置。数据集生成过程采用确定性程序化方法,首先采样虚拟世界中的位置并初始化场景,然后实例化车辆、行人等动态实体,最后在固定场景描述符下渲染不同光照条件的图像变体。该数据集专为受控的光度偏移分析而设计,旨在解决自动驾驶模型在恶劣环境下的鲁棒性评估问题,通过消除语义和几何因素的干扰,精确量化模型性能因光照变化而产生的退化。
PairedGTA is a synthetic dataset generation framework for autonomous driving visual perception research, jointly created by the Sant'Anna School of Advanced Studies and the University of Pisa. Built on the GTA V game engine, it generates pixel-aligned driving scene images via high-fidelity rendering, covering various lighting and weather conditions including clear sunny days, sunset, nighttime, rainy days and foggy days. For each scene, its geometric structure, camera pose, as well as the identities and positions of dynamic objects remain completely consistent across all different conditions. The dataset generation process adopts a deterministic procedural method: first, sample locations in the virtual world and initialize the scene; then instantiate dynamic entities such as vehicles and pedestrians; finally render image variants under different lighting conditions with a fixed scene descriptor. This dataset is specifically designed for controlled photometric shift analysis, aiming to address the robustness evaluation issue of autonomous driving models in harsh environments. By eliminating interference from semantic and geometric factors, it accurately quantifies the degradation of model performance caused by lighting changes.
数据集概述
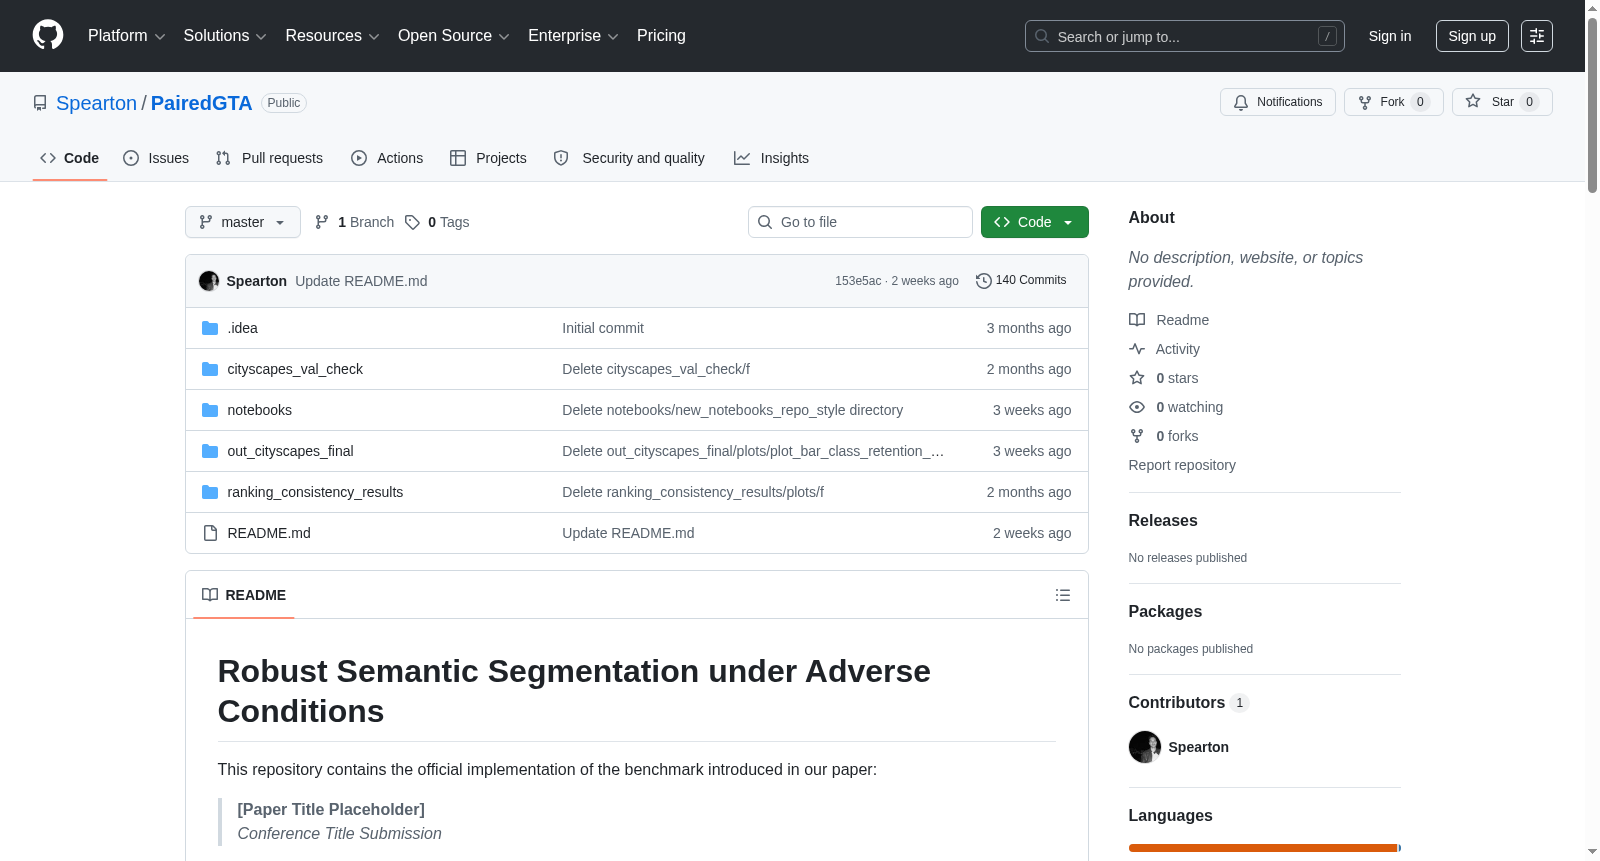
数据集名称:PairedGTA(基于 README 内容推断,地址为 https://github.com/Spearton/PairedGTA)
核心目标:评估语义分割模型在恶劣环境(如雨、雾、夜晚)下的鲁棒性,重点关注模型预测的一致性(Prediction Consistency),而非绝对精度。
关键特性
- 成对图像评估:提供清晰场景与恶劣环境(如日间-雨天、日落-有雾)的成对图像,用于对比模型预测稳定性。
- 像素级掩码一致性指标:通过计算干净和恶劣条件下像素预测一致的比例(Masked Pixel Agreement)来衡量鲁棒性。
- 类别级保留分析:评估每个语义类别在环境变化下的预测保留率(Class Retention)。
- 场景化评估:支持按特定环境切换(如 Day-Rain、Sunset-Foggy)进行细分评估。
- 定性失败案例分析:支持可视化分析模型预测失败的典型情况。
数据集结构
预期数据集目录结构如下:
Dataset/ ├── Day/ ├── Sunset/ └── Night/
- 各子目录下应包含成对的干净与恶劣条件图像(具体命名规则详见原始仓库说明)。
- 无需真实标注(Ground Truth),评估完全基于模型预测的一致性。
评估指标
- 掩码像素一致性:
Agreement = (1 / |A|) * Σ 1[p_clean == p_adv],其中 |A| 为掩码区域像素总数,p_clean 和 p_adv 分别为干净和恶劣条件下的预测类别。 - 类别保留率:
Reference-based Retention_k,针对每个类别计算干净条件下预测正确的像素在恶劣条件下仍被预测为同一类的比例。
输出结果
运行基准测试后,将生成以下 CSV 文件:
results_pixel_agreement_per_image.csv(每张图像的像素一致性)results_pixel_agreement_by_condition.csv(按条件汇总的像素一致性)results_class_retention_by_condition.csv(按条件汇总的类别保留率)framewise_target_class_counts.csv(帧级目标类别计数)framewise_target_class_spearman.csv(帧级目标类别斯皮尔曼相关系数)
所有可视化结果以 PDF 格式 导出,存放于 out_cityscapes_final/plots/ 和 ranking_consistency_results/plots/ 目录下。
使用说明
- 安装环境:创建 Python 3.9 环境,安装依赖(torch, torchvision, transformers, huggingface_hub, matplotlib, pandas, tqdm, scipy, pyyaml)。
- 运行基准测试:依次执行以下 Jupyter Notebook:
notebooks/run_benchmarks_reference_metric.ipynb(运行主基准测试)notebooks/plot_benchmarks_notebook.ipynb(生成结果图)notebooks/extract_single_segmentation.ipynb(提取单帧分割)notebooks/plot_mirror_ranking_from_csv.ipynb(生成镜像排名图)
- 模型配置:可通过修改
notebooks/benchmark_models.py添加或移除参与评估的模型。
许可证
该数据集及代码基于 SantAnna 许可证发布(具体条款请参阅原始仓库中的 LICENSE 文件)。