
遇见数据集

cstr/grundwortschatz-voc-de

收藏
Hugging Face2026-05-30 更新2026-05-31 收录
官方服务:

资源简介:

WortUniversum德语词汇数据库是一个精选且丰富的词汇数据库,包含10,450个德语词元,覆盖了德国各州小学使用的基础词汇(Grundwortschatz)。数据集提供了广泛的每词注释,包括:定义、国际音标(IPA)、屈折变化、连字符;约24,500个例句;约27,500个英文翻译;ConceptNet语义关系;OpenThesaurus/OdeNet的同义词、上位词、下位词、部分词;多语料库频率排名(HermitDave/Buchmeier/Leipzig/Leeds);DWDS频率等级(7级频带0-6);childLex年龄分级规范(1-2年级/3-4年级/5-6年级频率);双重拼写模式分类法(6类详细+5类广义);各州来源归属和各州正字法模式类别标签;以及基于维基百科的常见拼写错误对。数据集基于CC-BY-SA-4.0和GPL-3.0上游来源构建,适用于文本分类、标记分类、翻译等NLP任务,并支持德语和英语。

A curated, enriched lexical database of 10,450 German lemmas covering the primary-school Grundwortschatz (basic vocabulary) used across German Bundesländer, with extensive per-word annotation including: definitions, IPA, inflections, hyphenation; example sentences (~24,500); English translations (~27,500); ConceptNet semantic relations; OpenThesaurus / OdeNet synonyms, hypernyms, hyponyms, meronyms; multi-corpus frequency rank (HermitDave / Buchmeier / Leipzig / Leeds); DWDS Häufigkeitsklasse (7-level frequency band 0–6); childLex age-graded norms (Klasse 1-2 / 3-4 / 5-6 frequency); dual spelling-pattern taxonomies (6-cat detailed + 5-cat broad); per-Bundesland source attribution and per-Bundesland orthographic-pattern category labels; Wikipedia-derived common-misspelling pairs. The dataset is built bottom-up from CC-BY-SA-4.0 and GPL-3.0 upstream sources.
提供机构:
cstr
搜集汇总
数据集介绍
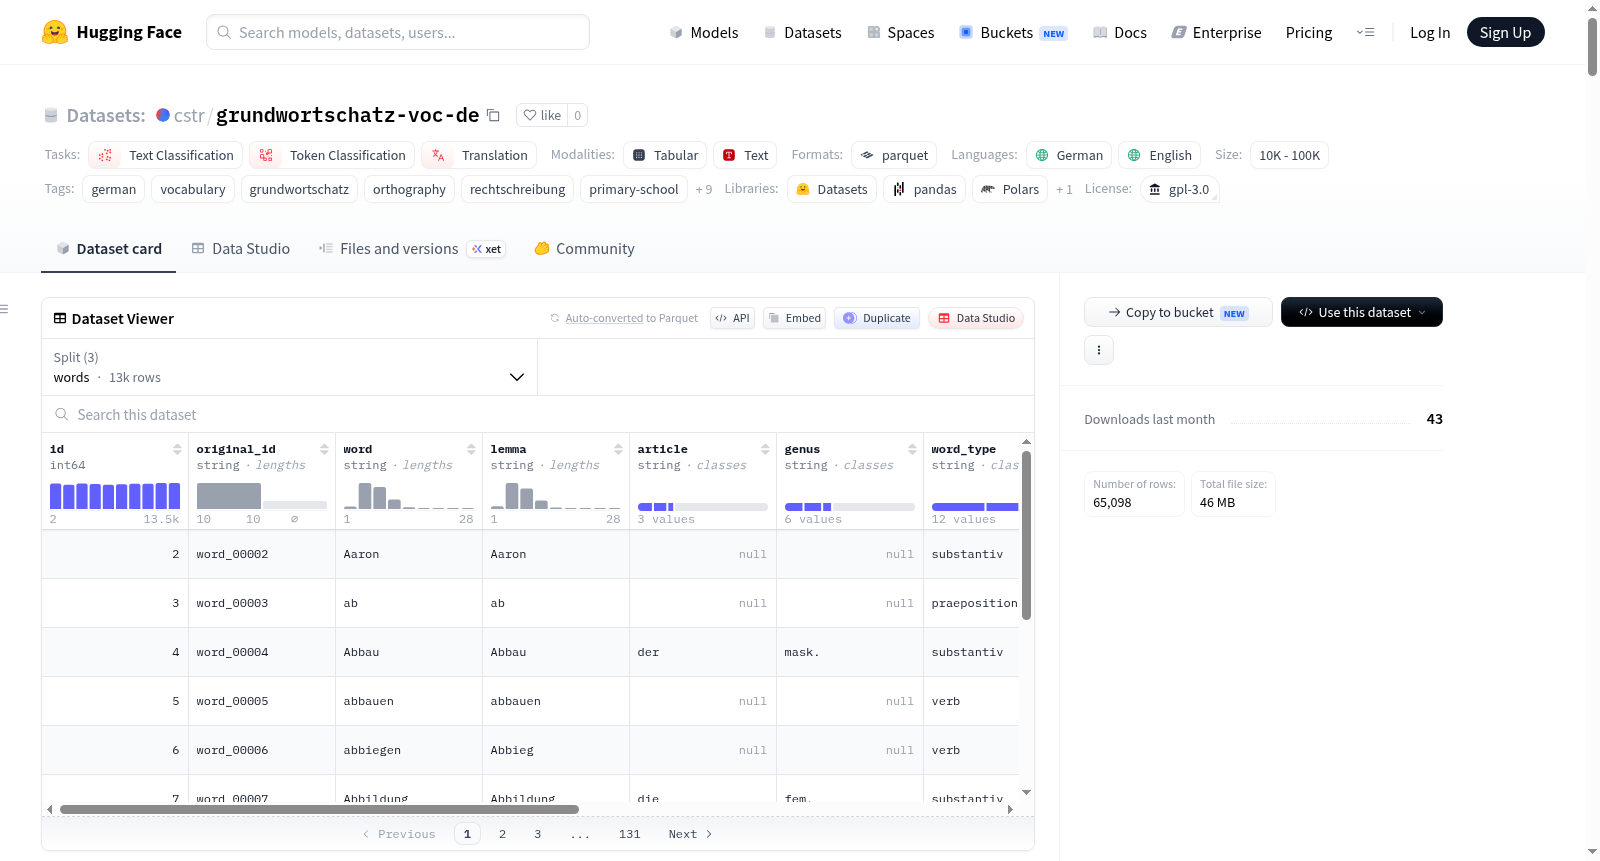
cstr/grundwortschatz-voc-de 数据集图片
构建方式
该数据集以德国小学基础词汇表(Grundwortschatz)为核心,汇聚了来自多语料库的丰富标注信息。构建过程自下而上,从德语维基词典、ConceptNet、OdeNet、OpenThesaurus、HermitDave、DWDS及childLex等多个公开资源中提取了词条的定义、国际音标、屈折变化、例句、语义关系及频率等级等数据。项目将约10,450个德语词条与各联邦州官方基础词表进行交叉整合,并通过算法为每个单词派生出拼写策略分类、年龄段频率分布及常见错误拼写对,最终以结构化SQLite数据库及Parquet格式发布。
特点
本数据集最为独特之处在于其多维度深度融合的标注体系。每一条词目不仅囊括了传统词典中的释义、发音与屈折信息,更融入了来自儿语语料库childLex的年级分级频率信号,使词汇的适龄性得以量化呈现。此外,数据集基于德语正字法原理,为单词标注了七类拼写策略标签(如双辅音、长音标记、词干恒常等),并结合各联邦州官方教学分类,为教育场景中的分级教学提供了科学依据。25,000余条德英翻译及例句进一步丰富了语料的可应用性。
使用方法
研究者可直接通过Hugging Face Datasets库加载该数据集,调用`load_dataset("cstr/grundwortschatz-voc-de")`获取包含单词、翻译与例句三个子集的Parquet版本。若需进行高性能本地查询,亦可解压附带的SQLite数据库文件(grundwortschatz.db.gz),通过标准SQL操作单词表中的词形、频率字段及元数据JSON字段。数据集内置的全文搜索索引(FTS5)支持对词目、词元及聚合翻译的快速检索,适用于构建词汇学习应用或教育类自然语言处理任务。
背景与挑战
背景概述
在自然语言处理与教育技术交叉领域,构建面向基础教育的词汇资源始终面临数据稀疏与标注不足的困境。由德国研究团队于2026年发布的WortUniversum数据集(即grundwortschatz-voc-de),以10450个德语基础词汇为核心,系统整合了多源频率统计、儿童分级语料库(childLex)以及德国各联邦州教学大纲中的正字法分类体系。该数据集的核心贡献在于将计算语言学分析与小学教育需求深度融合,不仅提供了词频等级、词性标注等传统特征,更开创性地实现了拼写策略的自动化分类与年龄段敏感的词汇分级,为低资源语种的儿童语言习得研究树立了新范式。
当前挑战
该数据集所解决的领域挑战可归纳为三点:其一,德语正字法规则复杂,传统教学依赖人工归纳拼写策略,而本数据集通过算法从词的音位、形态与正字法属性中自动推导七类拼写原则(如双辅音、延长标记等),实现了从规则到数据的可计算转换;其二,儿童词汇习得具有明确的年龄段特征,但现有资源缺乏对小学各年级文本频率的系统标注,childLex分级规范的引入填补了这一空白;其三,构建过程中需协调十四个联邦州各自独立的拼写分类体系(如巴伐利亚州的43类字素标签与石勒苏益格-荷尔斯泰因州的59类层次化标签),通过整合多源异构数据和建立兼容性更高的分类框架,有效缓解了地域性教育标准差异带来的数据碎片化问题。
常用场景
经典使用场景
在德语教学与语言习得研究中,该数据集常被用作构建基础词汇学习系统的核心资源。其涵盖的10,450个德语词元均源自德国各联邦州小学基础词汇表,并辅以多语料库频率排名、儿童年龄分级频率规范以及拼写策略分类。研究者可基于这些标注信息设计针对德语母语儿童或第二语言学习者的词汇分级训练任务,例如利用childLex年龄分级频率为不同学段定制词表,或借助拼写策略标签开发语音对应规则的可视化教学工具。数据集内嵌的24,471条例句与27,575条英语翻译,使其天然适用于生成式词汇练习与跨语言对照学习场景。
衍生相关工作
围绕该数据集的构建方法论,学界已衍生出多项关键技术成果。其拼写策略分类算法已在配套代码仓库中形成可复现的流水线,被后续研究借鉴用于其他语言的正字法规则建模。基于metadata_json中的联邦州类别标签与childLex年龄规范,有团队开发了小学德语词汇的年级归属预测模型,该模型利用各联邦州词表的交集与年龄频率衰减特征,实现了对未有官方标注词汇的自动分级。此外,enrichment_json中收录的ConceptNet语义关系与OpenThesaurus同义词网,已被集成到德语儿童用词推理能力评估系统中,用于衡量词汇深度知识的发展轨迹。这些工作共同验证了该数据集作为跨学科基础语言资源的核心价值。
数据集最近研究
最新研究方向
当前围绕德语基础词汇数据集的研究前沿,正聚焦于构建多源融合、年龄分层的教育型词汇资源,以支撑儿童读写能力的精准干预与计算语言学的细粒度分析。该数据集通过整合德国各联邦州的官方基础词表、儿童语料库的年龄分级频率、多维拼写策略分类及词法语义网络,为低龄学习者提供了从音素-字形对应到语法形态一致性的系统性导航。其突破性在于将拼写策略进行科学的七分类标注,并结合儿童发展阶段与地区教育标准,为个性化习得路径的算法建模奠定基础。这一工作不仅回应了德语正字法教学中长期存在的资源碎片化痛点,更推动了自然语言处理技术在教育公平与早期语言障碍筛查等前沿领域跨界落地。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

