tmax-sft-big
收藏资源简介:
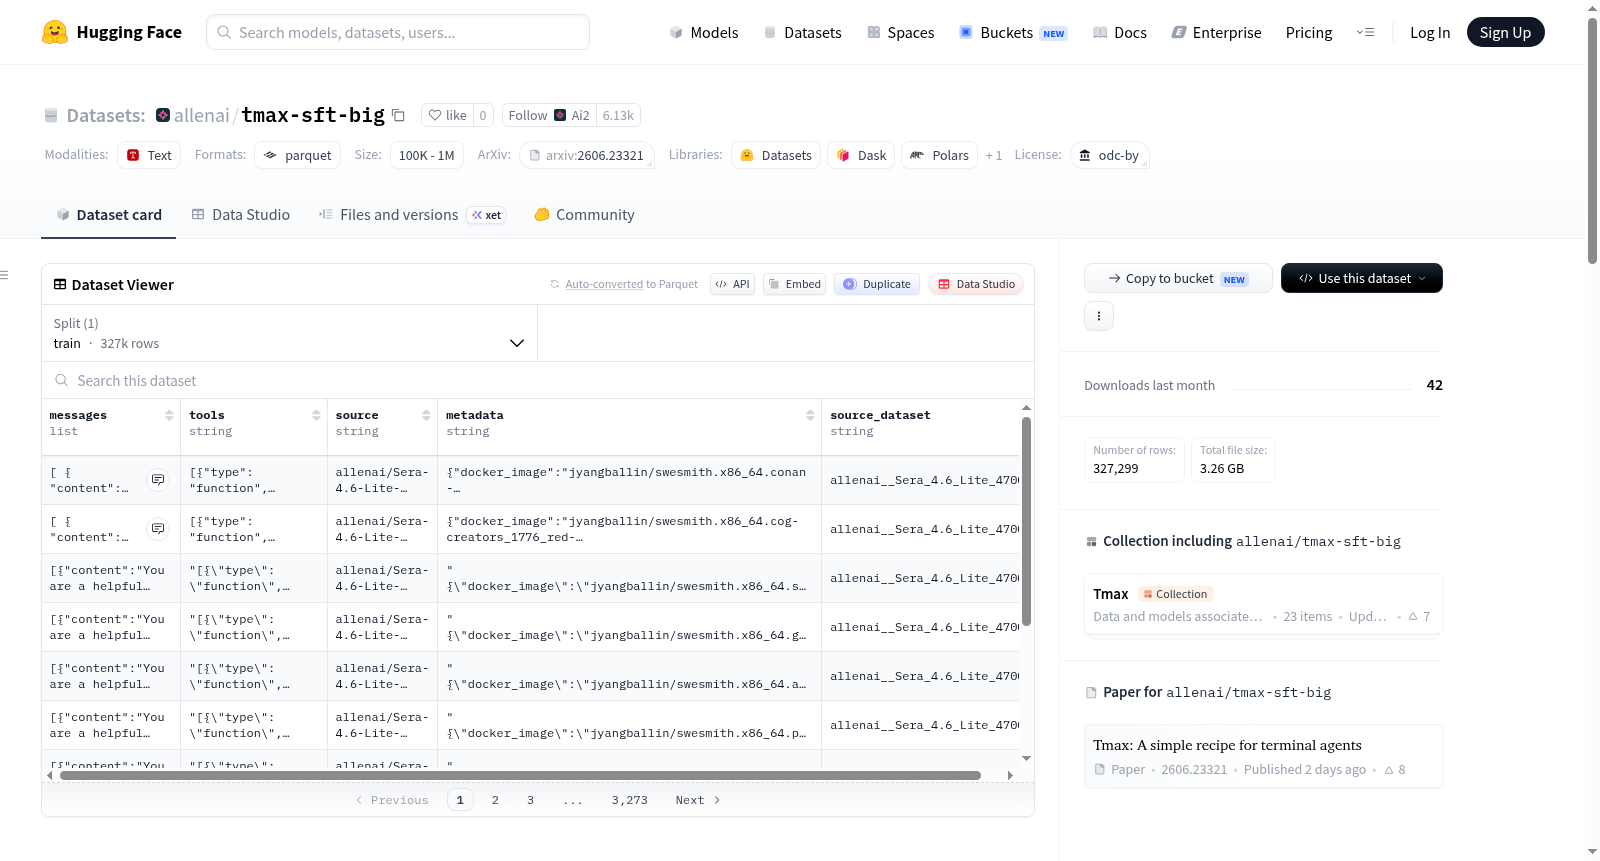
Tmax-sft-big是一个用于大语言模型监督微调(SFT)的组合数据集,由多个开源数据集合并而成,旨在支持终端代理(terminal agents)的研究与开发。数据内容来源于八个不同的子数据集,包括AllenAI的Sera-4.6-Lite-47000、m-a-p的TerminalTraj、NVIDIA的Nemotron-Terminal-Corpus(包含dataset_adapters、skill_based_easy、skill_based_medium、skill_based_mixed等多个子集)、open-thoughts的OpenThoughts-Agent-v1-SFT以及skill_tax_20260505_2.2k_combined_balanced_thinking_all。数据集总计包含约327,299个样本,每个样本都包含一个source_dataset字段,用于标识其原始来源子集。该数据集在Tmax相关论文中被用于大规模SFT实验,采用ODC-BY许可,适用于研究和教育用途,并遵循Ai2的负责任使用指南。部分数据由Gemini 3.1 Pro生成,使用时需同时遵守Google的服务条款。建议用户参考各原始数据集的许可条款。
Tmax-sft-big is a combined dataset for supervised fine-tuning (SFT) of large language models, created by merging multiple open-source datasets. It aims to support research and development of terminal agents. The data is sourced from eight different sub-datasets, including AllenAIs Sera-4.6-Lite-47000, m-a-ps TerminalTraj, NVIDIAs Nemotron-Terminal-Corpus (which includes subsets like dataset_adapters, skill_based_easy, skill_based_medium, skill_based_mixed), open-thoughts OpenThoughts-Agent-v1-SFT, and skill_tax_20260505_2.2k_combined_balanced_thinking_all. The dataset contains approximately 327,299 samples in total, with each sample including a source_dataset field to identify its original source subset. It has been used in Tmax-related papers for large-scale SFT experiments. The dataset is licensed under ODC-BY, suitable for research and educational purposes, and follows Ai2s responsible use guidelines. Some data is generated by Gemini 3.1 Pro, and users must comply with Googles terms of service when using it. It is recommended that users also refer to the license terms of the original datasets.
数据集概述
Tmax-sft-big 是一个组合式监督微调(SFT)数据集,由多个来源的数据集合并而成,用于论文中的“大型SFT”实验。该数据集由 Allen AI 发布。
- 许可证:ODC-BY
- 用途:面向研究和教育用途,符合 Ai2 的负责任使用指南。
- 数据内容:每条数据包含一个
source_dataset字段,用于标识其原始来源子集。 - 论文 & 资源:相关论文可在 arXiv 上获取,代码、模型、数据及博客文章均有对应链接。
数据来源
该数据集由以下8个子数据集组成:
| 来源数据集 | 样本数 | 原始链接 |
|---|---|---|
allenai__Sera_4.6_Lite_47000 |
47,464 | allenai/Sera-4.6-Lite-47000 |
m_a_p__TerminalTraj |
16,748 | m-a-p/TerminalTraj |
nvidia__Nemotron_Terminal_Corpus__dataset_adapters |
179,888 | nvidia/Nemotron-Terminal-Corpus: dataset_adapters |
nvidia__Nemotron_Terminal_Corpus__skill_based_easy |
35,208 | nvidia/Nemotron-Terminal-Corpus: skill_based_easy |
nvidia__Nemotron_Terminal_Corpus__skill_based_medium |
22,037 | nvidia/Nemotron-Terminal-Corpus: skill_based_medium |
nvidia__Nemotron_Terminal_Corpus__skill_based_mixed |
741 | nvidia/Nemotron-Terminal-Corpus: skill_based_mixed |
open_thoughts__OpenThoughts_Agent_v1_SFT |
8,717 | open-thoughts/OpenThoughts-Agent-v1-SFT |
skill_tax_20260505_2.2k_combined_balanced_thinking_all |
16,496 | source config in osieosie/tmax-sft-full-20260513 |
总计样本数:约 327,399 条。
使用许可
- 数据集本身采用 ODC-BY 许可证。
- 数据中包含使用 Gemini 3.1 Pro 生成的输出,受 Google 服务条款约束。
- 每个原始子数据集请参考其自身的许可证。
引用信息
若使用该模型或数据,请引用以下论文:
bibtex @misc{ivison2026tmaxsimplerecipeterminal, title={Tmax: A simple recipe for terminal agents}, author={Hamish Ivison and Junjie Oscar Yin and Rulin Shao and Teng Xiao and Nathan Lambert and Hannaneh Hajishirzi}, year={2026}, eprint={2606.23321}, archivePrefix={arXiv}, primaryClass={cs.CL}, url={https://arxiv.org/abs/2606.23321}, }