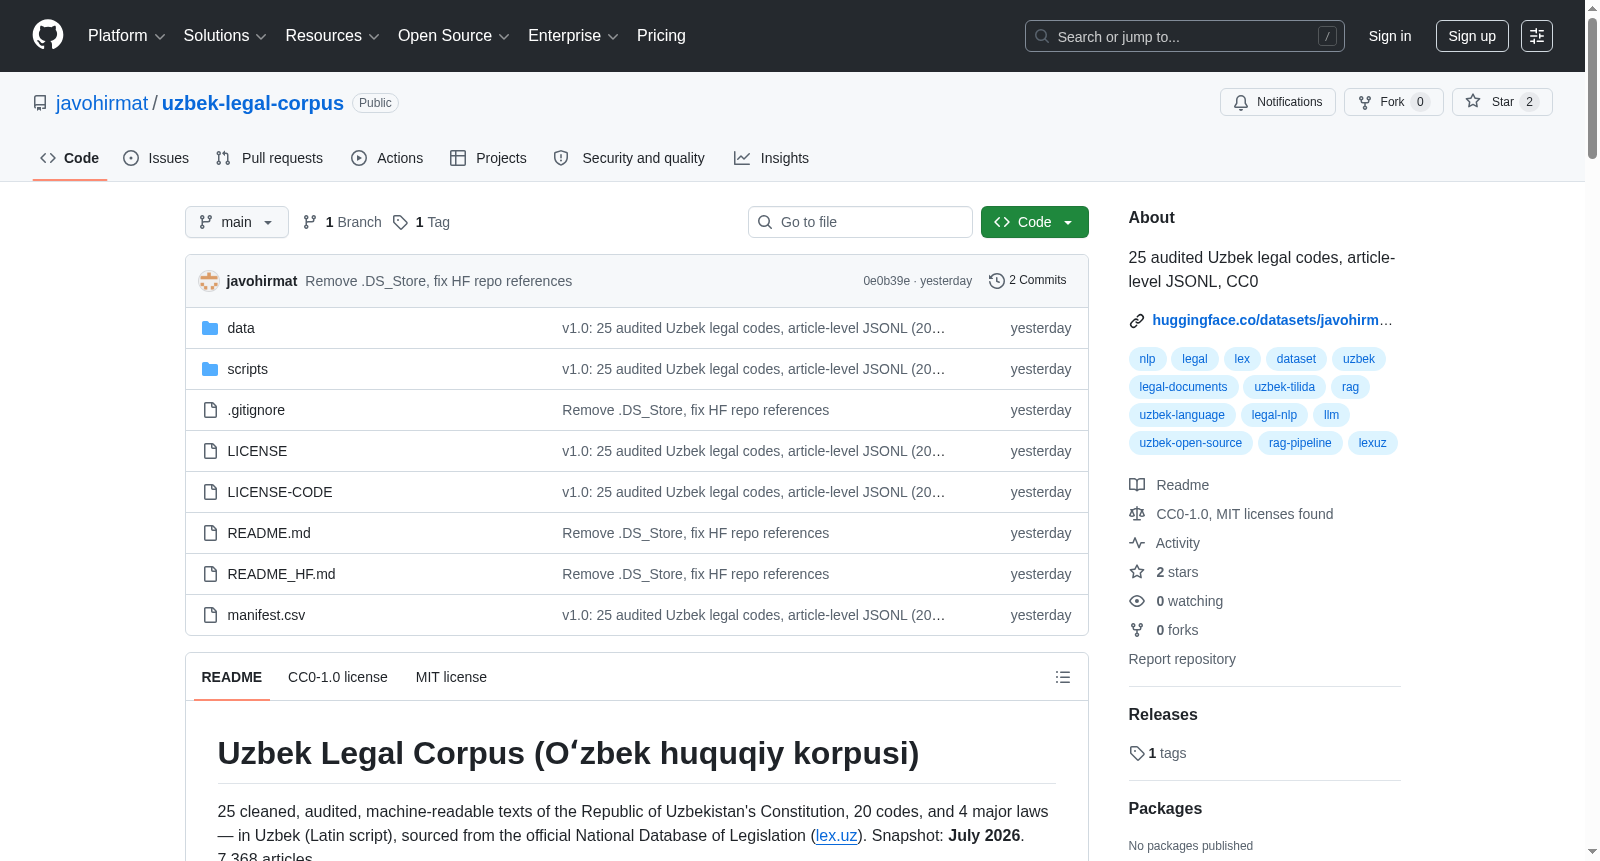
Uzbek Legal Corpus (Oʻzbek huquqiy korpusi)
收藏资源简介:
25个经过清理、审核、机器可读的乌兹别克斯坦共和国宪法、20部法典和4部主要法律的文本,采用乌兹别克语(拉丁字母),源自官方国家立法数据库(lex.uz)。快照日期:2026年7月。包含7,368篇文章。专为乌兹别克法律文本的NLP / LLM / RAG工作而构建。由Tomaris AI发布。
25 cleaned, reviewed, and machine-readable texts consisting of the Constitution of the Republic of Uzbekistan, 20 codes, and 4 major national laws, all written in Uzbek (Latin script). The dataset is sourced from the official national legislative database lex.uz, with a snapshot date of July 2026. It contains 7,368 articles, and is specifically developed for NLP, LLM, and RAG tasks focused on Uzbek legal texts. Released by Tomaris AI.
数据集概述:Uzbek Legal Corpus (Oʻzbek huquqiy korpusi)
该数据集是一个乌兹别克语法律文本语料库,由 Tomaris AI 发布,数据来源于乌兹别克斯坦国家立法数据库(lex.uz)。数据快照时间为 2026年7月,共包含 7,368 个条文。
1. 数据集内容
数据集涵盖乌兹别克斯坦共和国宪法、20 部法典及 4 部主要法律,均采用乌兹别克语(拉丁字母)文本。具体包含以下文件与结构:
data/raw/*.txt:清洗后的纯文本文件,每部法典/法律对应一个文件。data/articles/*.jsonl:按条文拆分的 JSON 记录,每行代表一条结构化数据。manifest.csv:文件清单,包含官方标题、lex.uz 文档 ID、通过日期、条文数量、最后一条条文、SHA-256 哈希及快照日期。scripts/clean.py:文本规范化处理流程(从 lex.uz 原始文本转为清洗后的纯文本)。scripts/parse_articles.py:将清洗后的纯文本解析为 JSONL 格式并生成清单。
2. JSONL 数据模式
每条 JSON 记录包含以下字段:
seq:条文在文档中的序列号。code:法典或法律的内部标识符。code_title:官方标题(乌兹别克语)。article_id:条文标准 ID(如480.1,表示插入的第 480¹ 条)。article_display:显示用的条文编号(如480¹-modda)。article_raw:原始文本中的条文编号(如4801-modda,数字扁平化形式)。kind:条文类型(如insert表示插入条文)。title:条文名称。section:所属部分(如XXI BOʻLIM. ...)。chapter:所属章节(如71¹-bob. ...)。text:条文正文内容。lex_uz_doc:lex.uz 上的文档标识符。snapshot_date:数据快照日期。
特殊记录:
article_id: "_front":序言或开篇内容(如宪法的 “Muqaddima”)。article_id: "_end":尾部材料(如刑法中的法律术语词汇表)。
3. 重要约定与规范
- 编码标准:所有文本中的撇号统一使用 Unicode 字符。
oʻ/gʻ中的撇号为 U+02BB (ʻ),maʼlumot中的撇号为 U+02BC (ʼ),严格一致,不得修改。 - 上标条文处理:原始文本中插入条文的上标数字被扁平化(如
480¹变为4801),而 JSONL 中的article_id已根据文档位置解析为正确的规范形式(如480.1)。 - 废除条文处理:文本中存在的编号空缺(gap)对应已被废除的条文,并非数据缺失。所有空缺已对照 lex.uz 及合并版本进行核实。
- 保留与移除内容:
- 保留:全部法律正文,包括行内法律引用、废除条文清单、刑法词汇表及过渡性条款。
- 移除:lex.uz 的修订注释(括号内的公报引用)、导航/界面冗余内容、BOM 标记及控制字符。
- 解析提示:解析自行编写的
-modda模式时,应匹配d+s*-s*modda的正则形式,而非严格格式(原始文本偶尔出现599- modda)。
4. 数据来源与时效性
- 来源:数据来自乌兹别克斯坦国家立法数据库(lex.uz)的合并版本,快照时间为 2026 年 7 月。
- 覆盖版本:包括 2022 年的新《劳动法典》(Mehnat kodeksi)、2025 年的《水法典》(Suv kodeksi,2025 年 10 月 31 日生效)、2023 年的《竞争法》(Raqobat qonuni)及 2023 年宪法。1993 年的《航空法典》(Havo kodeksi)仍有效(截至快照时,新的 ICAO 协调版本正在起草中)。
- 法律声明:此为研究和机器学习目的的非官方副本。法律文本会不断更新,lex.uz 是唯一权威来源。
5. 法律状态与许可
- 法律文本:根据乌兹别克斯坦版权法(OʻRQ-42, 2006.07.20, 第 8 条),官方文件(法律、决议等)及其官方翻译不受版权保护。因此,法律文本本身属于公共领域。
- 数据(
data/,manifest.csv):采用 CC0 1.0 许可协议(LICENSE),不对数据集编译和清洗主张任何权利。 - 代码(
scripts/):采用 MIT 许可协议(LICENSE-CODE)。 - 建议(非必须)引用时注明 lex.uz 并附上此仓库链接。
6. 数据统计
| 法典/法律名称 | 内部标识符 | 条文数 | 词数 |
|---|---|---|---|
| 宪法 | konstitutsiya | 155 | 10,563 |
| 劳动法典 | mehnat_kodeksi | 581 | 80,270 |
| 水法典 | suv_kodeksi | 165 | 26,338 |
| 选举法典 | saylov_kodeksi | 110 | 14,857 |
| 城市规划法典 | shaharsozlik_kodeksi | 85 | 14,059 |
| 竞争法 | raqobat_qonuni | 49 | 11,248 |
| 投资活动法 | investitsiyalar_faoliyati_qonuni | 69 | 8,643 |
| 有价证券市场法 | qimmatli_qogozlar_bozori_qonuni | 65 | 10,262 |
| 中央银行法 | markaziy_bank_qonuni | 76 | 8,956 |
| 税务法典 | soliq_kodeksi | 496 | 149,577 |
| 民法典(第一部分) | fuqarolik_kodeksi_1qism | 386 | 34,255 |
| 民法典(第二部分) | fuqarolik_kodeksi_2qism | 811 | 76,905 |
| 民事诉讼法典 | fuqarolik_protsessual_kodeksi | 508 | 53,736 |
| 刑法典 | jinoyat_kodeksi | 392 | 53,498 |
| 刑事诉讼法典 | jinoyat_protsessual_kodeksi | 762 | 101,971 |
| 刑事执行法典 | jinoyat-ijroiya_kodeksi | 196 | 18,384 |
| 行政责任法典 | mamuriy_javobgarlik_kodeksi | 660 | 76,664 |
| 行政诉讼法典 | mamuriy_sud_ishlarni_yuritish_kodeksi | 306 | 34,286 |
| 经济诉讼法典 | iqtisodiy_protsessual_kodeksi | 385 | 49,133 |
| 预算法典 | budjet_kodeksi | 172 | 24,903 |
| 海关法典 | bojxona_kodeksi | 419 | 59,190 |
| 家庭法典 | oila_kodeksi | 220 | 17,486 |
| 土地法典 | yer_kodeksi | 110 | 18,300 |
| 航空法典 | havo_kodeksi | 136 | 11,367 |
| 商业活动法 | tadbirkorlik_faoliyati_qonuni | 54 | 6,455 |
| 总计 | 7,368 | 971,306 |
词数统计涵盖条文标题和正文(不包括序言和尾部材料)。根据分词器不同,每个乌兹别克语单词大约对应 2.5–3.5 个 token。
7. 如何加载
python from datasets import load_dataset ds = load_dataset("javohirmat/uzbek-legal-corpus", data_files="data/articles/*.jsonl", split="train")
8. 更新说明
此数据集为快照版本(2026-07),不与 lex.uz 持续同步。法律会变化,lex.uz 是唯一权威来源。
9. 引用方式
Uzbek Legal Corpus (2026-07 snapshot). Tomaris AI. Source texts: Qonunchilik maʼlumotlari milliy bazasi (lex.uz).
bibtex @misc{uzbek_legal_corpus_2026, title = {Uzbek Legal Corpus (2026-07 snapshot)}, author = {{Tomaris AI}}, year = {2026}, note = {Source texts: Qonunchilik malumotlari milliy bazasi (lex.uz)}, url = {https://huggingface.co/datasets/javohirmat/uzbek-legal-corpus} }