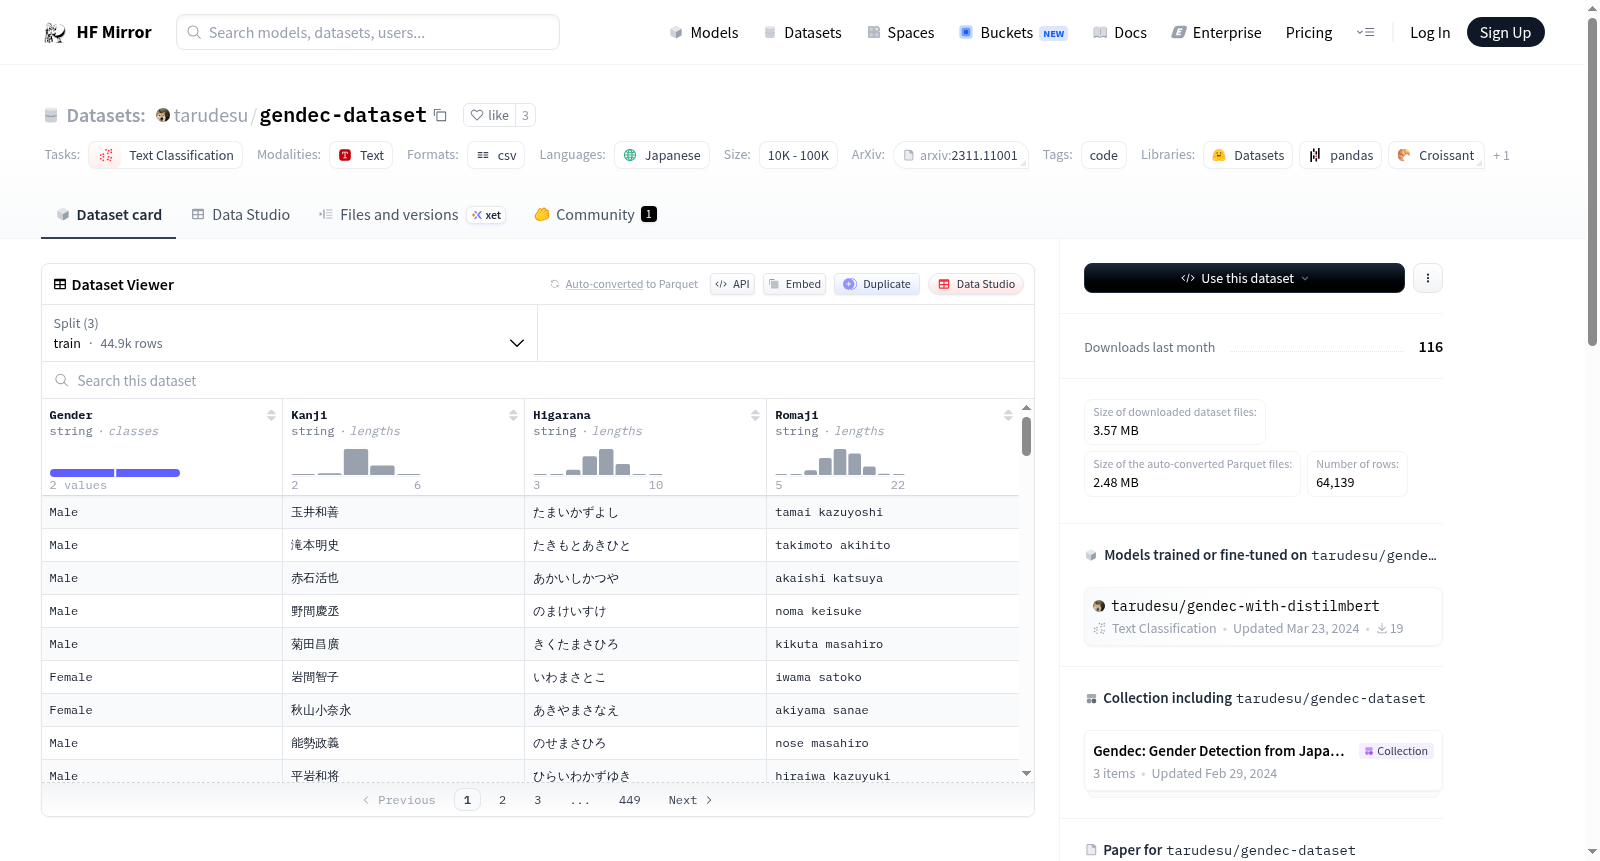
tarudesu/gendec-dataset
收藏资源简介:
Gendec数据集包含64,139个日本名字及其生物性别,这些名字以罗马字、平假名和汉字三种形式呈现。数据集分为三部分:训练集(44.9K行)、验证集(6.41行)和测试集(12.8行)。该数据集旨在通过分析名字来检测性别,从而揭示语言模式和文化规范,应用于实际场景中。
The Gendec dataset comprises 64,139 Japanese names paired with their corresponding biological genders, available in three formats: romaji (Romanized), hiragana, and kanji. The dataset is split into three subsets: a training set (44.9K rows), a validation set (6.41K rows), and a test set (12.8K rows). This dataset is designed for gender detection via name analysis, thereby revealing linguistic patterns and cultural norms, with practical real-world applications.
数据集概述
基本信息
- 任务类别: 文本分类
- 语言: 日语
- 标签: code
- 数据集名称: Japanese Gender Detection Based on Names Dataset
- 数据集大小: 10K<n<100K
- 数据集标识: tarudesu/gendec-dataset
- 评估指标: F1
- 库名称: transformers
数据集描述
- 数据集内容: 包含64,139个日本名字及其生物性别,名字形式包括罗马字、平假名和汉字。
- 数据集划分:
- 训练集: 44,900行
- 验证集: 6,410行
- 测试集: 12,800行
引用信息
@misc{pham2023gendec, title={Gendec: A Machine Learning-based Framework for Gender Detection from Japanese Names}, author={Duong Tien Pham and Luan Thanh Nguyen}, year={2023}, eprint={2311.11001}, archivePrefix={arXiv}, primaryClass={cs.CL} }